成立不久的AI语音公司Sesame近期完成超2亿美元融资,由红杉资本等顶级机构押注,迅速跻身AI语音赛道创投榜第二位。该公司正打造颠覆性语音助手Maya和Miles,并计划将其集成至轻便智能眼镜,试图突破人机交互边界。随着资本与技术的双重加码,一场AI语音行业的洗牌大战或已悄然打响。Sesame是一家专注于开发自然对话的语音伙伴及相关设备的初创公司,由 Brendan Iribe(Oculus 联合创始人兼前 CEO)、Ankit Kumar(前 Ubiquity6 首席技术官兼联合创始人)、Ryan Brown(前 Meta Reality Labs 研究工程总监)等创意人才领导。
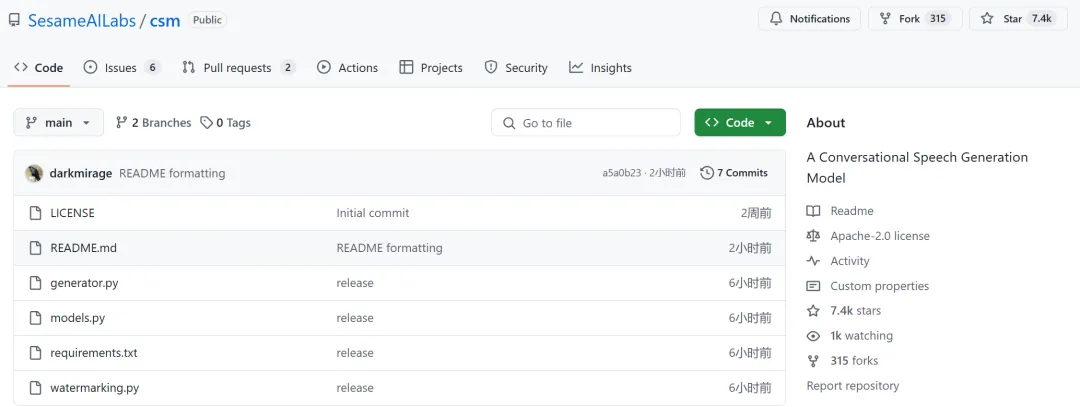
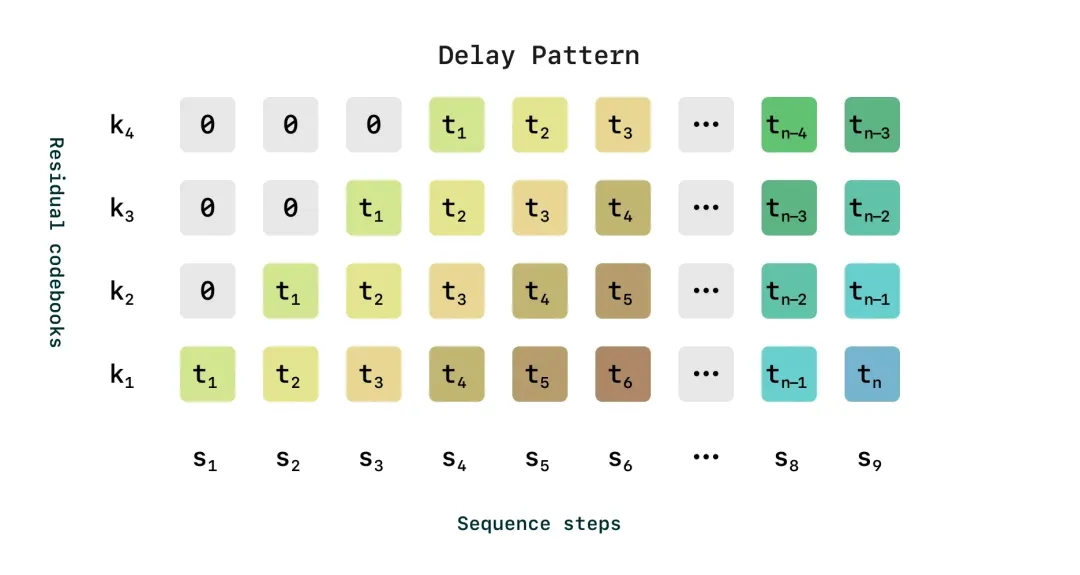
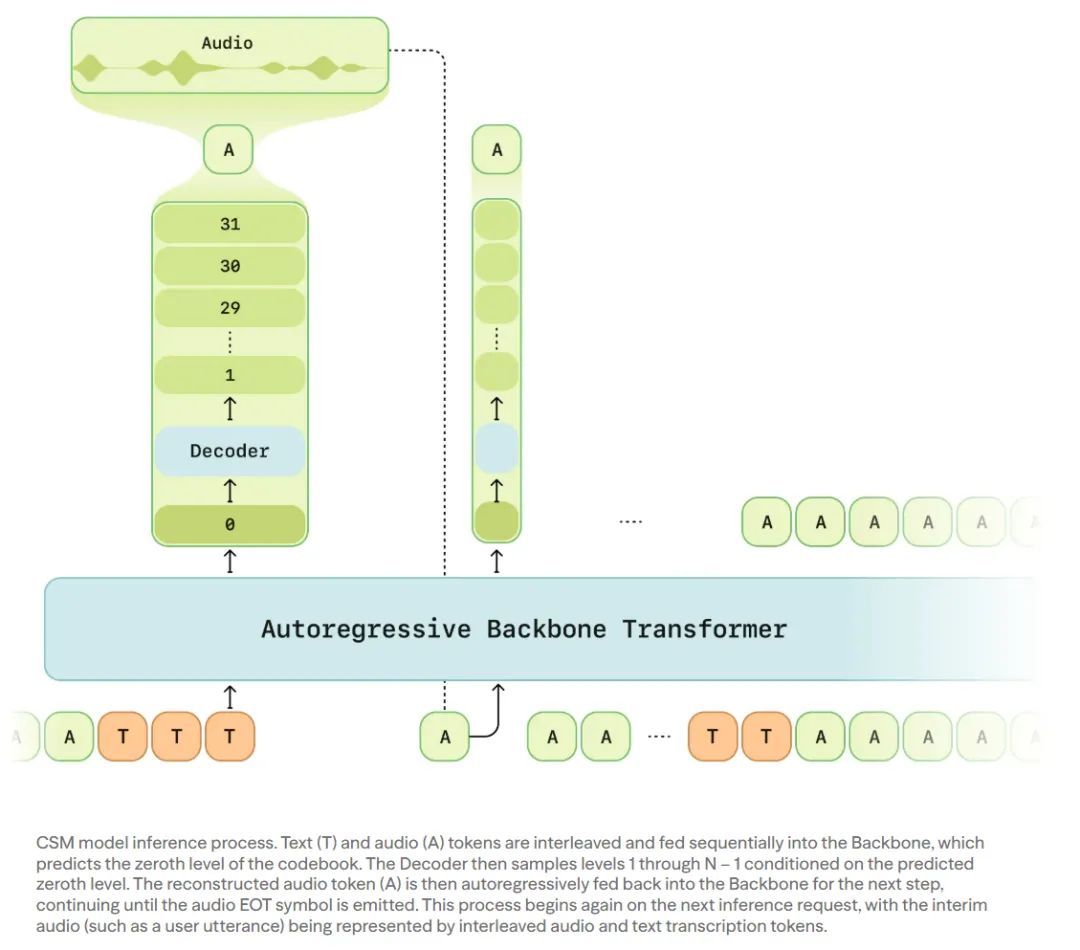
公司采用跨学科方法,结合硬件、软件和机器学习技术,确保语音界面既实用又令人愉悦。其研究团队在语音生成、个性化建模和多模态技术领域积极创新,并依托大规模 GPU 集群和专业训练评估体系支持研发工作。Sesame 发布的逼真语音助手 Maya,通过情感智能、上下文记忆和高保真语音生成技术,成功跨越了语音恐怖谷,使语音交互更加自然、情感丰富。上个月,Sesame 开源了驱动 Maya 的基础模型 CSM-1B(Conversational Speech Model)。Sesame 开源了驱动 Maya 的基础模型 CSM-1B(Conversational Speech Model)。该模型拥有 10 亿参数规模,并且采用了 Apache 2.0 许可证,这意味着它可以在几乎没有限制的情况下用于商业用途。CSM-1B 可以从文本和音频输入中生成「RVQ 音频编码」。可能大家都很好奇什么是 RVQ(Residual Vector Quantization),简单来讲就是一种将音频编码为离散 token 的技术。这种技术已经被应用于多种 AI 音频研究中,包括各种大厂都在采用,如 Google 的 SoundStream(一款用于收听播客、有声读物和广播节目的应用程序)和 Meta 的 Encodec。CSM-1B 使用了 Meta 研发的 Llama 系列模型作为其骨干架构,并搭配了一个音频解码器组件。Sesame 表示,Maya 的精细微调版本正是基于 CSM。Sesame 还提到:在 Hugging Face 和 GitHub 上开源的模型是一个基础生成模型,能够产生多种声音,但尚未针对任何特定声音进行精细微调…… 该模型因训练数据中的数据污染,对非英语语言有一定的能力,但表现可能不佳。Sesame透露,其语音助手未来将直接嵌入智能眼镜,使用户无需依赖手机即可实现自然对话。这一战略与Meta此前联手Ray-Ban推出的AI眼镜方案高度相似,但目前Sesame尚未公布具体的硬件合作伙伴。若成功落地,该技术或将成为Meta在AI可穿戴领域的有力竞争者。  语音小管家