
 语音小管家
最近,西工大音频语音与语言处理研究组与喜马拉雅珠峰实验室合作的论文 “MUSA: Multi-lingual Speaker Anonymization via Serial Disentanglement” 被语音领域顶级期刊IEEETransactions on Audio, Speech and Language Processing (TASLP)录用,该论文针对上述问题开展了深入研究,本文提出了一种新颖的基于串行解耦的说话人匿名化框架,名为MUSA,旨在实现多语种说话人匿名化。现对该论文进行简要的解读和分享。
论文题目:MUSA: Multi-lingual Speaker Anonymization via Serial Disentanglement
作者列表:姚继珣,王晴,郭鹏程,宁子谦,杨宇光,潘宇,谢磊
合作单位:喜马拉雅
论文原文:https://arxiv.org/pdf/2407.11629
随着社交媒体、语音支付等应用的普及,海量语音数据被集中存储,但其蕴含的个人身份信息(如年龄、健康状况等)极易被恶意攻击者通过语音属性识别系统窃取[1]。欧盟《通用数据保护条例》(GDPR)等法规的出台,进一步强化了对个人隐私保护的要求[2],推动了对高效语音匿名化技术的需求。然而,现有主流方法(如基于神经语音转换的匿名化框架)存在显著局限[3-5]。多数研究集中于英语,依赖语言相关的语音识别(ASR)或说话人识别(ASV)模型提取内容或身份特征,导致跨语言泛化能力差。同时,现有方法通过并行解耦策略(如同时分离内容、身份、韵律)需依赖先验知识(如ASR模型),引入强归纳偏置,导致模型难以适应多语言差异,如图1所示。此外,生成伪说话人身份需依赖外部说话人向量池,需计算距离度量并选择候选向量,流程复杂且易引入身份残留风险。
理想的多语言匿名化系统需满足两项核心需求:多语言语音的声学特征(如音调、节奏)差异显著,传统方法在解耦时易混淆语言相关特征与说话人身份,导致匿名化后语音内容失真。现有方法依赖复杂的身份替换流程(如伪身份生成),增加了计算与存储开销,且难以保障跨语言一致性。例如,基于向量池的方法需存储大量候选说话人特征,在多语言场景下易出现特征冲突或冗余。
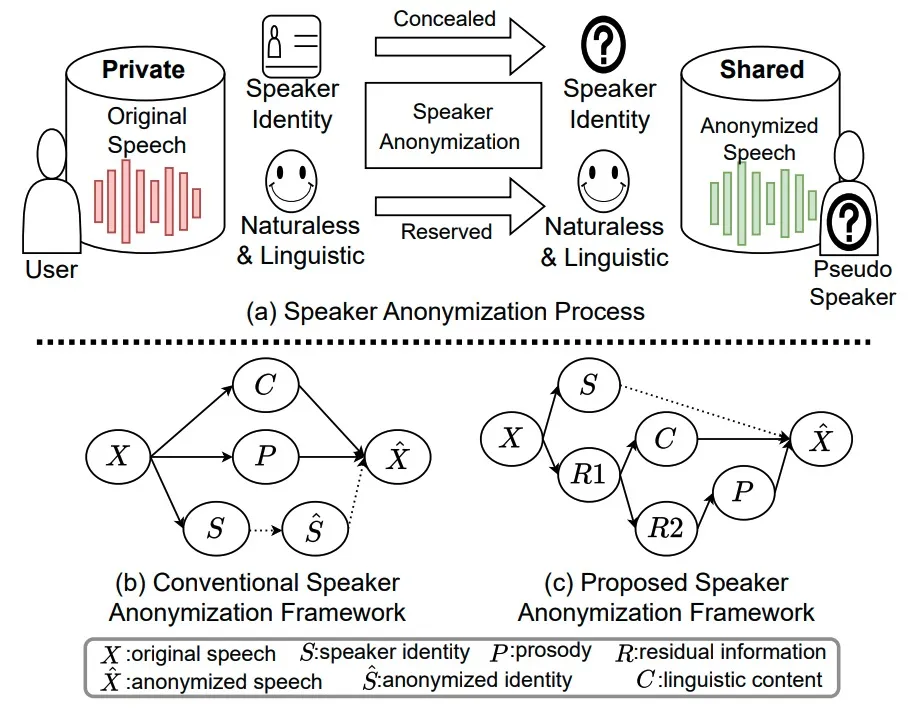
图1 说话人匿名化流程以及解耦框架对比
本文提出了一种多语种说话人匿名化框架MUSA,通过序列解耦策略和空嵌入技术实现多语言场景下的高效隐私保护。其核心贡献包括:(1)提出支持多语言及未见语言的自适应匿名化方法。通过逐步从全局时不变特征(说话人身份)到时序时变特征(语言内容与韵律)的序列解耦,结合语义蒸馏和自监督说话人蒸馏,避免了传统并行解耦对先验模型(如ASR)的依赖,显著提升了跨语言泛化能力。(2)提出简化匿名化流程的空嵌入策略,用零值嵌入直接替换说话人身份,省去伪身份生成和外部说话人向量池的使用,在降低复杂性的同时避免引入无关说话人信息,更好地保留语音的自然性和独特性。(3)设计两种蒸馏机制(语义蒸馏与说话人蒸馏),通过量化语义教师模型(XLS-R)和自监督一致性约束,确保解耦的彻底性,防止说话人信息泄露至语言内容或韵律中,并通过实验验证其在多语言和未见语言场景下的有效性。
MUSA采用基于自编码器的架构,通过序列解耦策略逐步分离语音中的全局说话人身份特征与时间相关的语言内容及韵律特征。如图2(a)所示,模型由语音编码器(speech encoder)、说话人编码器(speaker encoder)、解码器(decoder)及残差瓶颈模块(residual bottleneck module)构成。语音编码器首先将原始波形转换为帧级语音表示,其结构包含四个卷积块与LSTM层,通过下采样操作降低计算复杂度并捕获局部时频特征。说话人编码器则对语音的梅尔频谱进行全局平均池化,生成时不变的说话人身份嵌入,该过程通过自监督的片段一致性损失与基于分类器的身份损失进行优化,确保同一说话人不同语音片段的一致性及身份标签的显式对齐。
语音编码器:包含4个卷积块(含残差单元和下采样层)和两层LSTM,将语音波形转换为帧级特征表示(维度为d×t)。捕捉语音的全局信息(如说话人身份)和时序信息(如语言内容、韵律)。
说话人编码器:输入语音频谱图,输出全局时不变说话人身份表征(s∈Rd),通过平均池化获得。
残差瓶颈模块:8个级联的向量量化层(VQ层)组成,通过残差连接逐步分离语言内容与韵律。第一层量化语言内容,后续层补充韵律信息。
解码器(Decoder):结构与编码器对称的转置卷积层,将解耦后的特征重构为语音波形。
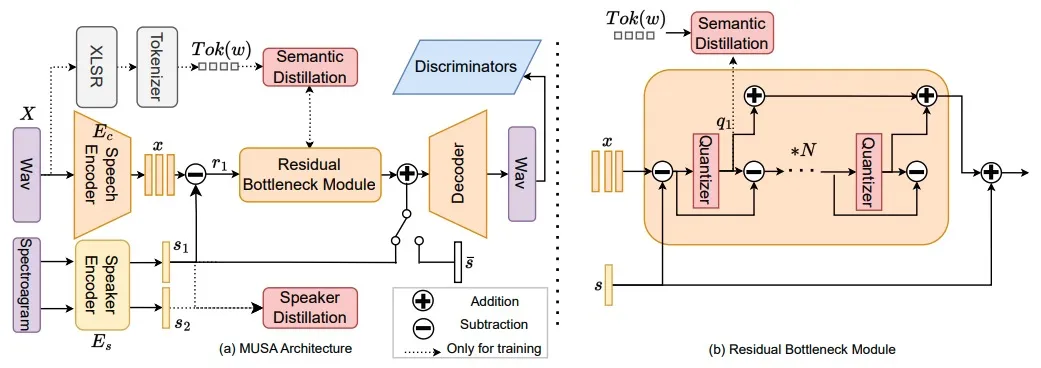
图2 MUSA匿名化框架
残差瓶颈模块采用分层向量量化(Vector Quantization, VQ)结构,通过8个级联的量化器逐步解耦语音内容与韵律信息。首层量化器通过语义蒸馏约束,利用预训练的XLS-R模型最后一层特征作为语义教师信号,通过神经编解码器(neural codec)量化生成离散标记,迫使首层量化器聚焦于语言内容建模。后续量化器则以残差形式补充韵律信息,其输出与说话人嵌入拼接后输入解码器重构原始波形。训练过程中,模型综合重构损失(时域L1损失与梅尔谱L1/L2损失)、对抗损失(多尺度STFT、多周期及多尺度判别器)、特征匹配损失、VQ约束损失及两类蒸馏损失,通过AdamW优化器进行端到端优化。
匿名化流程通过替换说话人编码器生成的嵌入为零值空嵌入实现。具体而言,解码器在重构过程中仅依赖语言内容与韵律信息,而说话人身份信息被完全抑制。此策略避免了传统方法生成伪说话人身份所需的复杂候选池搜索与距离计算,显著降低系统复杂度。此外,通过调节原始说话人嵌入与空嵌入的线性混合系数,可灵活控制匿名化程度,在隐私保护与语音自然度之间实现动态权衡。实验表明,该设计在多语言及未见语言场景下均能有效平衡身份隐匿与内容保真,且无需依赖预训练的ASR或说话人验证模型,展现出优越的泛化能力。
英语场景下的匿名化性能评估
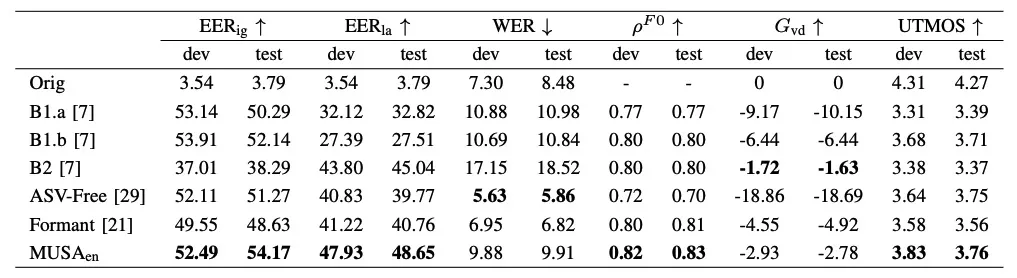
如表1所示,与VPC官方基线(B1.a、B1.b、B2)及主流的说话人匿名化方法(ASV-Free、Formant)相比,MUSAen在隐私保护和语音质量上表现最优。Ignorant场景:测试集EER为54.17%,优于所有基线(如ASV-Free的51.27%、Formant的48.63%)。Lazy-informed场景:测试集EER为48.65%,仅下降约5%,显著优于B1.a(32.82%)和B1.b(27.51%),表明对攻击者系统知识的鲁棒性。测试集WER为9.91%,优于B1.a(10.98%)和B2(18.52%),接近原始语音(8.48%),显示对语言内容的保留能力。在韵律保留方面,测试集ρF0为0.83,显著高于基线(如B1.a的0.77、ASV-Free的0.70)。语音独特性(Gvd)上表现同样出色,Gvd为-2.78 dB,优于ASV-Free(-18.69 dB),接近B2(-1.63 dB),表明MUSAen在隐藏身份的同时保留了说话人间的独特性。测试集UTMOS为3.76,高于所有基线(如B1.a的3.39、Formant的3.56),接近原始语音(4.27)。
表1 英文数据集上匿名化对比结果
相似性矩阵显示MUSAen的匿名化语音(Maa)保留了清晰的“对角线主导”模式(如图3),表明语音独特性未被破坏,而ASV-Free的Maa对角线消失(独特性严重退化)。
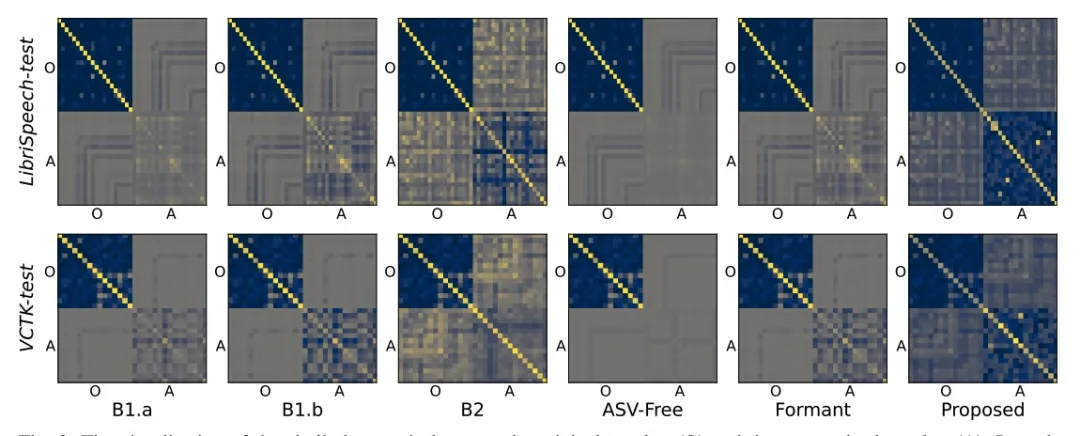
图3 说话人可区分性实验结果
多语言场景下的匿名化性能
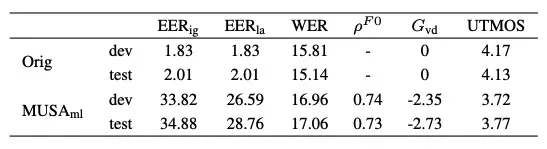
如表2所示,在隐私保护方面,Ignorant场景测试集EER为34.88%,Lazy-informed场景为28.76%,显著高于原始语音(2.01%)。测试集WER为17.06%,仅比原始语音(15.14%)高1.92%,表明多语言内容保留良好。其他指标上ρF0=0.73、Gvd=-2.73 dB、UTMOS=3.77,均满足隐私与质量要求,证明方法在多语言场景的有效性。
表2 多语种数据集上匿名化对比结果
未见语言(中文普通话)的泛化能力
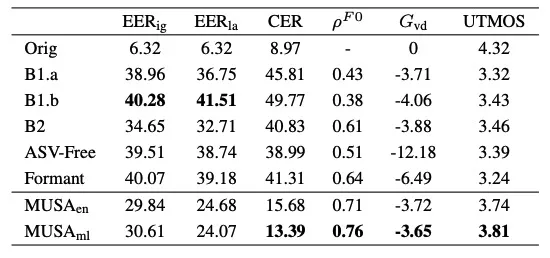
使用AISHELL-3中文数据集评估MUSAen和MUSAml:MUSAen在Ignorant场景EER为29.84%,MUSAml为30.61%,显著高于基线(如B1.a的38.96%、ASV-Free的39.51%)。MUSAen的CER为15.68%,MUSAml为13.39%,远低于基线(如B1.a的45.81%、ASV-Free的38.99%),接近原始语音(8.97%)。基线依赖英语训练的ASR模型,导致中文CER极高(40%+),而MUSA通过序列解耦避免了语言依赖,实现跨语言内容保留。
表3 未见语种上匿名化结果
消融实验分析
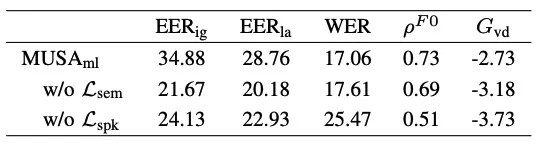
移除语义蒸馏(w/o Lsem):EER下降至21.67%(Ignorant场景),WER上升至17.61%,表明语义蒸馏防止了说话人信息泄漏至内容编码。
移除说话人蒸馏(w/o Lspk):WER升至25.47%,ρF0降至0.51,显示说话人蒸馏对时序特征解耦的重要性。
表4 消融实验
说话人编码可视化:t-SNE图显示(图4),MUSA的说话人编码(Es输出)在不同说话人间形成清晰聚类(图3),验证了说话人蒸馏的有效性。
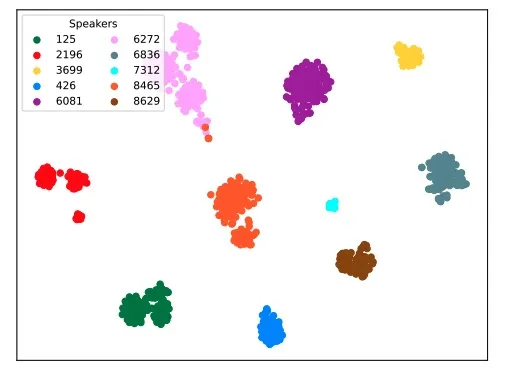
图4 说话人聚类图
[1] J. Yao, Q. Wang, L. Zhang, P. Guo, Y. Liang, and L. Xie, “NWPU-ASLP system for the VoicePrivacy 2022 challenge,” arXiv preprint arXiv:2209.11969, 2022
[2] B. M. L. Srivastava, M. Maouche, M. Sahidullah, E. Vincent, A. Bellet, M. Tommasi, N. Tomashenko, X. Wang, and J. Yamagishi, “Privacy and utility of x-vector based speaker anonymization,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 30, pp. 2383–2395, 2022
[3] J. Yao, Q. Wang, Y. Lei, P. Guo, L. Xie, N. Wang, and J. Liu, “Distinguishable speaker anonymization based on formant and fundamental frequency scaling,” in ICASSP 2023-2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2023.
[4] C. Huang, Y. Y. Lin, H. Lee, and L. Lee, “Defending your voice: Adversarial attack on voice conversion,” in IEEE Spoken Language Technology Workshop, SLT, 2021, pp. 552–559.
[5] Miao X, Wang X, Cooper E, et al. Speaker anonymization using orthogonal householder neural network. in IEEE/ACM Transactions on Audio, Speech, and Language Processing, 2023.
