
 语音小管家
今天分享一个声音克隆及语音合成系统——MegaTTS3
MegaTTS3 是由字节跳动与浙江大学联合推出的开源语音合成工具,主模型仅有 0.45B 参数,具备高度轻量化优势。支持超高质量的语音克隆,能在 Huggingface Demo 体验;具备双语能力,可实现中文和英文的代码切换。
此外,MegaTTS3 还引入了口音强度控制功能,用户可以通过调整参数生成带有不同程度口音的语音,为个性化语音应用提供了更多可能性。
开源地址:https://github.com/bytedance/MegaTTS3
论文地址:https://arxiv.org/abs/2502.18924
主要功能
高效轻量级 TTS:仅 0.45B(4.5 亿)参数,相比大规模 TTS 模型,更轻量、更易部署。
高质量语音克隆:可模拟目标说话人的音色、语气、节奏,生成高度拟真的合成语音。
中英文混合更自然:解决“英式腔调 vs. 美式腔调”不自然切换问题,让不同语言的切换更丝滑。
口音强度控制:允许调整口音强度,让用户根据需要选择更偏母语或更偏目标语言的发音方式。
核心架构
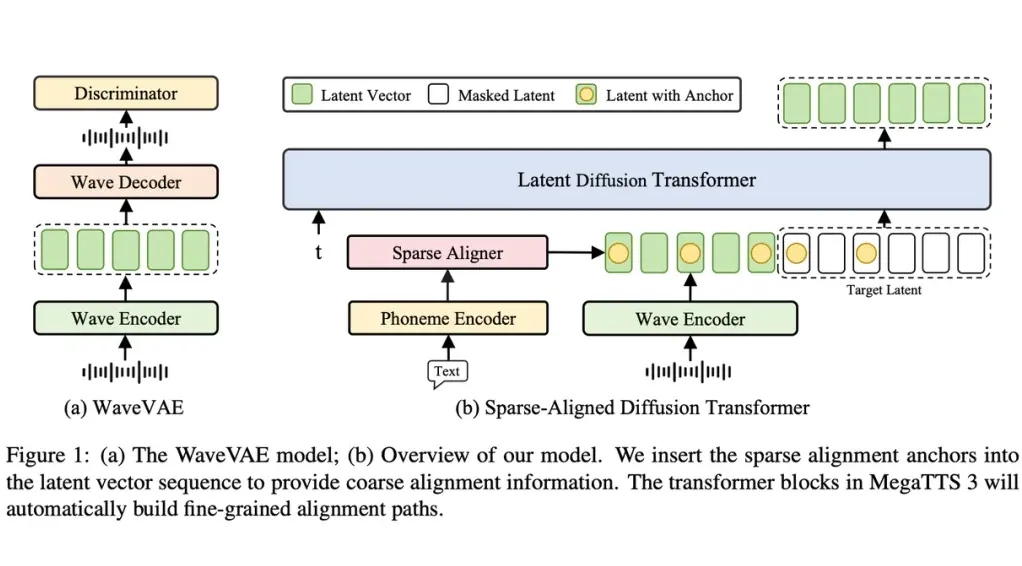
MegaTTS3 采用 WaveVAE 和 Latent Diffusion Transformer 双模块协同合作。
1. WaveVAE 模块,可以将原始语音信号压缩成紧凑的潜向量:
编码器:对语音进行下采样,并提取关键的高频细节信息,使音色得以保留;
解码器:借助多尺度、多分辨率判别器(如 MPD、MSD、MRD),实现高保真语音还原;
训练策略:通过重构误差、KL 散度和对抗损失的综合考量,确保生成的潜向量的精准。
2. Latent Diffusion Transformer 模块,在压缩后的潜空间中,MegaTTS3 利用扩散模型进行条件生成。
隐式对齐机制:Transformer 的自注意力机制在潜空间中构建出文本与语音之间的细致映射,确保语音与文本的融合;
稀疏对齐策略:通过在潜向量序列中嵌入少量对齐锚点,降低对齐难度,同时为每个音素提供精准的位置信息,使生成过程自由稳定;
训练方法:将潜向量序列分为“提示区域”和“遮蔽区域”,在提示条件下预测被遮蔽部分,模型在不断训练中逐步掌握对齐技能。
快速使用
MegaTTS3 的安装和使用过程简单,支持 Python 环境部署。
① 克隆项目
git clone https://github.com/bytedance/MegaTTS3.git
cd MegaTTS3
② 创建Python虚拟环境
conda create -n megatts3-env python=3.9
conda activate megatts3-env
③ 安装依赖
pip install -r requirements.txt
④ 下载模型从 Google Drive 或 Hugging Face 获取预训练模型,放入 ./checkpoints/。
使用方法如下:
基本推理:
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav "sample.wav" --input_text "这是一段测试语音。" --output_dir ./gen 调整口音:
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav "english.wav" --input_text "这是一条标准发音。" --output_dir ./gen --p_w 2.5 --t_w 2.5 Web界面,启用Gradio:
CUDA_VISIBLE_DEVICES=0 python tts/gradio_api.py 提示:更多用法(如 CPU 推理)见 GitHub 文档,几分钟即可生成你的第一段语音。
Demo
