
 语音小管家
传统级联式语音交互系统通常采用"语音识别-大语言模型-语音合成"的串联处理流程,这种架构存在明显的时延累积和信息损耗问题。相比之下,语音交互大模型通过端到端的处理方式,将语音理解和语音生成能力深度融合到大语言模型中,从而实现高性能、低时延的语音交互。尽管最近开源社区陆续推出了一些支持语音交互的模型,但训练框架和数据的缺失阻碍了这些工作的复现,极大地限制了该领域的研究进展。
近日,上海交通大学人工智能学院与蚂蚁集团共同开源了语音交互大模型VocalNet,不仅推出了1B、8B两个版本的模型,还公开了完整的数据,以及模型训练、推理的代码框架。另外,VocalNet引入了multi-token prediction技术,实现了语音生成速度和质量的双重提升。
在公开的OpenAudioBench测试数据上,VocalNet-8B显著超越了LLaMA-Omni、Freeze-Omni、GLM-4-Voice等其他开源语音交互大模型,并实现了与MiniCPM-o、Qwen2.5-Omni等工业界全模态模型相当的性能。
论文题目:VocalNet: Speech LLM with Multi-Token Prediction for Faster and High-Quality Generation
作者列表:王宇昊,刘鹤洋,程子洋,吴荣华,谷群山,王延峰,王钰
代码链接:
论文链接:
语音交互系统的发展已从传统的级联架构转向端到端语音大语言模型。先前的研究将语音大语言模型分为两类:原生多模态模型和对齐多模态模型。原生多模态模型,例如Mini-Omni、Moshi和GLM-4-Voice,使用仅包含解码器的Transformer来同时解码文本和语音,从而实现解码架构的集成。然而,这些模型需要大量的预训练数据,并且容易遭受灾难性遗忘。相比之下,对齐多模态模型,如LLaMA-Omni、Freeze-Omni和Qwen2.5-Omni,结合了独立的语音编解码器以及大模型主干来实现语音理解和生成。这种方法能够更好地保留了LLM本身的知识和推理能力。目前对齐多模态模型的研究尚未深入探索语音生成的建模方法和训练范式。大多数现有模型依赖于自回归式的语音解码,采用next-token prediction (NTP)的范式进行训练和推理。
与文本相比,语音信号展现出更复杂的时间特性,还承载着更为丰富的声学信息(如韵律、情感等),这使得语音token序列的长度通常远远长于相应的文本序列,因此逐token生成方式往往延时较高。另外,语音信号中包含多层次的声学语义结构,例如音素、音节、韵律等,传统next-token prediction的训练范式可能不利于模型学习捕捉这些局部声学模式。为了解决这些挑战,VocalNet首次将multi-token prediction(MTP)引入语音大语言模型中,并针对语音生成提出了一种简单而有效的实现方案。基于此,联合实验室成功构建了高性能、低延迟的语音大语言模型VocalNet-1B和VocalNet-8B。
为了促进社区的进一步学术探索,并鼓励更广泛的合作参与,联合实验室开源了可扩展的、易复现的训练框架以及训练数据,能够高效地赋予大语言模型实时语音交互能力。完整的开源内容包括:
732K训练样本,包含约6K小时的语音数据
代码框架,包括模型训练以及推理代码。
模型参数,包括1B和8B两个版本,支持高流畅度的语音交互。
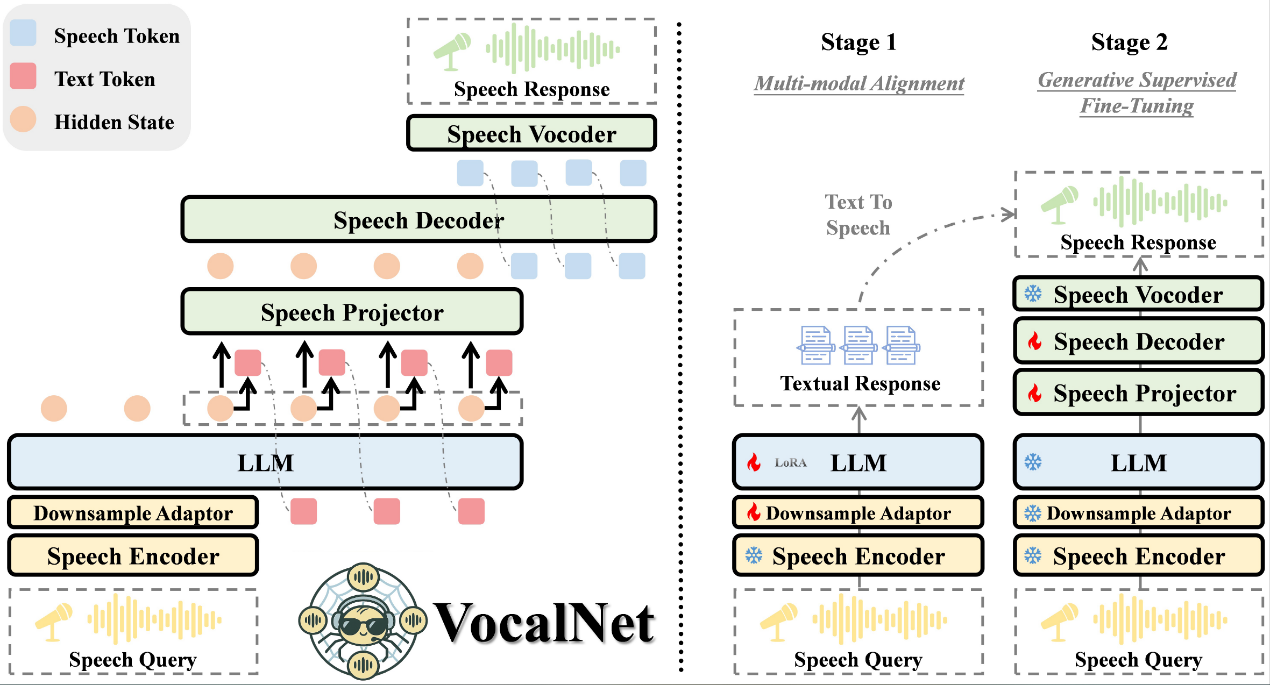
作为对齐多模态模型,VocalNet包含语音编码器、大模型主干和语音解码器。在语音编码器后添加了用于降低帧率的下采样适配器,并引入语音映射层用于对齐大模型隐藏状态和语音解码器输入之间的维度差距。语音解码器生成的语音令牌被输入到语音声码器中,生成相应的语音响应。VocalNet采用两阶段训练:模态对齐和生成式监督微调。
在第一阶段,VocalNet使用语音指令和文本响应进行训练。语音编码器被冻结,以保持其提取高质量语音表征的能力;下采样适配器被训练,以促进语音和文本特征之间的对齐。大模型主干使用LoRA进行微调,在增强其多模态性能的同时尽可能保留其原有的知识和推理能力。
在第二阶段,VocalNet使用语音指令和语音响应作为训练数据,并训练语音映射层和语音解码器以生成与真实语音响应对应的语音令牌。
当前,语音大语言模型主要采用next-token prediction(NTP)的范式进行语音生成的训练与推理。尽管这种方法取得了显著成效,但由于语音信号的特殊性,NTP可能并非语音生成的最优方案。首先,语音token序列通常远远长于文本序列,逐token预测的推理方式可能会导致较高的生成延迟。其次,语音信号具有丰富的层次化声学-语义结构,包括音素、音节、语调等多级特征,而传统的NTP方法仅关注单个token预测,难以有效建模这种复杂的层次化关系,特别是在训练数据受限的情况下。为此,团队针对语音大语言模型引入了multi-token prediction(MTP)的方法,从而有效应对上述语音建模中的挑战。MTP通过显式建模多个token的联合分布,将原本需要逐步完成的生成过程压缩为更少的推理步骤,显著提升了语音生成效率。此外,MTP通过直接建模更高阶的上下文依赖关系,不仅缓解了误差积累问题,还能使模型能够更准确地捕捉语音信号中蕴含的层次化结构特征,更好的建模语音。
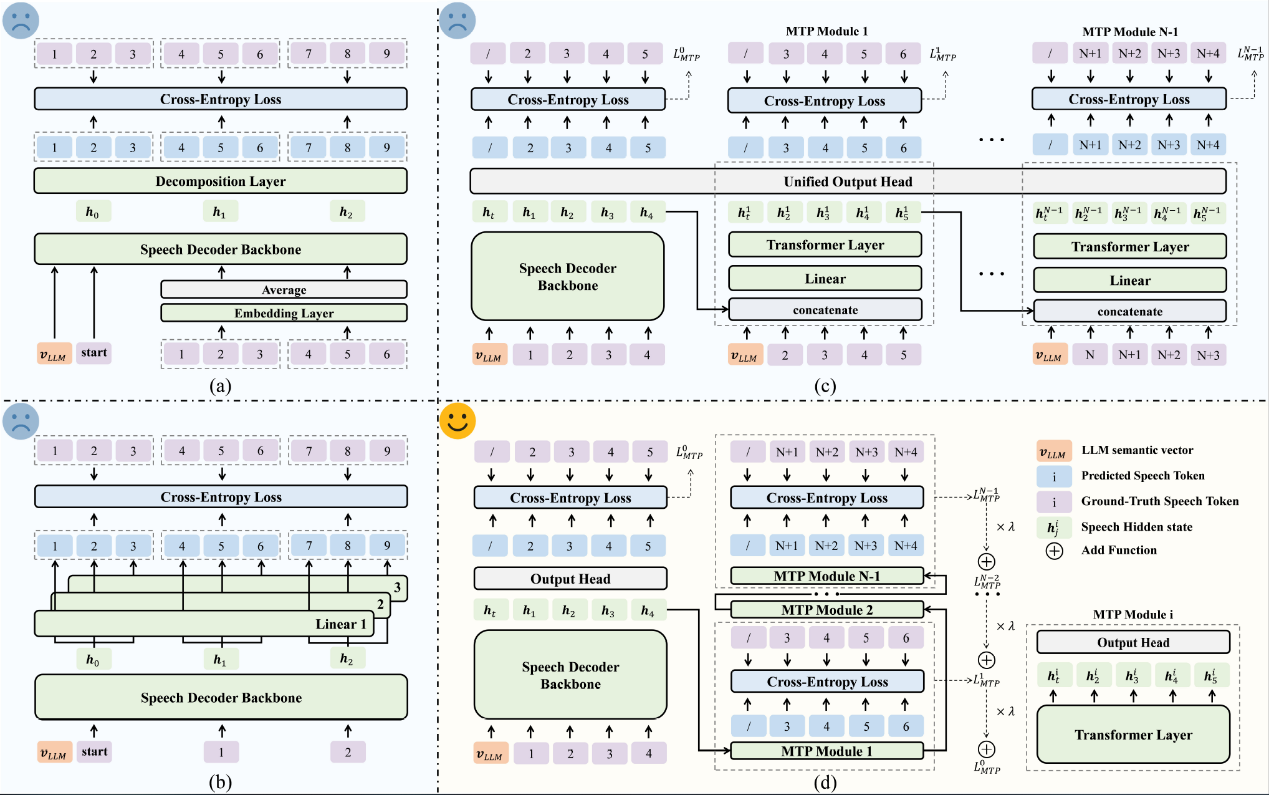
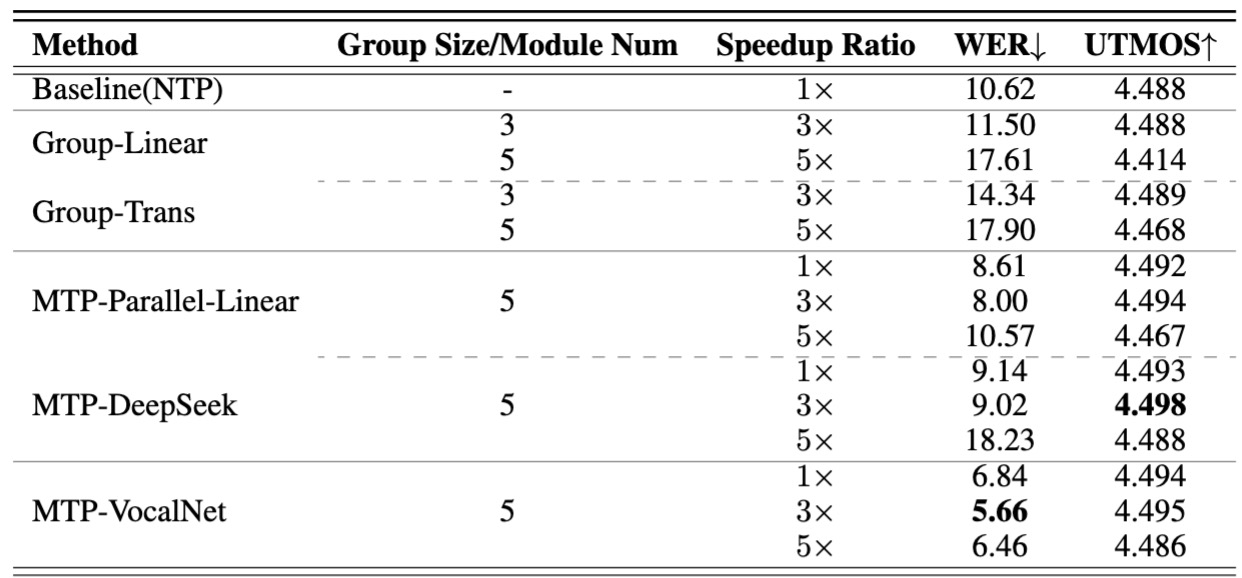
在MTP的具体实现上,研究团队经过系统性的方案评估与优化,最终提出了一种简单而高效的实现架构。团队首先深入分析了分组建模(Group modeling,图a)和现有大语言模型中MTP的实现方案(图b,c),发现这些方案在语音生成上存在破坏token间时序依赖性等问题。基于这些发现,团队创新性地设计了VocalNet的MTP架构,该架构采用级联Transformer层构建MTP模块,通过单次推理即可预测连续的多个语音token,同时完整保留token间的时序依赖关系。此外,VocalNet采用了逐层衰减的MTP损失函数,使模型在学习信号联合分布的同时优先考虑短期预测的准确性。
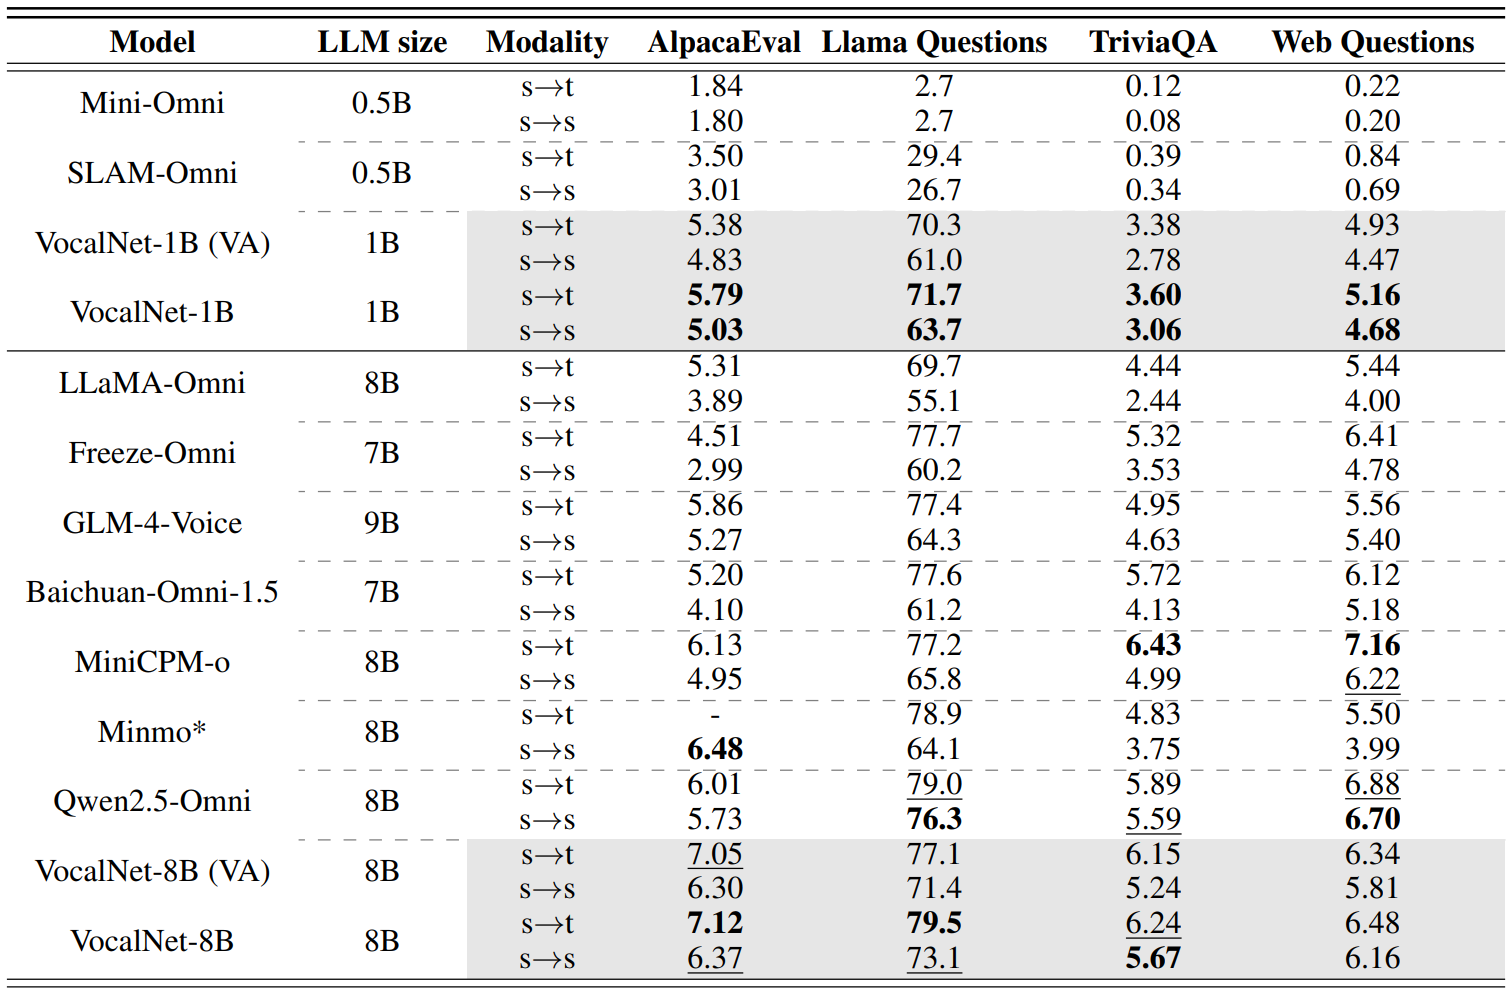
为了验证VocalNet的性能,实验选取了OpenAudioBench的英文测试集进行测试。s→t代表直接评测文本响应,而s→s代表使用语音响应转录后的文本进行评测。在以上语音对话和语音问答测试集上,VocalNet-8B取得和MiniCPM-o、Qwen2.5-Omni相当的性能,并显著超越其他语音大语言模型。此外,VocalNet-1B在上述测试中展现出了与部分8B左右的语音大语言模型相当的性能(例如LLaMA-Omni和Frezze-Omni),为低资源条件下研发语音交互系统提供了参考。
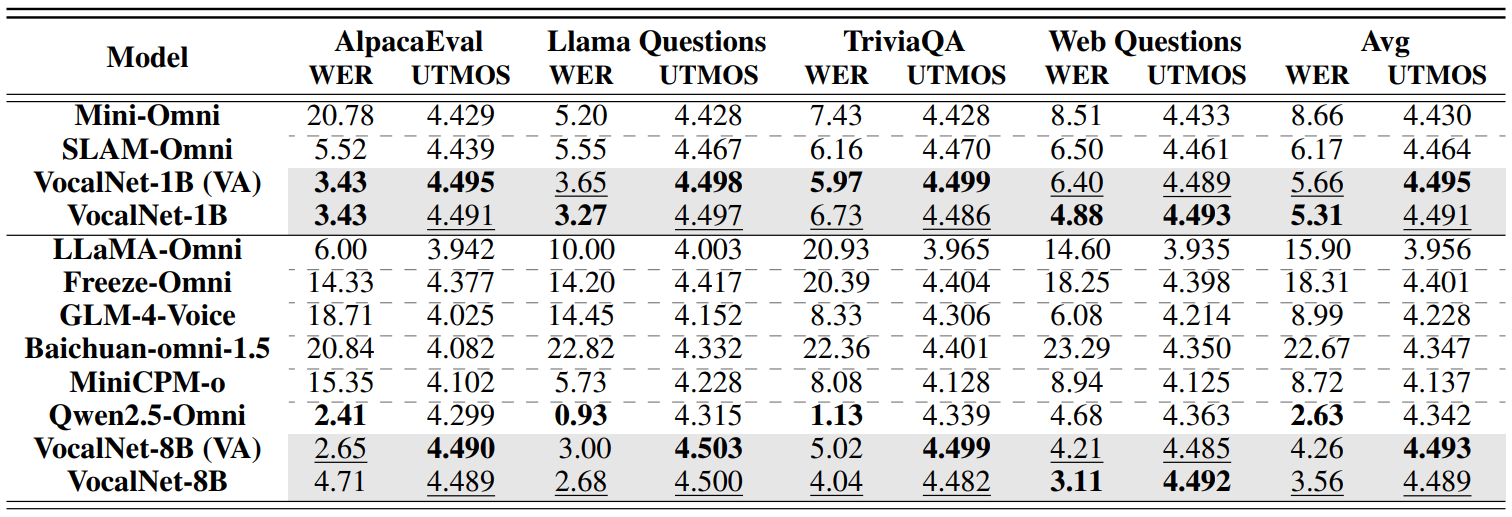
为了测试模型的文本-语音响应的一致性,以及语音响应的声学质量,实验将转录后的语音响应与文本响应进行词错误率(WER)的计算,并利用UTMOS预测语音响应的MOS分数。结果表明,VocalNet模型在词错误率方面表现优异,仅次于Qwen2.5-Omni模型,且这两个模型在文本-语音响应一致性方面显著优于其他开源模型。此外,在声学质量评估中,VocalNet展现出了一定优势。
对于不同的MTP实现方案,实验结果表明VocalNet的MTP架构在不同加速比条件下均展现出卓越的性能优势,显著优于其他对比方法及基线方法。特别值得注意的是,当加速比达到5时,唯有MTP-VocalNet能够保持稳定的性能表现,未出现明显的语音质量退化现象,其生成的语音仍保持较高的UTMOS和较低的WER。这一突出表现充分证明了MTP-VocalNet架构的技术优越性。
团队开源了高性能的语音大语言模型VocalNet。VocalNet将multi-token prediction技术引入语音大语言模型,实现了语音生成速度以及语音生成质量的双重提升。在OpenAudioBench上的实验结果展现了VocalNet-1B和VocalNet-8B在语音问答和对话场景中的卓越性能,证明了其突出的模态对齐水平和语音质量。VocalNet的全面开源降低了语音交互系统的开发和训练门槛,为开源社区复现和改进语音大语言模型提供了良好基准。
