
 语音小管家
目标说话人提取(Target Speaker Extraction, TSE)旨在利用参考注册语音等辅助信息,从混合音频中提取目标说话人的语音。目前,大多数TSE方法基于判别式模型(Discriminative Model),通过直接学习混合语音到目标说话人语音的映射来实现分离。然而,这类方法在处理未见数据及低信噪比时表现可能不佳,有时甚至会引入不必要的失真[1]。
近年来,基于生成式模型(Generative Model)的目标说话人提取方法逐渐受到关注,因其在泛化能力和音频生成质量方面具有显著优势。其中,基于语言模型的生成式目标说话人提取方法也开始被探索。然而,现有的基于自回归(Auto-Regressive)Decoder-only语言模型的方法尚未针对目标说话人分离任务进行深入研究,并且大多数方法采用离散特征作为输入[2]。这些离散特征一定程度上可能会对目标说话人提取的目标人副语言信息保留产生负面影响。
最近,昆山杜克大学提出了一种基于Auto-Regressive Decoder-only语言模型的目标说话人提取方法。该方法以LauraGPT [3]的Decoder-only语言模型框架为基础,输出端采用离散表征,输入端则采用连续特征而非离散表征。实验结果表明,所提出的方法在语音质量、可懂度以及说话人相似度方面均取得了优异的性能表现。
论文:LauraTSE: Target Speaker Extraction using Auto-Regressive Decoder-Only Language Models
作者:唐贝隆,曾邦,李明
论文:https://arxiv.org/pdf/2504.07402
Demo:https://beilong-tang.github.io/lauraTSE.demo/
开源代码和模型权重:
目前主流的生成式目标人提取语言模型包括TSELM [4]和SpeechX [3],它们均采用了离散特征作为语言模型输入。
其中,TSELM使用了Encoder-only的语言模型结构,输入特征为WavLM经过KMeans离散化后的特征。由于KMeans离散化过程导致部分说话人信息丢失,因此TSELM的生成结果存在说话人相似度偏低的问题。
SpeechX则采用了Auto-Regressive Decoder-only模型结构,输入特征是Codec第一层离散特征。作为一个多任务学习模型(同时处理语音分离和目标人提取任务),SpeechX所设置的目标人提取任务难度偏低,因此未能充分展现其在目标人提取任务上的潜力。
此外,有研究表明,使用离散特征作为语言模型输入相比于连续特征在副语言信息表现上存在劣势,这进一步限制了上述方法的性能提升。
为了验证使用Auto-Regressive Decoder-only语言模型与连续输入特征进行目标人提取的可行性,我们设计了新的模型架构LauraTSE(如图1所示)。LauraTSE基于LauraGPT架构,输入包括注册语音和混合语音,它们首先被提取为log-梅尔谱(log-Mel spectrogram)连续特征。
随后,这些特征经过一个Conformer模块,生成作为Auto-Regressive Decoder-only语言模型的输入。Decoder-only语言模型的输出为目标语音经过FunCodec第一层编码后的离散特征。接下来,这些离散特征与Conformer提取的注册特征和混合特征一同,输入到一个Encoder-only语言模型,用于生成目标语音对应的FunCodec连续特征。
最后,通过FunCodec解码器,连续特征被还原为最终的音频输出。作者也尝试了chunkwise流式推理的方法,效果也是很好的,结果会在近期更新上去。
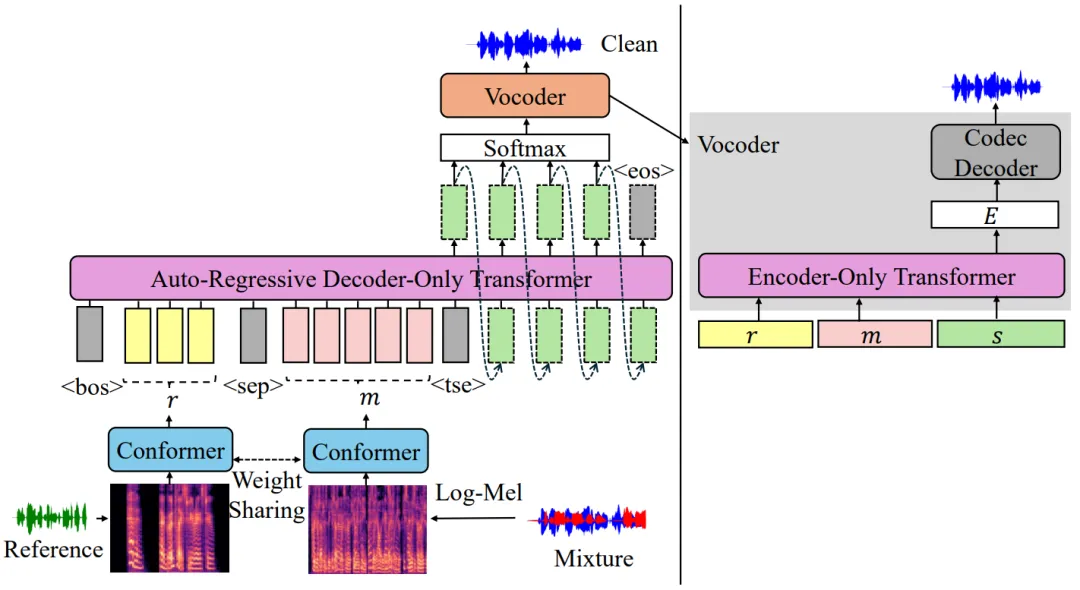
我们使用LibriSpeech数据集作为训练数据,通过Dynamic Mixing的方式动态生成训练样本。测试集采用Libri2Mix Clean测试集。
实验结果如图2所示。与现有两大生成式模型TSELM和AnyEnhance [5]相比,LauraTSE在以下方面展现了优越性能
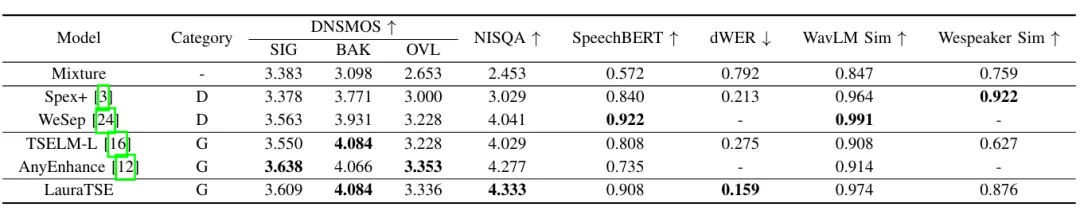
图2:Libri2mix Clean实验结果
在语音生成质量方面(测量指标:DNSMOS、NISQA),LauraTSE达到了相似甚至更高的得分。
在语音可懂度方面(测量指标:SpeechBERT、dWER),LauraTSE展现了显著的提升。
在说话人相似度方面(测量指标:WavLM Sim、WeSpeaker Sim),LauraTSE也实现了明显的提升。
通过对比实验结果(见图3),我们发现,使用连续特征(Base)相比离散特征(Discrete IO)能够显著提升目标说话人提取的效果。此外,采用Codec输出的特征(Base)相比于使用WavLM输出的离散特征表现更佳。
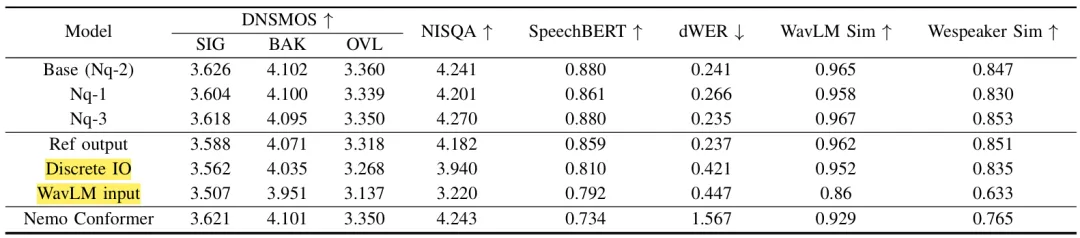
图3:LauraTSE的对比实验
本工作提出了LauraTSE,一种基于连续输入特征和Auto-Regressive Decoder-only模型的目标说话人提取方法。实验结果表明,LauraTSE在语音质量、语音可懂度和说话人相似度等指标上均取得了优异的表现。上述结果验证了连续特征结合自回归Decoder-only语言模型在目标说话人提取任务中的应用潜力和发展前景。
引用:
[1] Wang, Peidong, and Ke Tan. "Bridging the gap between monaural speech enhancement and recognition with distortion-independent acoustic modeling."IEEE/ACM Transactions on Audio, Speech, and Language Processing28 (2019): 39-48
[2] Wang, Xiaofei, et al. "Speechx: Neural codec language model as a versatile speech transformer."IEEE/ACM Transactions on Audio, Speech, and Language Processing(2024)
[3] Du, Zhihao, et al. "Lauragpt: Listen, attend, understand, and regenerate audio with gpt."arXiv preprint arXiv:2310.04673(2023)
[4] Tang, Beilong, Bang Zeng, and Ming Li. "TSELM: Target Speaker Extraction using Discrete Tokens and Language Models."arXiv preprint arXiv:2409.07841(2024)
[5] Zhang, Junan, et al. "AnyEnhance: A Unified Generative Model with Prompt-Guidance and Self-Critic for Voice Enhancement."arXiv preprint arXiv:2501.15417(2025)
