
 语音小管家
近期,昆山杜克大学在语音旗舰期刊IEEE Transactions on Audio, Speech and Language Processing (TASLP)上发表了一篇题为“Self-supervised Reflective Learning through Self-distillation and Online Clustering for Speaker Representation Learning”的论文。论文研究了基于自监督学习的说话人表征学习。
该论文创新点如下:
自监督反思学习。引入了一种新的学习范式——自监督反思学习(SSRL),将自监督表征学习与自监督知识蒸馏和在线聚类联系起来,教师模型通过在线聚类不断纯化伪标签,为训练学生模型提供动态监督,简化了现有的两阶段无监督迭代框架,消除了迭代瓶颈。
噪声标签建模。首先,维护一个历史伪标签队列,以过滤预测的异常值,并确保一致性和可靠的伪标签。其次,集成了一种使用双高斯混合模型(GMM)的标签噪声建模策略,以捕获训练样本的损失分布,为每个样本提供干净标签概率用于调整最终损失。
论文题目:Self-supervised Reflective Learning through Self-distillation and Online Clustering for Speaker Representation Learning
作者列表:Danwei Cai, Zexin Cai, Ze Li and Ming Li
论文原文:
代码链接:https://github.com/ZXHY-82/SSRL
说话人验证(SV)指的是根据语音确认说话人身份的过程。近年来,自监督学习方法在说话人表征学习方面取得了重大进展。该类方法能够有效利用未标记的语音数据,减少对人工标注的依赖,以促进在实际应用程序中的部署。
当前主流的自监督说话人表征学习框架通常采用两阶段迭代机制:第一阶段通过自监督学习获取初始的说话人表征,第二阶段结合聚类与判别训练对模型进行精化。在该框架中,聚类算法用于分析学习到的表征,为无标签数据生成伪标签;随后,通过以伪标签为监督信息的判别学习来训练模型,该过程迭代进行,每一轮训练都细化说话人表征并提高伪标签的质量。这种两阶段迭代方法虽然有效,但引入了大量的计算开销,主要来自于通过聚类和判别训练生成伪标签的迭代过程。此外,聚类产生的初始伪标签包含大量噪声,这损害了模型学习区分说话人特征的能力。
因此,我们在这篇文章里探索如何通过在每个训练步骤而不是在每个完整的训练轮之后更新伪标签来绕过两阶段框架的迭代性质,以及如何进行噪声标签建模以减小噪声标签对模型的损害。
为简化两阶段迭代框架,本文引入了一种新的学习范式——自监督反思学习(SSRL)。如图1所示,在原始的两阶段流程中,第一阶段使用自监督表征学习并生成初始伪标签。第二阶段由多轮训练组成,每轮训练包括:(1)通过聚类生成伪标签,以及(2)使用这些伪标签进行判别训练。在保持第一阶段不变的同时,所提出的SSRL方法在单个训练阶段用连续的标签纠正替代多轮过程。SSRL首先需要一个初始化步骤以确保稳定的伪标签生成。这可以通过使用第1阶段伪标签进行简短的判别训练来实现,也可以直接使用第1阶段自监督模型作为编码器,并使用伪聚类中心初始化分类器。初始化之后,SSRL通过其反思学习机制在训练过程中动态更新伪标签。
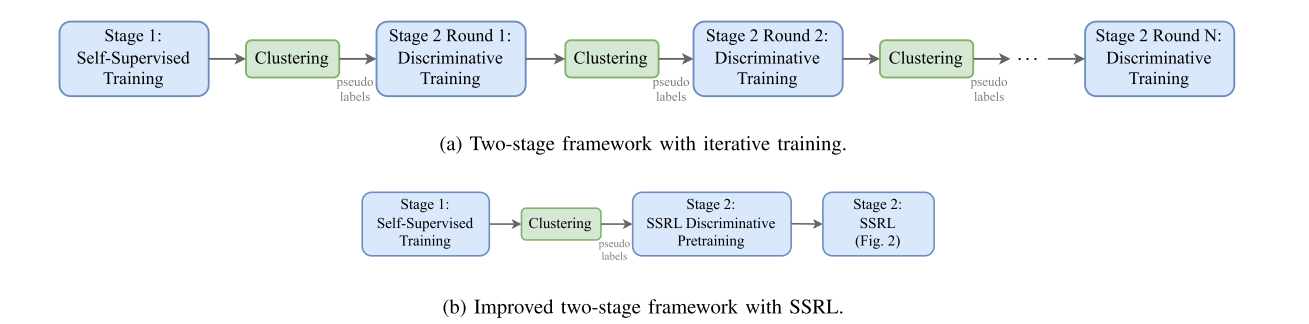
图1自监督反思学习与两阶段迭代方法的比较
SSRL整体框架如图2所示。为了简化学习并提高效率,我们试图通过在每个训练步骤而不是在每个完整的训练轮之后更新伪标签来绕过两阶段框架的迭代性质。但直接从模型预测中生成标签(例如,分配后验概率最高的类)可能会让模型受到确认偏差的影响,坍缩为对所有样本的单一预测。避免这种退化解决方案的关键是将训练与标签分配解耦,确保模型不会直接在自己的预测上进行训练。在两阶段迭代框架中,模型是通过收敛后对伪标签进行聚类来实现这种解耦。SSRL则通过自监督知识蒸馏实现这种解耦,其采用教师模型通过在线聚类来生成伪标签以训练学生模型,教师模型则通过学生模型的指数移动平均(EMA)进行更新,作为过去模型状态的集合,从而稳定伪标签的生成并防止过拟合。
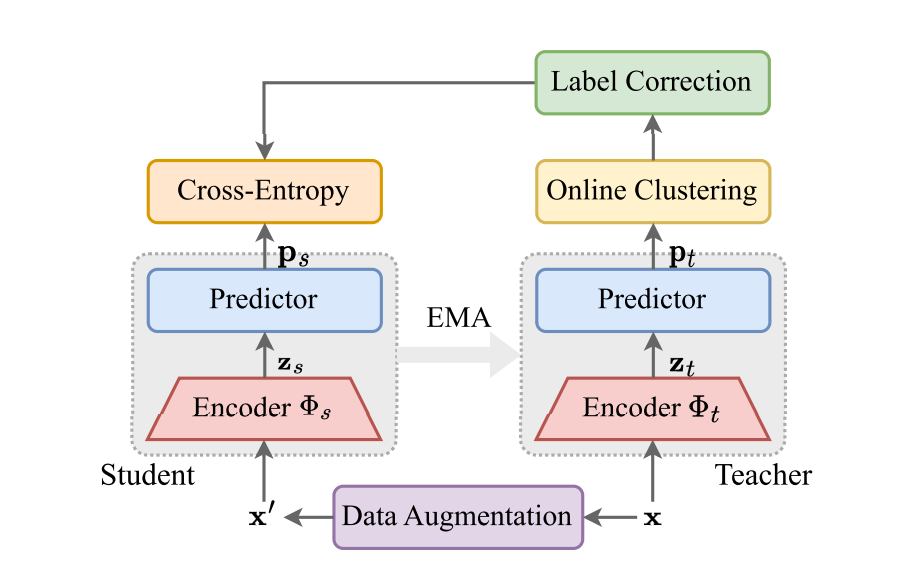
图2自监督反思学习框架
两阶段迭代框架的另一个限制是伪标签中的高噪声,这会降低学习效果。我们通过两个关键策略来解决这个问题。
策略1:通过维护一个历史伪标签队列,以过滤预测的异常值,来确保伪标签的一致性和可靠性。
策略2:使用双高斯混合模型对训练样本的损失分布进行建模,为每个样本提供干净的标签概率,用于调整最终损失。
表一展示了SSRL方法和两阶段迭代方法在在VoxCeleb1测试集上的说话人验证性能比较。可以看到两阶段迭代方法在第三轮取得了2.28% EER结果,而SSRL仅一轮训练就获取了1.25% EER,远优于两阶段迭代方法。如此巨大的差异受益于SSRL其鲁棒的伪伪标签机制。与为整个训练轮使用静态伪标签的两阶段迭代框架不同,SSRL通过自监督知识蒸馏和在线聚类实现标签的动态更新,这种持续的改进确保了学生模型总是受益于最新的监督信号,消除了在两阶段迭代框架中的“陈旧”标签问题。此外,SSRL结合了伪标签队列和噪声标签建模技术,进一步提高了伪标签的可靠性和鲁棒性,提高了模型的整体性能。
表1两阶段迭代方法和SSRL方法(基于ECAPA-TDNN模型)在VoxCeleb1测试集上的说话人验证性能比较
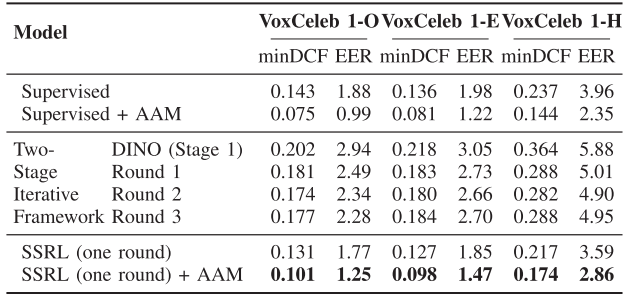
表2展示了SSRL与各种两阶段迭代方法变体的比较,所有方法均使用ECAPA-TDNN模型。可以看到SSRL方法均优于各种两阶段迭代方法变体。此外我们还探索了将WavLM作为特征提取器与SSRL集成在一起。具体来说,我们从WavLM-Large编码器的每一层提取特征,并通过可学习的加权和对其进行融合,为ECAPA-TDNN的输入创建复合特征。在训练过程中,我们首先冻结WavLM参数进行训练,随后解冻进行联合优化,最终实现了1.04%的EER,进一步提升了模型性能。
表2 SSRL方法与各种两阶段迭代变体方法的比较
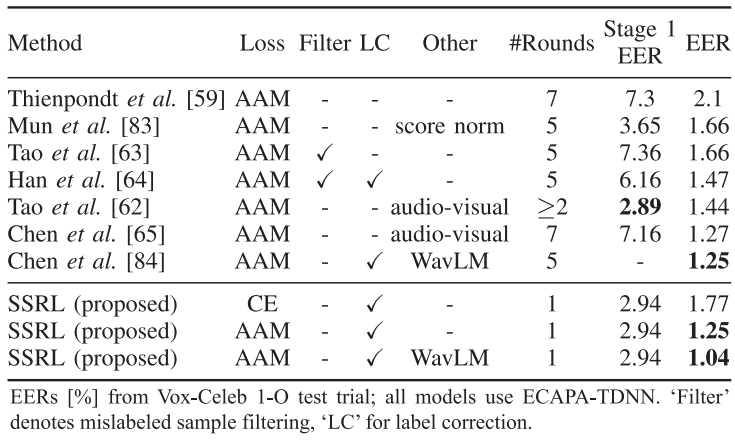
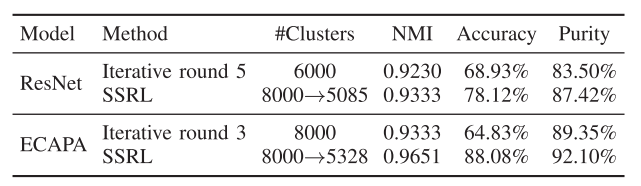
表3对比了两阶段迭代方法与所提出的SSRL方法在最终伪标签质量方面的表现。结果表明,无论在ResNet还是ECAPA-TDNN模型上,SSRL方法均显著优于传统两阶段迭代方法。
表3两阶段迭代方法和SSRL方法的伪标签质量比较
与需要多轮训练的迭代式第二阶段不同,SSRL采用了一种更为简化的方法。这种方法消除了迭代训练的需求,从而提升了效率。图3对此进行了直观展示,该图比较了两阶段框架中迭代式第二阶段与SSRL第二阶段的等错误率(EER)随训练时间的变化情况。
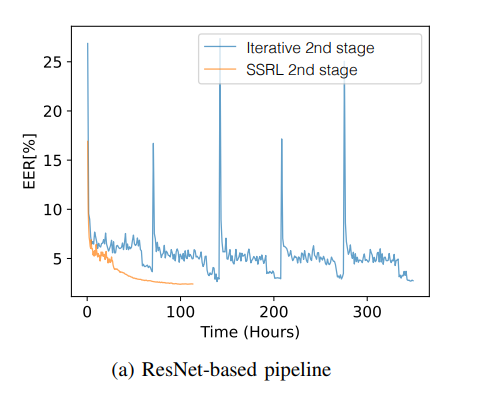
图3迭代式训练和SSRL训练在训练时间及测试结果上的比较
本文提出了一种全新的无监督说话人表示学习范式——自监督反思性学习(SSRL)。该方法通过融合自监督知识蒸馏与在线聚类,简化了现有的两阶段迭代学习框架。具体而言,教师模型借助在线聚类优化伪标签,为学生模型的训练提供动态监督信号。此外,SSRL还引入了标签校正与噪声标签建模策略,进一步提升伪标签的可靠性与质量。实验结果表明,SSRL显著优于现有的两阶段迭代方法。在VoxCeleb1测试集上,SSRL在单轮训练中即超越了需进行五轮迭代的现有方法,充分展示了其高效性与有效性。
