
 语音小管家
Maitrix 团队最新发布的开源 AI 端到端语音模型: Voila,该模型采用创新的分层Transformer架构,突破传统语音AI限制,实现195ms超低延迟实时交互,支持高度个性化定制,并在语音识别、合成及多语言翻译等任务中表现卓越。
项目主页:https://voila.maitrix.org/
代码:https://github.com/maitrix-org/Voila
论文:https://arxiv.org/pdf/2505.02707
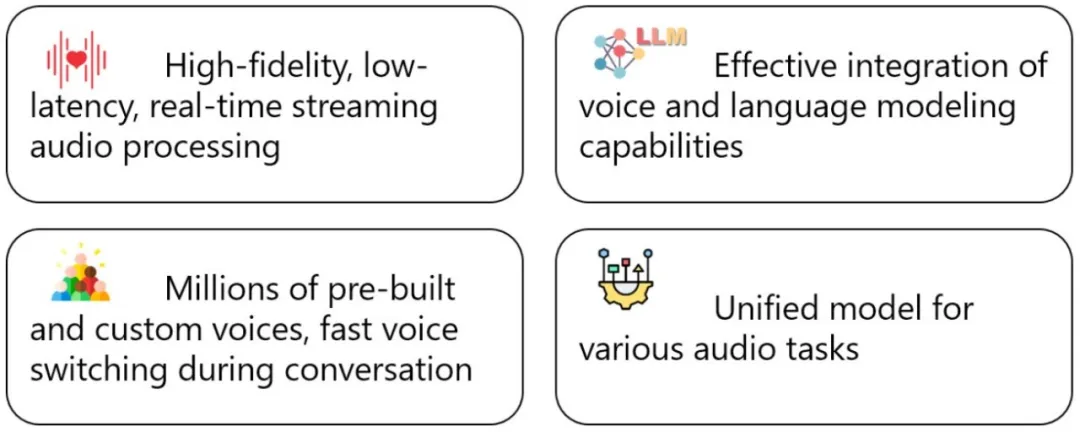
全双工语音对话:可同时听与说,不再是“你说完我再说”,模拟真实人类对话;
超低延迟:195毫秒延迟,超越人类平均反应时间(200-250ms);
ASR/TTS支持:高精度语音转文本、文本转语音;
语音个性预设:预置100万种语音风格(性别、年龄、情绪、音色均可控制);
多语言支持:支持中英等多语种ASR + TTS +翻译;
多模型分类:提供了用于各种音频任务的统一模型。
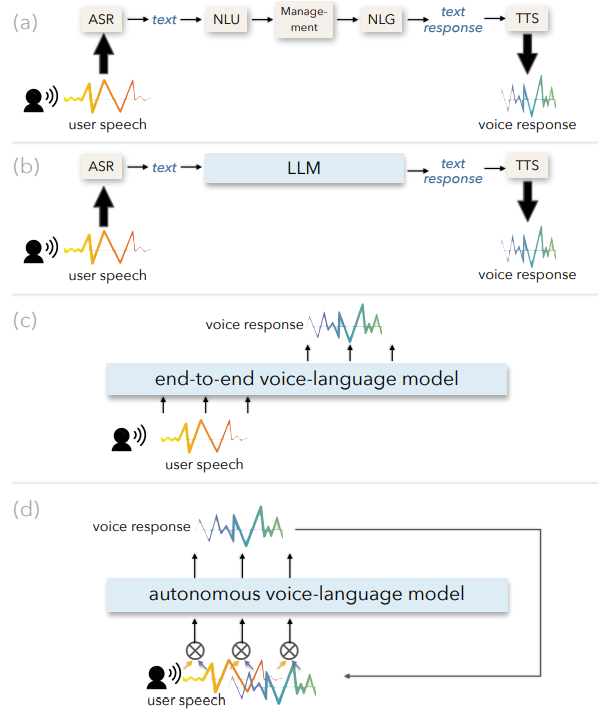
语音对话系统的不同范式:
传统的管道系统,如 2010 年代推出的 Apple Siri、Amazon Alexa 和 Google Assistant;
使用大型语言模型 (LLMs) 处理基于文本的理解和回应生成的简化管道系统;
端到端音频输入输出系统,提供低延迟和丰富的语音细节;
自主系统,进一步实现动态、主动的互动。
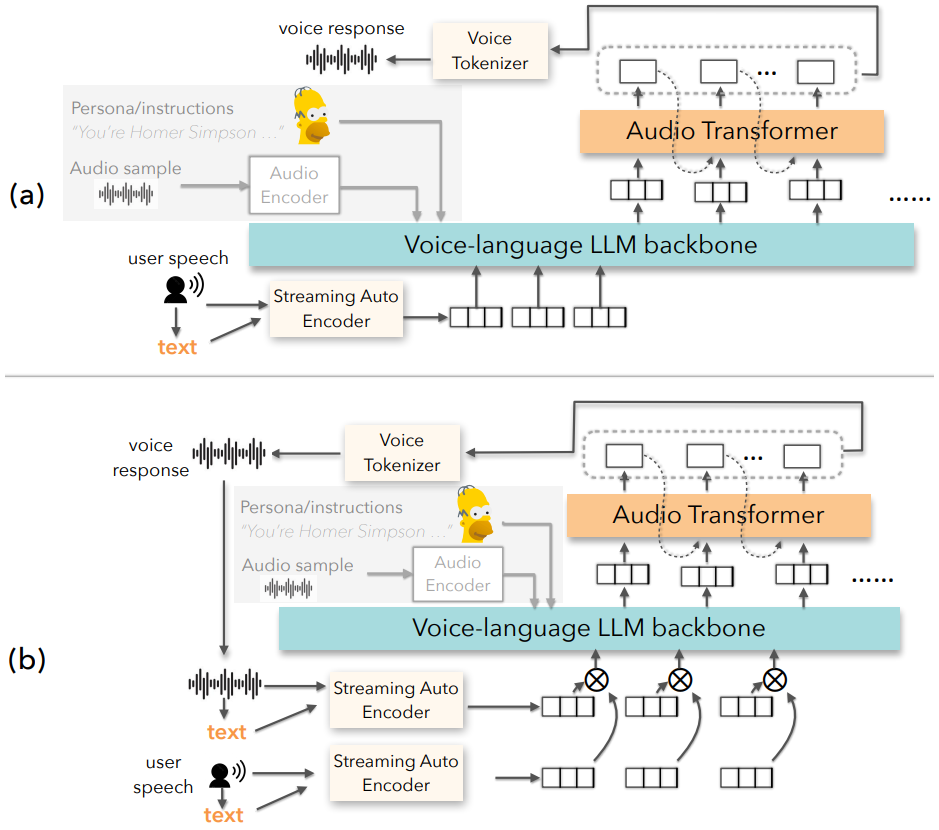
Voila 模型:(a) Voila-e2e 用于端到端语音对话,(b) Voila-autonomous 用于自主互动。这两种模型都支持通过文本指令和音频样本轻松定制说话者的特征和声音。
Voila 提供有在线网页版Demo地址直接体验,也可使用Python方式直接调用。
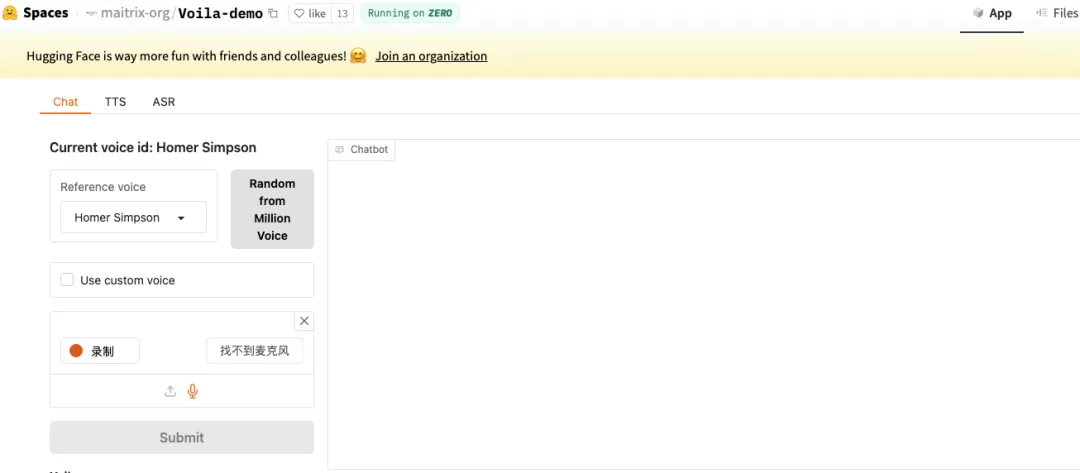
在线Gradio:https://huggingface.co/spaces/maitrix-org/Voila-demo
在线网页端打开后,你会看到它分为Chat、TTS、ASR三大模块,可选择语音角色,打开麦克风直接进行语音对话,或上传音频进行语音转文本等功能。
Python使用方式
① 克隆项目
git clone https://github.com/maitrix-org/Voila.git
cd Voila
② 实时语音对话
import torch
from transformers import AutoModel, AutoProcessor
model = AutoModel.from_pretrained("maitrix-org/Voila-base").to("cuda")
processor = AutoProcessor.from_pretrained("maitrix-org/Voila-base")
audio_input, _ = librosa.load("test.mp3", sr=16000)
inputs = processor(audio=audio_input, sampling_rate=16000, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, max_length=2000)
audio_output = processor.decode(outputs.audio, sampling_rate=16000)
with open("output.wav", "wb") as f:
    f.write(audio_output)

python infer.py --model-name "maitrix-org/Voila-base" --input-audio "test.mp3" --task-type chat_aiao
③ 文本输入
python infer.py --model-name "maitrix-org/Voila-chat" --input-text "Hello" --task-type chat_tito
④ 角色定制
python infer.py --model-name "maitrix-org/Voila-chat" --input-text "Speak as a cheerful guide" --task-type chat_tito
⑤ 在线Web界面
python gradio_demo.py
