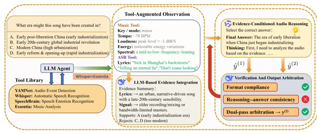
INTERSPEECH 2026 | 天津大学认知计算与应用重点实验室 9 篇录用论文分享

分享天津大学认知计算与应用重点实验室9篇论文被INTERSPEECH 2026 录用的论文。本次录用工作覆盖大音频语言模型、音频推理智能体、阿尔茨海默病语音检测、鲁棒说话人验证、上下文表现力语音评估以及自监督语音表征学习等方向。 ⏩1. M…
24 0 0

分享天津大学认知计算与应用重点实验室9篇论文被INTERSPEECH 2026 录用的论文。本次录用工作覆盖大音频语言模型、音频推理智能体、阿尔茨海默病语音检测、鲁棒说话人验证、上下文表现力语音评估以及自监督语音表征学习等方向。 ⏩1. M…
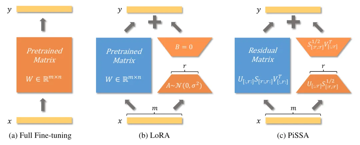
近年来,以 Whisper 为代表的语音基础模型显著提升了多语种自动语音识别(Automatic Speech Recognition, ASR)的泛化能力,使同一模型能够覆盖多种语言、口音和语音场景。然而,当模型需要继续适配低资源语言、儿…
在安静环境里,语音识别的问题很直接:用户说什么,模型就转录什么。但在会议、车内或咖啡厅里,用户的声音经常会和旁人交谈一起进入麦克风。 假设用户说“打开导航”,旁边的人同时说“我们明天几点出发”。一种常见错误不是把“导航”识别成别的词,而是把…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. SpeechGym: An Aud…
很多人第一次遇到语音识别的"幻觉",是在一段几乎没有人声的录音里。 会议散场后忘了关录音,最后十分钟只有空调声和收拾东西的动静。转写结果却工整地写着一句:"谢谢观看,请点赞订阅。" 没有人说过这句话。模型也不是听错了某个字,而是凭空写出了一…
今日论文合集:CS.SD语音与音频 | 共 8 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Domain-Adaptive A…
今日论文合集:CS.SD语音与音频 | 共 4 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. EXAM$^2$: $\under…
今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Multi-Task Learn…
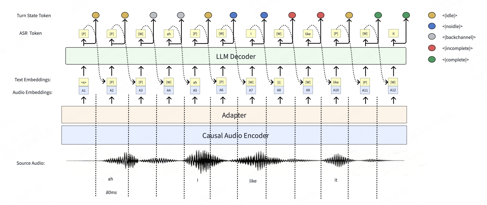
你有没有过这种体验:跟语音助手说话,刚停半秒,它就抢着回——其实你只是喘了口气; 或者你已经说完了,它还在干等,场面一度很尴尬。 这些「接话时机」问题,本质不是 ASR 认不清字,而是系统不会判断: 用户是说完了,还是话还没说完? 这句「嗯…
今日论文合集:CS.SD语音与音频 | 共 3 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Towards Quantifyi…
