
 语音小管家
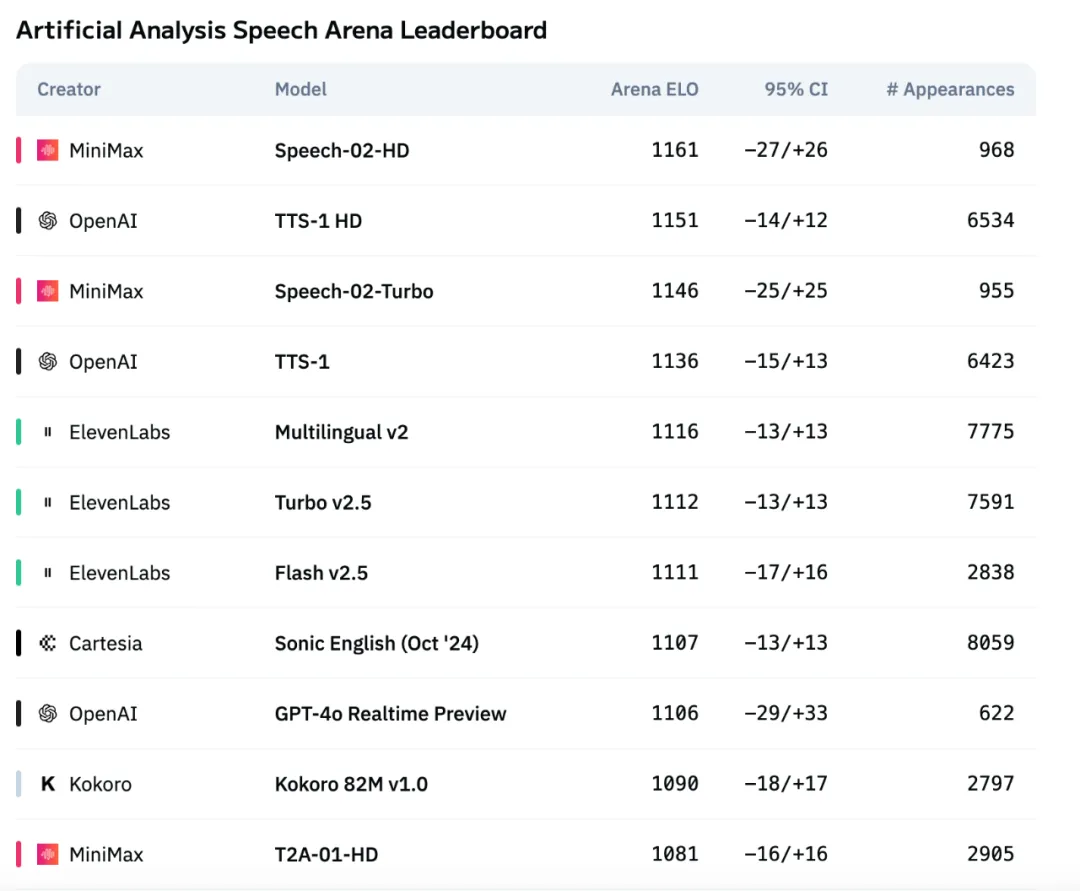
最近,TTS 模型又有重磅“上新”,Speech-02语音模型一出手,就将 OpenAI、ElevenLabs 甩在了后面,登顶 Arena 榜单,成为全球第一。
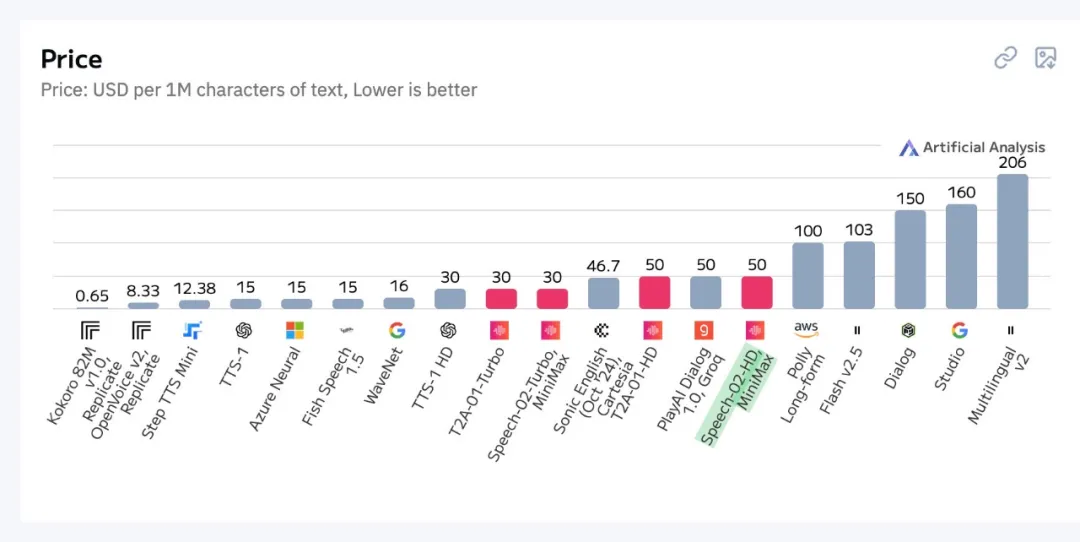
性能更强之外,Speech-02 还极具性价比,成本仅为 ElevenLabs 竞品模型(multilingual_v2)的 1/4。
技术创新
在Artificial Analysis Speech Arena Leaderboard上,Speech-02 模型的 ELO 评分是 1161,力压 OpenAI、ElevenLabs 旗下的一众模型。Arena 榜单的 ELO 评分,是根据用户在听取并比较不同模型的语音样本时,做出的主观偏好判断得出的。这也意味着,与其他行业领先的语音模型相比,用户明显更偏好 Speech-02。
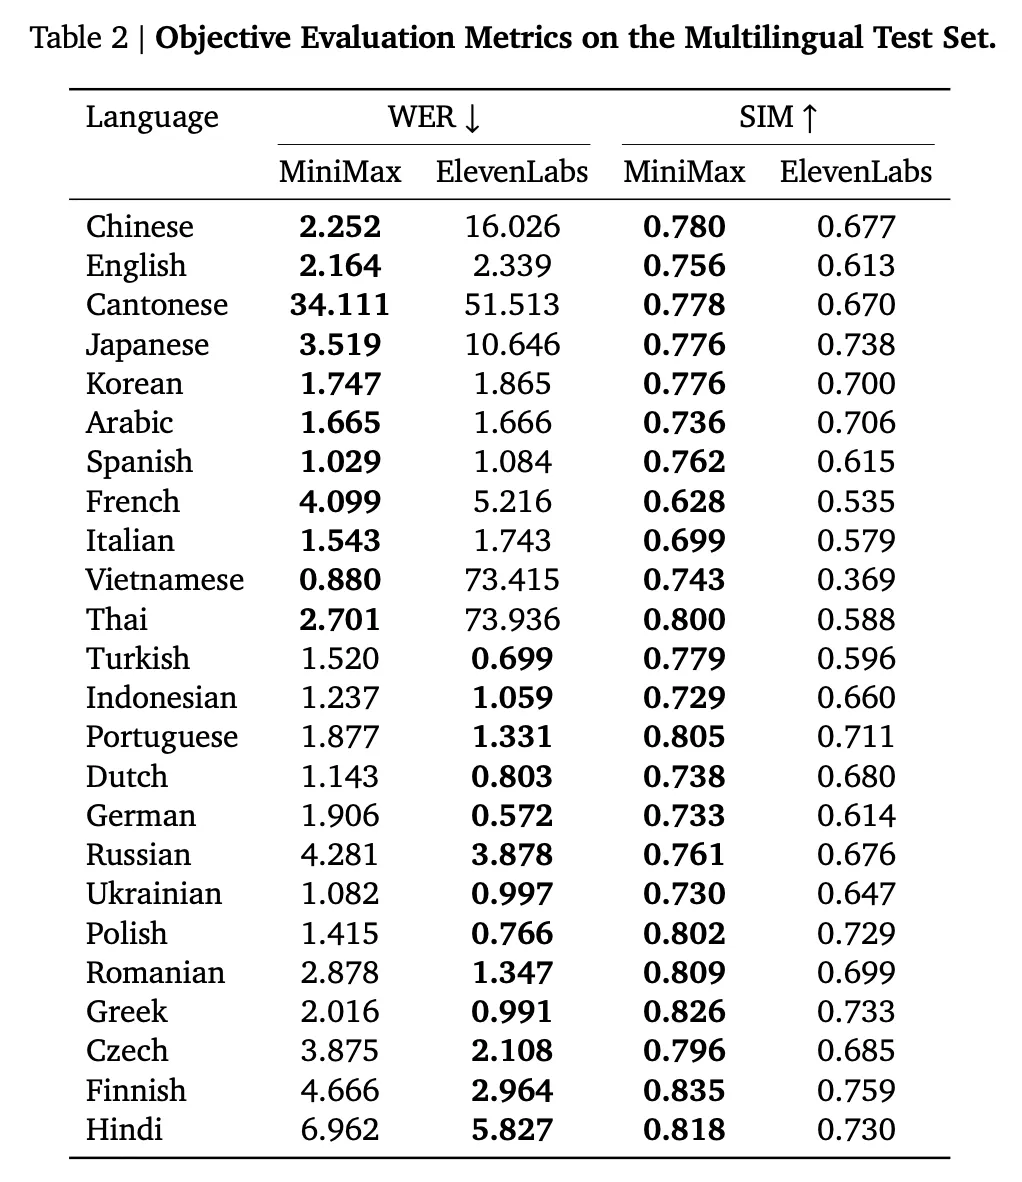
其中,字错率是衡量语音识别系统性能的一个重要指标,通过将语音识别系统输出的文本,与人工标注的参考文本进行对比,计算识别结果中错误的词数占参考文本总词数的比例。字错率越低,意味着语音识别系统的性能越好,识别准确率越高。
在字错率方面,Speech-02 在英语、阿拉伯语、西班牙语、土耳其语等多种语言处理中,与 ElevenLabs 打得有来有回,差距不大。但在中文、粤语、日语、韩语方面,明显优于 ElevenLabs。尤其是在中文语言环境中,凭借本土化优势,Speech-02 的中文和粤语字错率仅为 2.252%、34.111%,ElevenLabs 在这两项的字错率则分别为 16.026%、51.513%。
相似度则是语音复刻场景中的一个重要指标,用于衡量语音复刻结果与目标语音之间的相似程度。数值越接近 1,表明相似度越高,复刻效果越好,更能准确地还原目标语音的特征。
在相似度方面,Speech-02 全面优于 ElevenLabs。也就是说,Speech-02 模型在这 24 种评估语⾔中,⽣成的克隆语⾳更接近真实⼈声。
这些技术优势带来更直观的效果,体现在模型在实际应用中的表现上。总体来看,Speech-02 具有三大特点:
超拟人:错误率低且稳定,情绪、音色、口音、停顿、韵律等方面表现与真人无异;
个性化:支持声音参考与文生音,是业内首个实现“任意音色,灵活控制”的模型;
多样性:支持 32 种语言,能够在同一段语音里,实现多个语种间的自如切换。
给 TTS 模型提供新解法
在架构层面,Speech-02 在 VAE(变分自编码器)的基础上,创新性地提出了 Flow-VAE 架构。该架构显著优于 VAE。其独特之处在于,引入了一个流匹配模型,能够通过一系列可逆映射,灵活地转换潜在空间。这种融合解决方案可谓是“强强联合”——不仅充分利用了 VAE 对数据的初始建模能力,还借助了流模型对复杂分布的准确拟合能力,使得模型能够更好地捕捉数据中的复杂结构和分布特征。
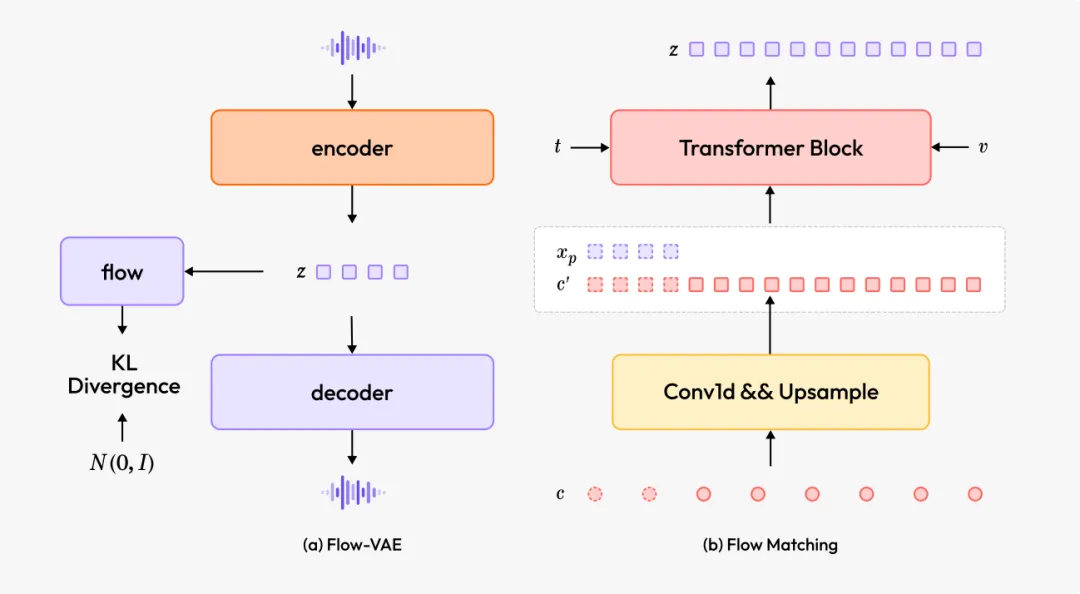
据介绍,该流匹配模型采用 Transformer 架构,通过 KL 散度作为约束,对编码器 - 解码器模块进行优化,让潜在分布变得更加紧凑且易于预测。与之相比,传统的流匹配模型大都是在“走弯路”:先预测梅尔频谱图,再由声码器将其转换为音频波形。在这个过程中,梅尔频谱图很可能会成为信息瓶颈,限制最终语音质量。而 Speech-02 的流匹配模型能直接模拟从音频训练的编码器 - 解码器模块中,提取的连续语音特征(潜在特征)分布,类似于“抄近道”,避免了信息瓶颈的问题。
在一些测试集的评估中,Flow-VAE 与 VAE 相比,实现了全面领先。
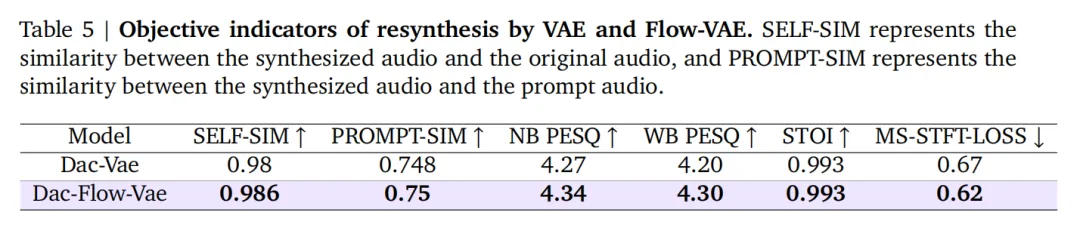
以声码器重合成维度的测试为例,通过比较 Flow-VAE 和 VAE 的波形重建能力,并在多个维度上将合成的音频与原始音频进行比较,来计算评估指标。最终结果表明,在所有评估指标上,Flow-VAE 模型相较于 VAE 模型均展现出显著优势。
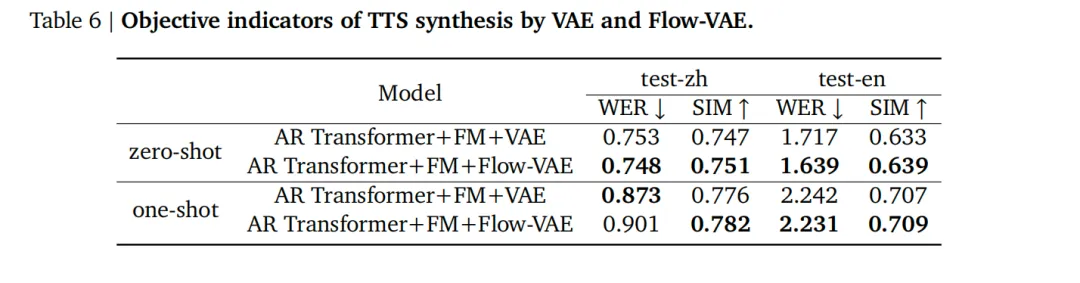
而在 TTS 合成方面,按照 Seed-TTS 的字错率(WER)和相似度(SIM)评估方法,技术团队在两种推理设置下生成了测试数据:零样本和单样本。最终测试数据表明,与 VAE 模型相比,Flow-VAE 在字错率、相似度指标上都具有显著优势。
