
 语音小管家
在语音合成(Text-to-Speech, TTS)领域,传统的 TTS 系统主要包括自回归(Autoregressive, AR)模型、非自回归(Non-Autoregressive, NAR)模型以及结合两者优点的混合范式(AR+NAR)。近年来,随着大语言模型(Large Language Models, LLMs)的发展,出现了新的范式,代表了语音合成技术的最新趋势。
近期,一种新的范式——“Decoder Only”语音生成逐渐崭露头角。这种范式直接通过解码器生成目标输出序列,从而简化了模型架构并提升了效率。然而,现有的Decoder Only模型在处理语音合成任务时,仍面临一些挑战,例如如何在低比特率下高效表征语音信号,以及如何实现对语音的细粒度控制。
本期介绍的Spark-TTS,正是基于Decoder Only范式的一次重大突破。它通过引入一种新型的单流语音编解码器(BiCodec)和大语言模型(LLM),实现了高效的零样本语音合成,并在粗粒度和细粒度控制方面表现出色。接下来,我们将深入解析Spark-TTS的核心技术及其创新点。
标题:Spark-TTS: An Efficient LLM-Based Text-to-Speech Model with Single-Stream Decoupled Speech Tokens
作者:Xinsheng Wang, Mingqi Jiang, Ziyang Ma, 等
项目地址:
研究背景
语音合成(Text-to-Speech, TTS)技术近年来取得了显著进展,尤其是在零样本语音合成领域。然而,现有的基础模型通常依赖多阶段处理或复杂的架构来预测多个码本,这限制了效率和灵活性。此外,现有系统在生成具有精确特性的新音色方面能力有限,尤其是在细粒度控制(如音高和语速)方面。为了解决这些问题,Spark-TTS使用了一个基于单流语音编解码器(BiCodec)的高效模型,能够实现零样本语音合成,并支持粗粒度和细粒度的声音控制。
研究方法
研究者提出了一个名为 BiCodec 的新型语音编解码器,它将语音分解为两种互补的令牌类型:低比特率的语义令牌(负责语言内容)和固定长度的全局令牌(负责说话人的属性)。通过这种分离表示,结合大语言模型(LLM)Qwen2.5 和链式思考(CoT)生成方法,Spark-TTS 能够同时实现粗粒度(如性别、说话风格)和细粒度(如精确音高值、语速)的语音控制。
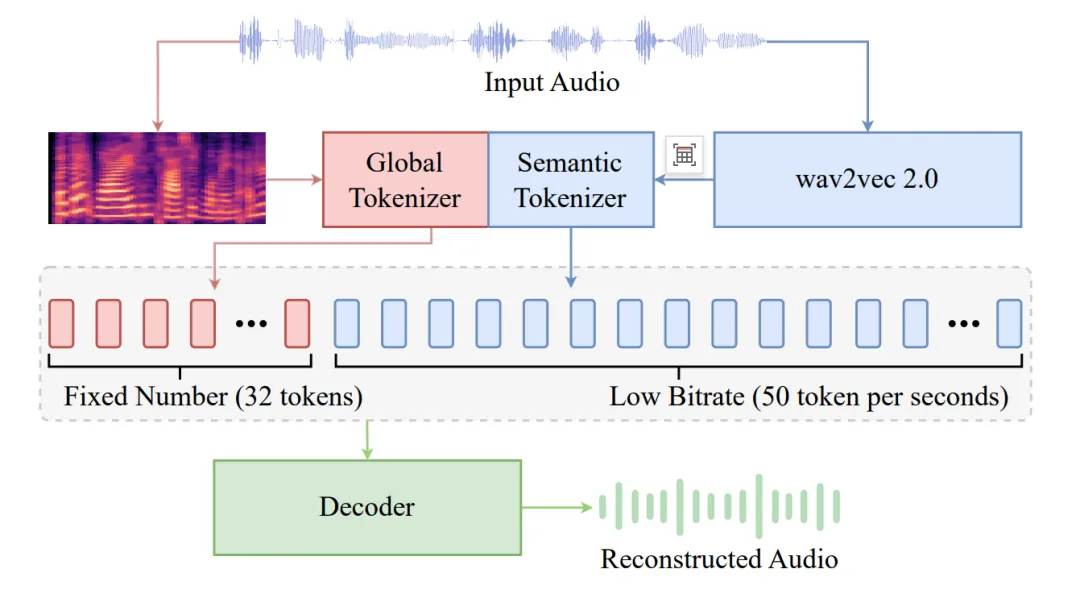
图1:BiCodec 模型结构
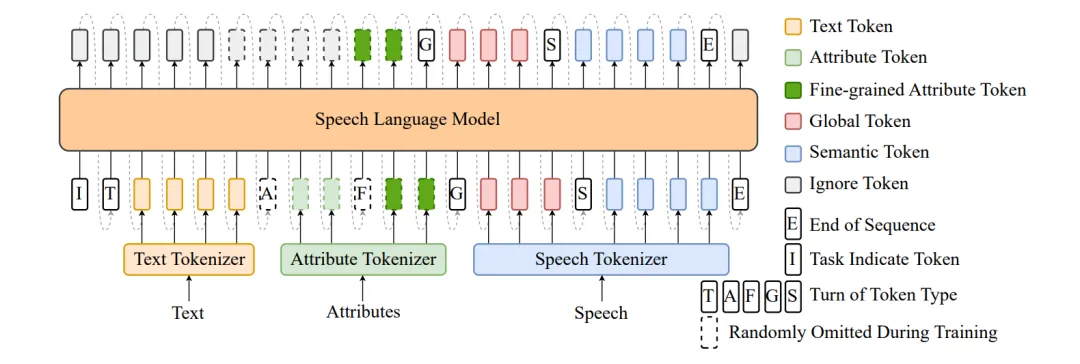
图2:Spark TTS模型结构和范式
为了支持可控语音合成的研究,研究者还构建了一个名为 VoxBox 的高质量开源数据集,包含10万小时的语音数据,并提供了全面的属性标注(如性别、音高、语速等)。
研究结果
1. BiCodec 的性能:BiCodec 在低比特率(<1 kbps)范围内实现了最佳性能,在大多数指标上超越了现有方法。在语音重建质量方面,BiCodec 的语义令牌从 wav2vec 2.0 提取,比直接处理波形的编解码器具有更强的语义一致性。
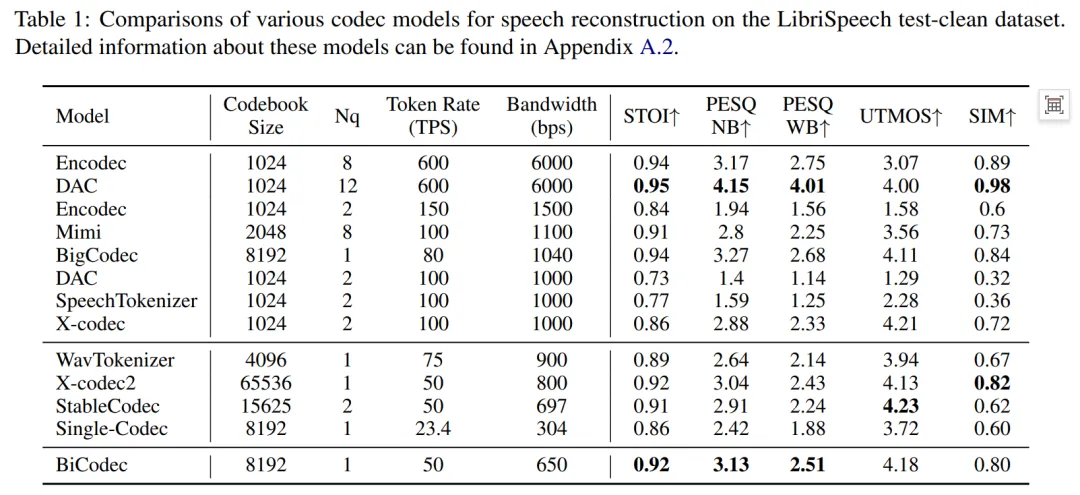
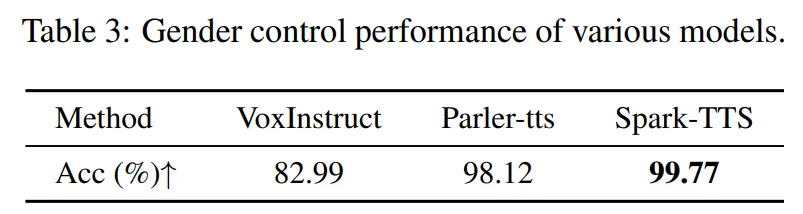
2. Spark-TTS 的可控性:Spark-TTS 在性别、音高和语速的控制方面表现出色。例如,在性别控制实验中,Spark-TTS 的准确率达到了99.77%,显著优于其他可控语音合成模型。
3. 零样本语音合成:在零样本语音合成任务中,Spark-TTS 在语音可理解性方面表现出色。例如,在中文和英文的测试中,Spark-TTS 的字符错误率(CER)和词错误率(WER)均优于大多数现有模型,仅略逊于一些封闭源代码模型。
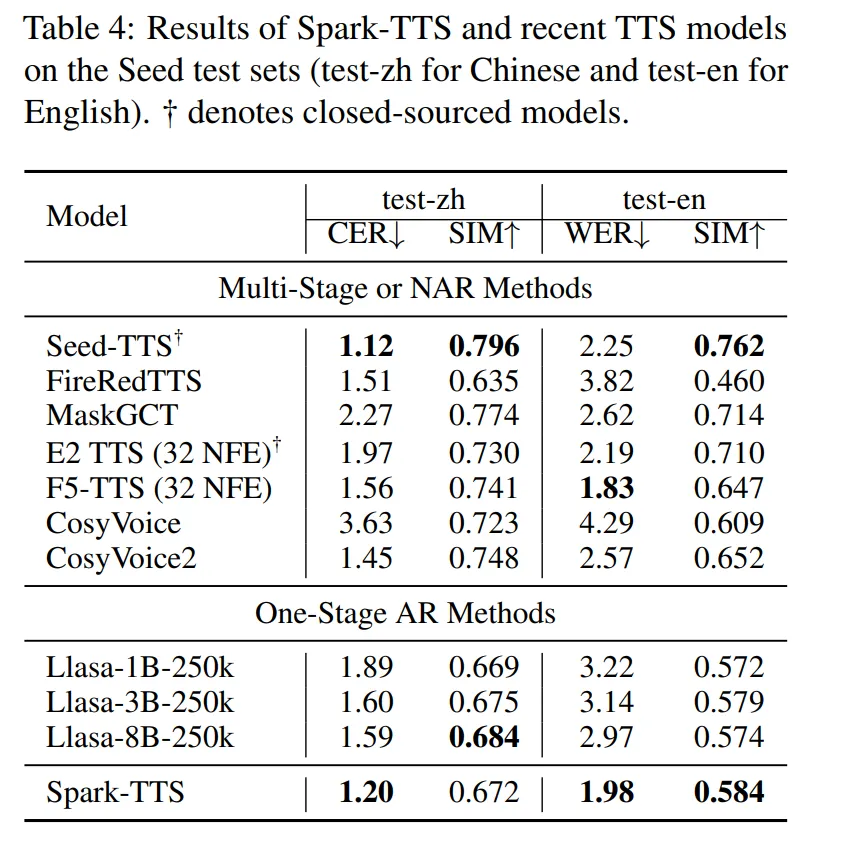
4.语音质量:在语音质量评估中,Spark-TTS 生成的语音质量显著高于现有方法,甚至超过了多阶段建模的开源语音合成模型CosyVoice2。
研究意义
1. 理论意义:
Spark-TTS 提出的 BiCodec 编解码器和链式思考生成方法为语音合成领域提供了一种新的技术范式,显著简化了模型架构,同时提升了语音生成的灵活性和可控性。
2. 现实意义:Spark-TTS 的零样本语音合成能力和细粒度控制能力使其在实际应用中具有广泛潜力,例如个性化语音助手、语音内容创作等。此外,VoxBox 数据集的开源为语音合成研究提供了一个高质量的基准资源,有助于推动整个领域的发展。
3. 未来启示:该研究为未来语音合成技术的发展提供了重要方向,例如如何进一步提升语音生成的自然度和相似度,以及如何在细粒度控制方面实现更复杂的语音特性(如情感和语调)。
思考与讨论
Spark-TTS 在零样本语音合成中表现出的说话人相似度较低,如何进一步提升语音生成的自然度和相似度?
如何在细粒度控制中实现更复杂的声音特性(如情感表达)?
