语音小管家
背景介绍
语音情感识别(Speech Emotion Recognition, SER)是一项利用人工智能技术识别语音中情绪状态的前沿技术。该技术广泛应用于语音助手、客户服务、医疗健康等多个领域。已有研究指出,语音情感识别在提升用户体验与个性化服务方面具有重要意义。
虽然目前已有一些将元数据设计成辅助任务用于多任务学习框架下提升情感识别的方法,但是仍然存在两个问题。其一,辅助任务的质量不佳时,会削弱主任务的性能表现;其二,辅助任务较多时,模型可能因处理高维信息的能力不足而表现不佳。此外,目前常见的简单多任务融合方法(如加权求和)往往难以充分利用辅助信息,限制了整体模型的提升幅度。
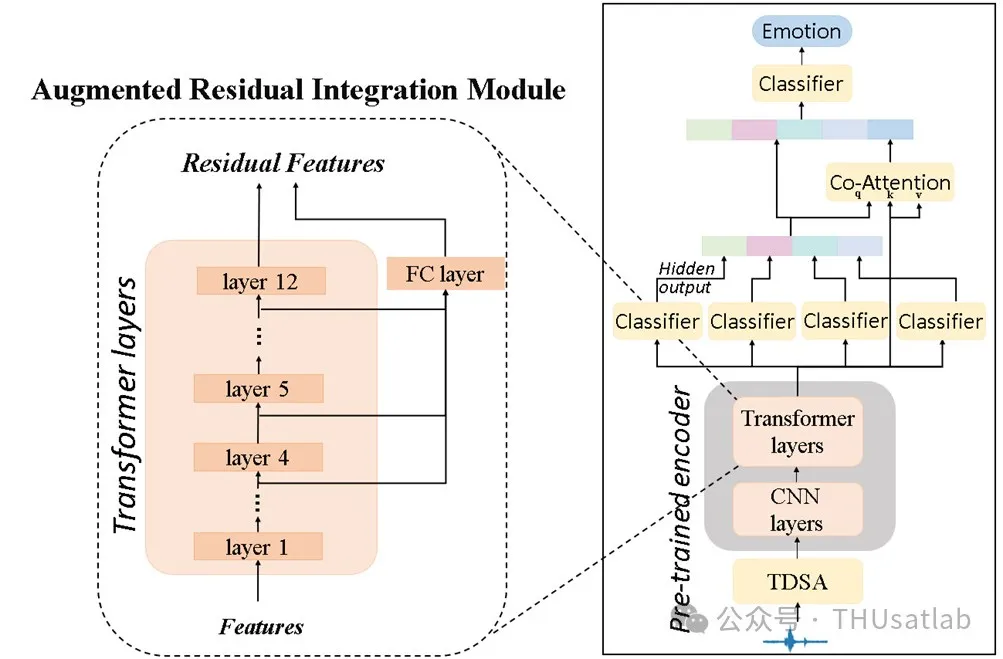
在本文中,在多任务学习两阶段微调的框架下,我们通过提出增强残差集成(Augmented Residual Integration, ARI)模块和引入协同注意力(Co-attention)模块解决对应上述问题,有效提升了情感识别的准确率。
工作原理
实验结果
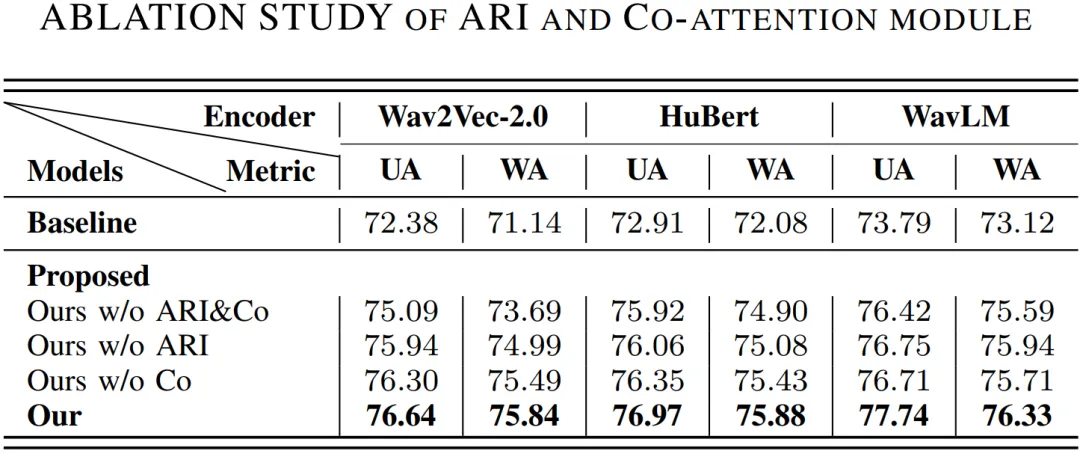
针对增强残差集成模块和协同注意力模块的消融实验证明了两模块对模型表现的正向贡献。其次,在两模块同时被加入时,模型性能进一步提升,验证了两模块相辅相成的作用。
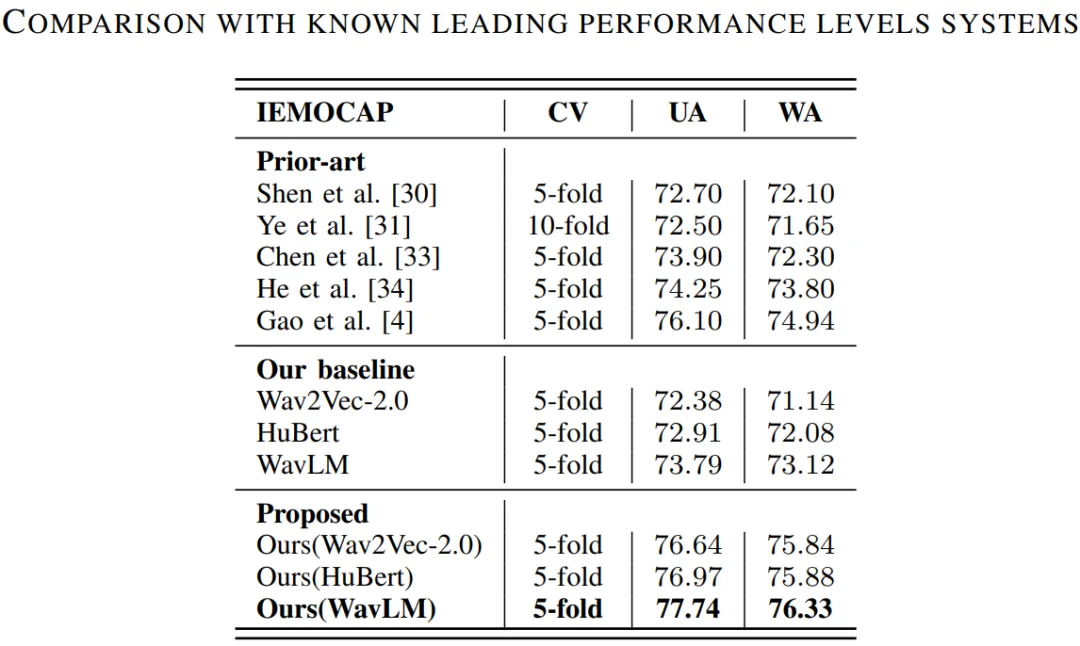
在IEMOCAP数据集上,采用说话人独立(Speaker-Independent)和仅使用基础自监督预训练模型编码器的条件下,我们的模型在不同基础模型上均优于已有性能最好的模型,证明了方法的有效性。
结 论
在本文中,我们提出了一种利用元数据提升语音情感识别准确率的方法。研究表明,增强残差集成模块在特征选择方面表现出色,能够从元数据中选择性地保留更高质量、更多样化的辅助信息。协同注意力模块则擅长利用多维信息以及基于元数据的辅助任务之间的上下文关系。增强残差集成与协同注意力模块在多维度信息的保留与利用上相辅相成,为基于Transformer的自监督预训练模型在语音情感识别任务中,提供了一种提升表现的新思路。