
 语音小管家
SongEval:首个歌曲美学评价数据集
行业痛点:音乐生成的「最后一公里」
指标失真
现有客观指标(梅尔谱失真、音高准确度、嵌入距离)只能衡量信号层面或结构层面的“对不对”,却无法回答听众更关心的“好不好听”。
主观数据稀缺
语音合成领域已有几百上千小时 MOS(Mean Opinion Score)标注集,可音乐的美学主观标注数据却寥寥无几。缺少大规模、专业、可公开的主观评价,模型就学不会「审美」。
歌曲维度多且主观
歌曲包含旋律、伴奏、人声演唱、情感、结构……评价维度复杂、交互强,想获得专业意见更难。
SongEval 正是为了解决这些核心痛点而生。
数据采集:两阶段生成 + 自动过滤
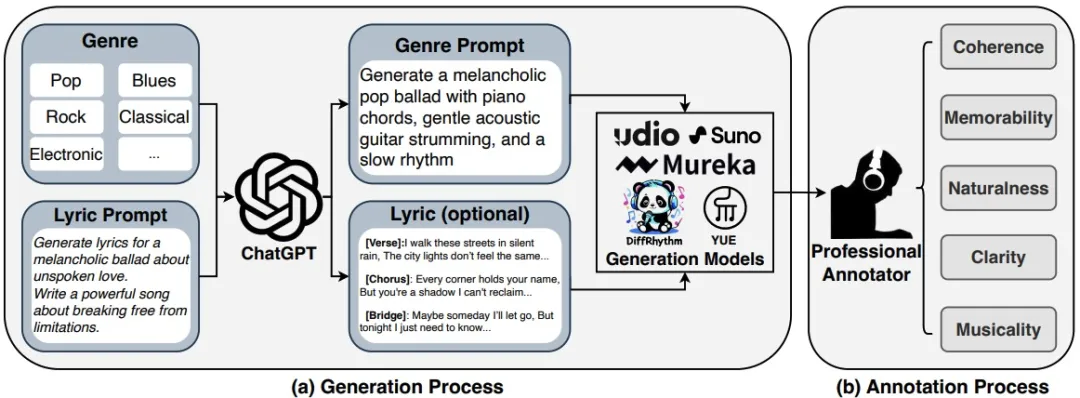
用 ChatGPT 造「歌词 & 风格」素材
覆盖 9 大主流曲风:Pop、Rock、Blues、电子、嘻哈、乡村、爵士、古典、世界音乐。
生成「流派prompt+ 歌词」对,语言同时支持中文和英文,保证文化多样性与内容多元化。
五款主流模型「接单写歌」
DiffRhythm、Suno、Udio、YUE、Mureka—— 主流的代表性系统负责把 Prompt 变成完整歌曲(人声 + 伴奏)。
为防止“模型 bias”导致数据单调,论文专门挑选了不同架构的系统:从商业 API(Suno、Udio、Mureka)到学术界模型(DiffRhythm、YUE)。
质量保障:Vocal Range 筛选质量生成低的歌曲
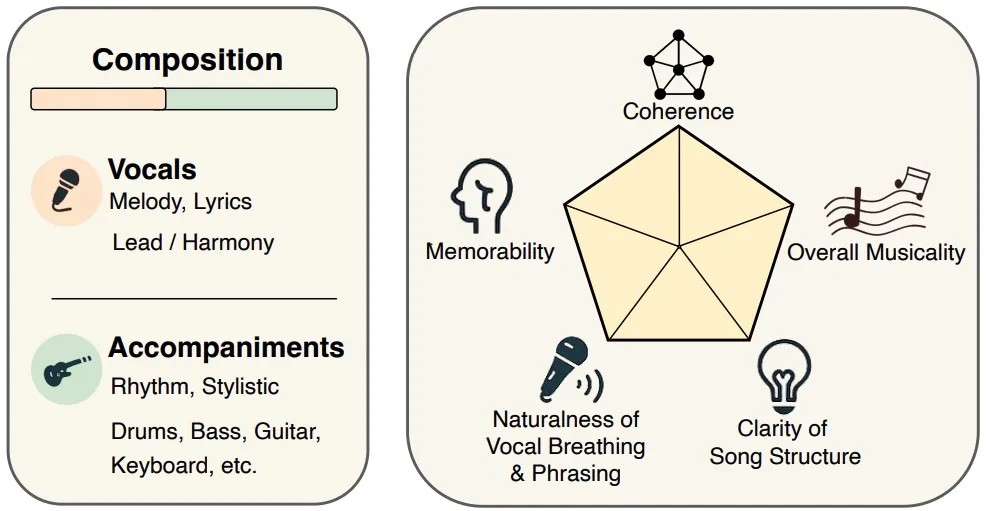
专家标注体系:五维美学雷达
在 SongEval 里,每一首歌都会被4位具备正规音乐教育背景的评委逐条打分,分值 1~5 分。评委们依据的是「五维美学雷达」——五条既独立又有关联的审美刻度。下面用通俗的话把这套体系拆开讲清楚。
整体连贯性(Coherence):音乐各段落(前奏、主歌、副歌、桥段、结尾等)之间的衔接流畅性及动态、情感的统一性。
记忆点(Memorability):是否有一个使人听一遍就能记住的要素,可以是旋律/节奏型等
演唱气口合理性(Naturalness):演唱中呼吸、断句的合理性,包括歌词断句是否符合语义逻辑和节奏韵律,呼吸是否影响演唱流畅性。
歌曲结构清晰度(Clarity):歌曲段落划分(主歌、副歌、桥段等)的明确性及结构设计的逻辑性(如传统结构或创新结构的合理性)。
整体音乐性(Musicality):从听感角度评估音乐的综合愉悦度,包括旋律、和声、配器、人声与伴奏融合度的自然性与和谐性。
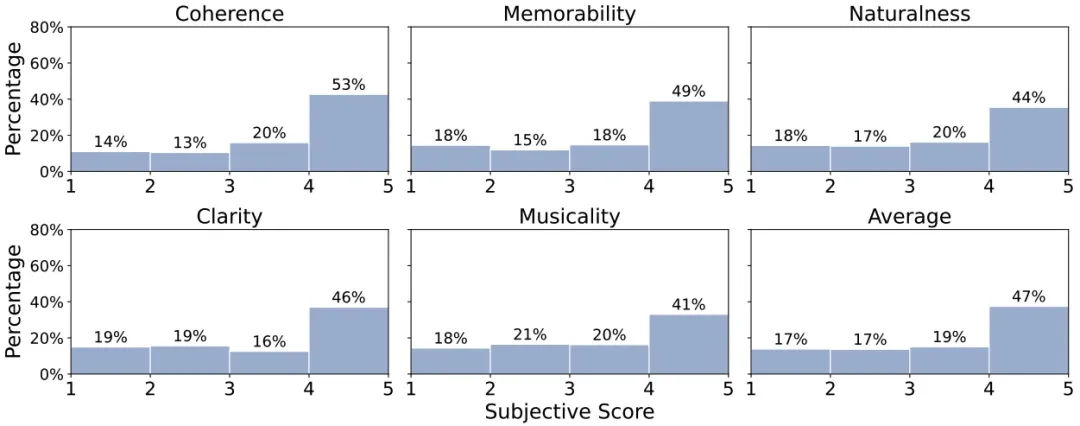
数据特征:140 小时 - 2399 首 - 中英双语
体量:2399 首完整歌曲,总时长超过140 小时
语言分布:中文 48 % vs 英文 52 %。
性别时长比:男声 60 % / 女声 40 %
曲长分布:中文&英文都集中在 2–6 分钟,个别英文歌延伸到 8 分钟。
这些特征确保了:曲风多样、语言多元、性别均衡、长度多样—— 让模型学到真正“耐听”的审美规律。
论文原文请参考:https://arxiv.org/abs/2505.10793
Diffrhythm v1.2:更稳健、更丰富、更精细、更灵活
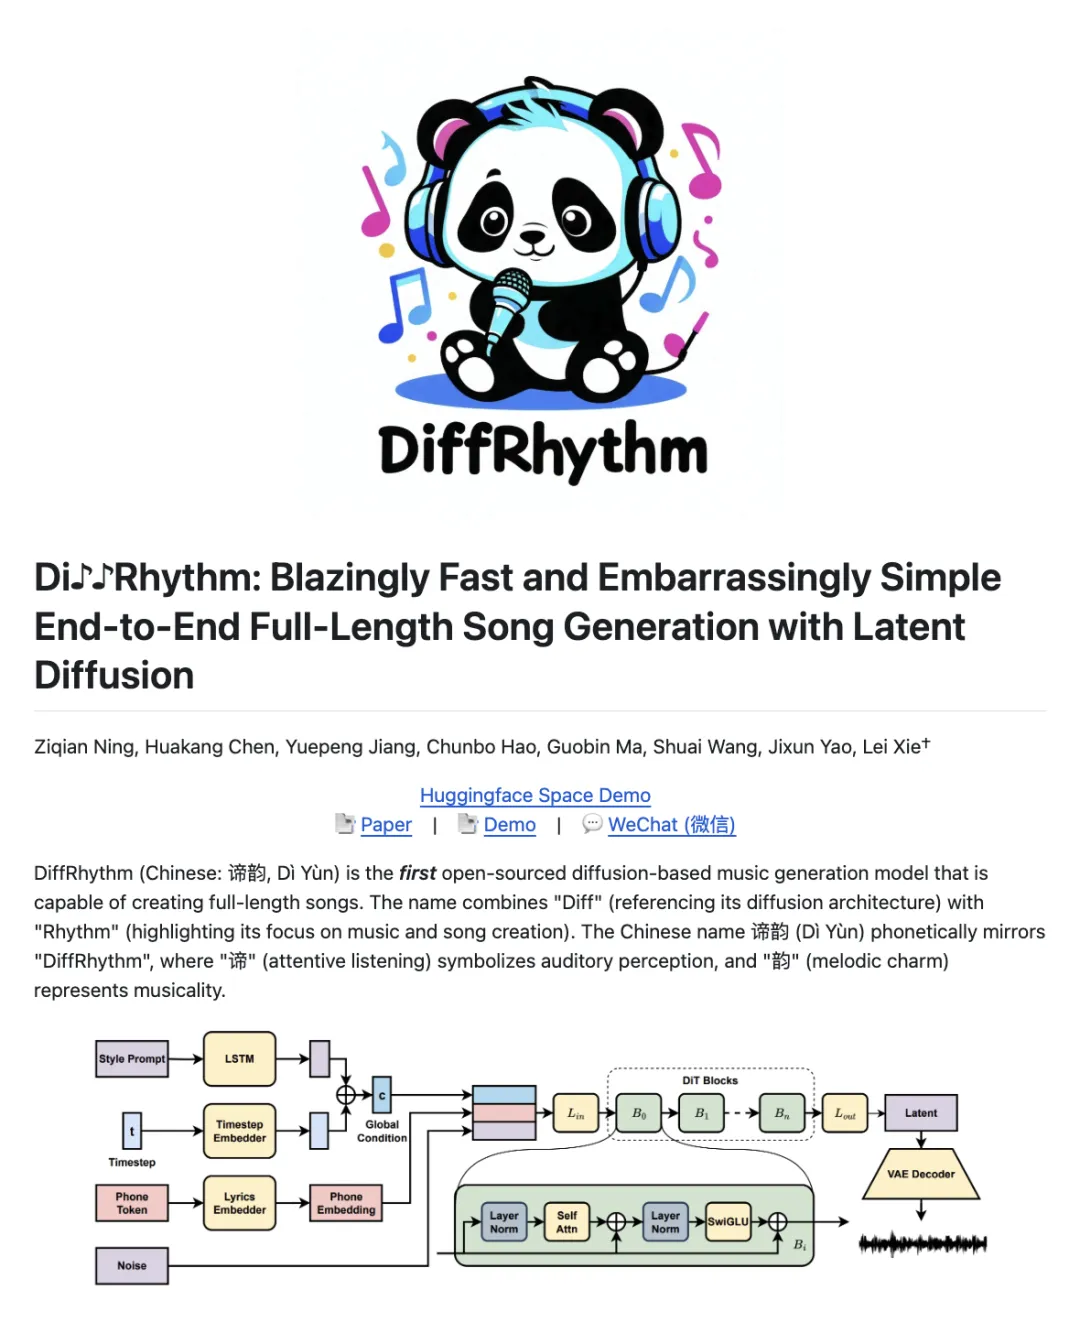
实验室在2个月前发布了基于扩散模型的全曲生成模型DiffRhythm(谛韵),能够在短短 10 秒内生成长达 4 分 45 秒的完整歌曲,包含人声和伴奏,多种灵活的音乐生成方式。模型和推理代码全部开源后,短短几天位列Hugging Face Space 趋势榜第一,受到众多网友和音乐爱好者广泛好评。当前Github Star数超过1.6K。近期DiffRhythm迎来了升级。
更稳健:显著降低重复与漏字
在 DiffRhythm 1.2 中,我们修复了 v1 版本的 Mask 逻辑缺陷,有效减少了歌词生成过程中的重复与漏字问题,合成结果更加自然、流畅。
更丰富:多样化编曲与创新演奏
训练数据从 4 万小时扩展至 7.5 万小时,涵盖更广泛的音乐风格、结构和演奏技法,模型能够自发生成多样的编曲结构和创新演奏方式。
更精细:SongEval 偏好优化
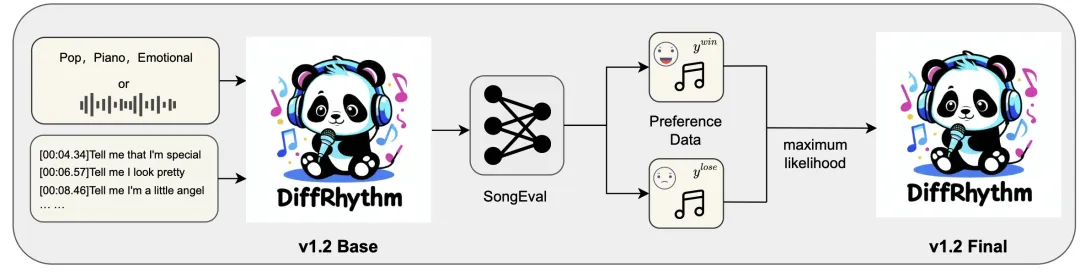
基于实验室SongEval 数据集,我们采用了DPO(Direct Preference Optimization)后训练策略,让模型在生成效果上更加贴近真实听感,音乐合成的质量与稳定性均有显著提升。
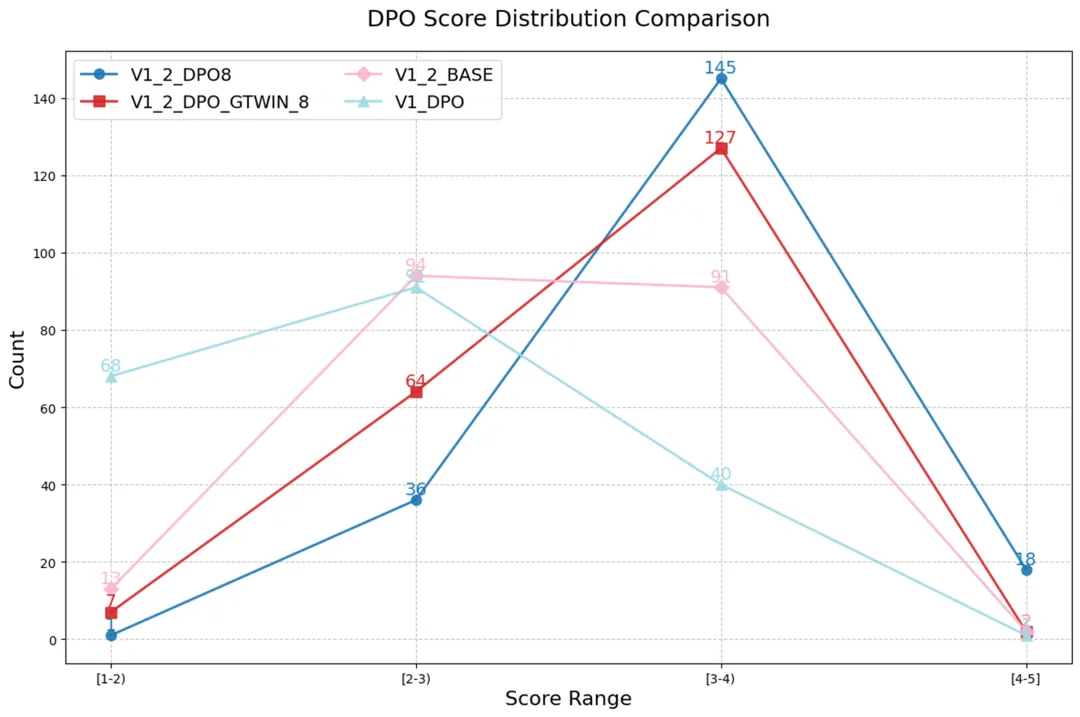
下图展示了不同模型在 DPO 评分上的分布情况。可以看到,经过 DPO 优化后的 V1_2_DPO8(模型生成的高分样本作为 Winner) 和 V1_2_DPO_Gtwin_8(Ground Truth 作为 Winner),显著提升了高分(3-4分区间)样本的占比,同时有效减少了低分区间(1-2分)的样本数量,说明模型整体听感和稳定性得到了明显优化。
更灵活:片段级编辑与续写
新引入扩散模型的 In-Context Learning(ICL)策略,使模型具备片段级的编辑和续写能力,支持对已有片段的灵活调整与扩展。
我们将持续推进 DiffRhythm 的研究与优化,欢迎感兴趣的同学、老师和同行关注与交流,也欢迎大家体验新版模型并提出宝贵意见。同时,我们也将在后续进一步推进基于 SongEval 数据集的音乐评估工具研发,为音乐生成与评价提供更加系统和客观的支撑。
Github:
DiffRhythm:https://github.com/ASLP-lab/DiffRhythm
SongEval:https://github.com/ASLP-lab/SongEval
HuggingFace:
