
 语音小管家
感知哈希(Perceptual Hashing,简称pHash)是一类将多媒体(图像、音频、视频等)转换为“感知相似的哈希值”的技术。它不同于传统的加密哈希(如 MD5、SHA-1),感知哈希的目标是:即使内容有细微变化(如压缩、裁剪、噪声、变速等),相似内容也能得到相似的哈希值。
感知哈希一般用于图像领域,为了使其可以用于音频去重,需要对原始音频数据进行处理,提前其对应的感知哈希,本文介绍的算法具体的步骤如下:
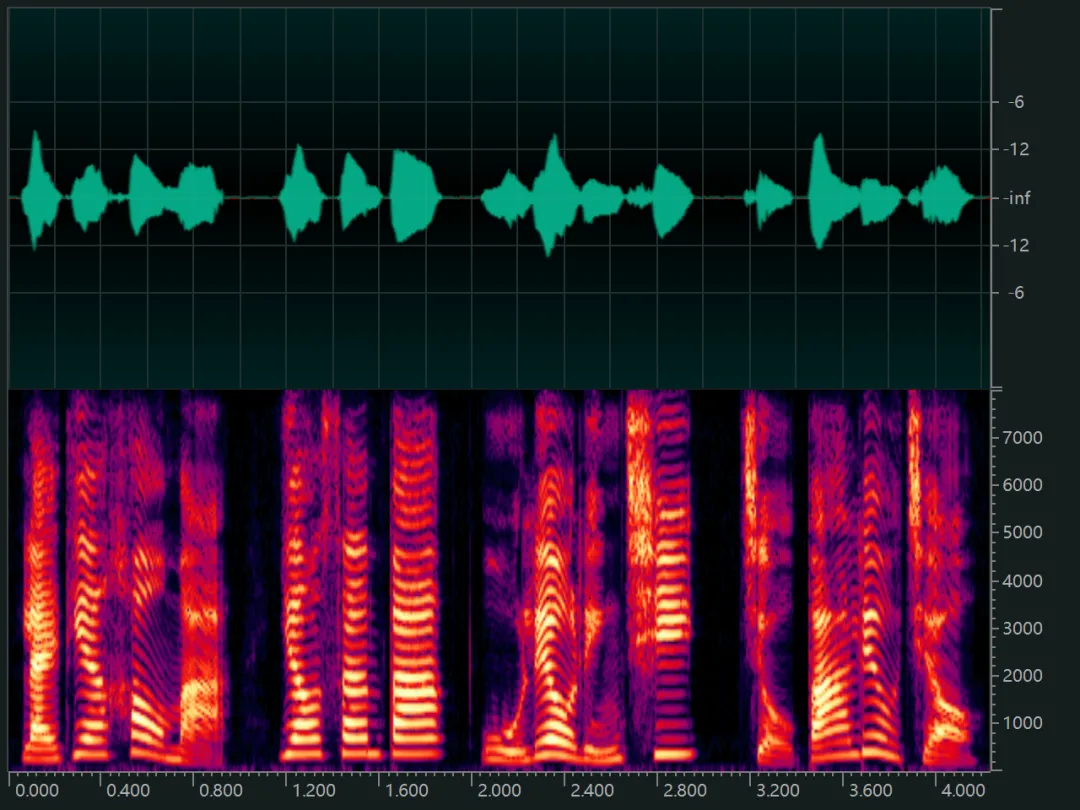
对音频进行分帧处理,对每一帧进行FFT计算
计算每一帧的频谱,并将频谱通过33 个 Bark 滤波器
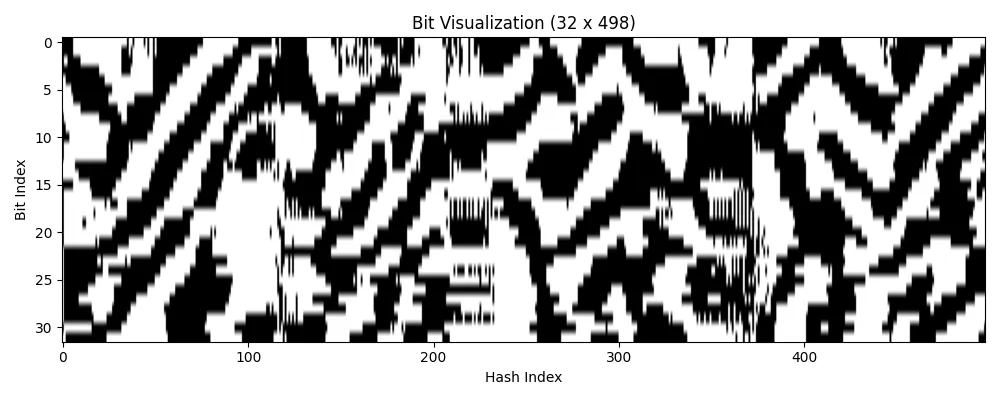
相邻 Bark 滤波器的差值变化量用于描述频谱形态变化,如果 H > 0,则当前 bit 为 1,否则为 0
每帧生成 32 位哈希(从 33 个 bark 中得到 32 个差值)
经过上述处理步骤,可以得到一个Nx32的hash矩阵,结果如下所示
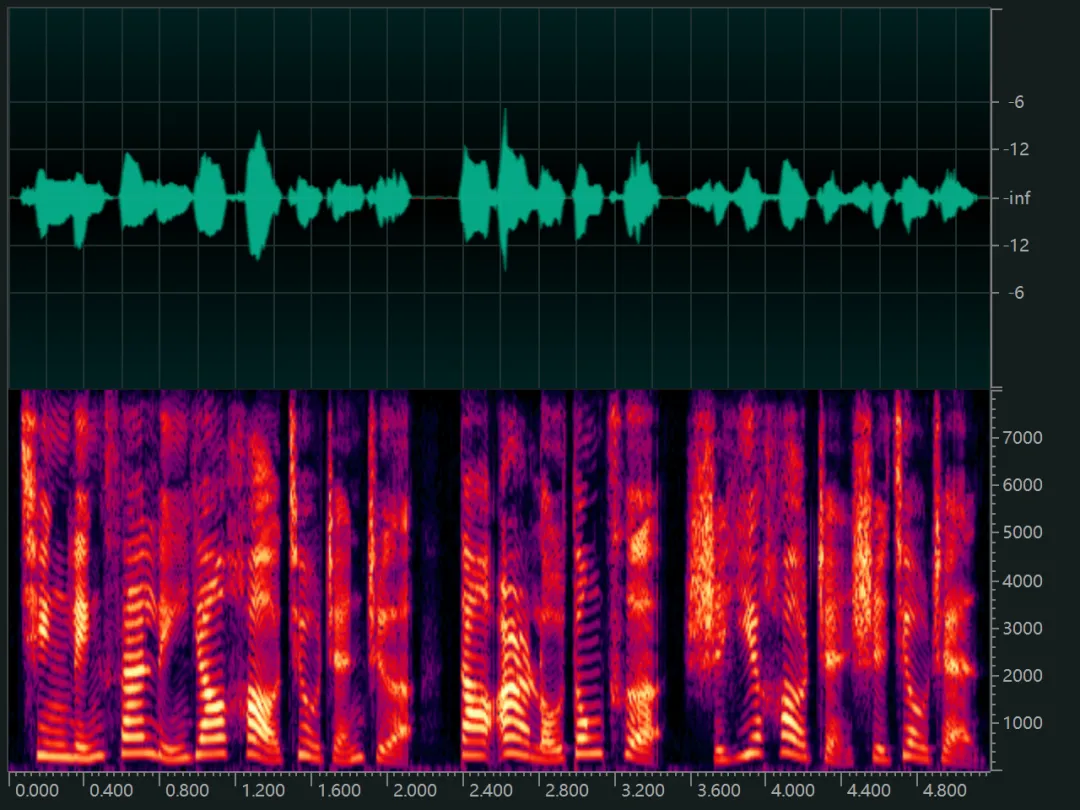
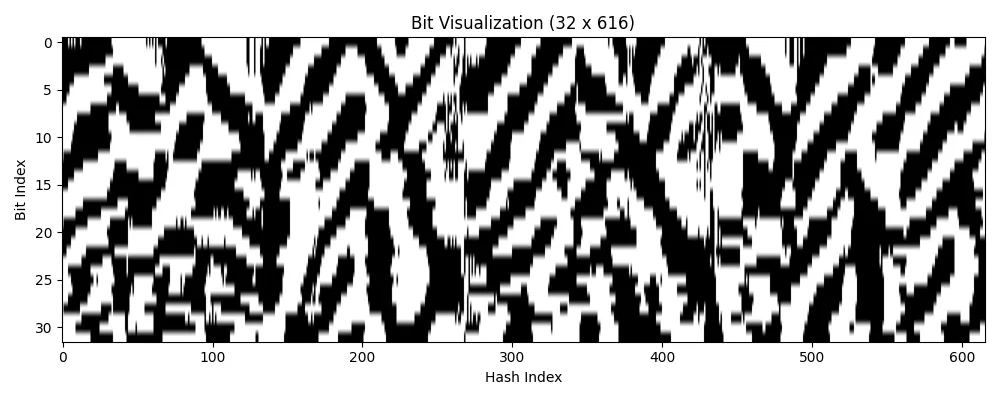
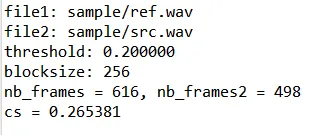
选择短的作为A,长的作为B,定义滑窗个数为Nb-Na+1 从 B 的每个偏移 i 开始,拿出长度为 A 的序列做对比;将对比序列划分为多个 block_size 大小的小段;每个块计算相似度,一般会采用SWAR加快计算速度
对每个滑窗,若距离 ≤
threshold,认为是匹配片段
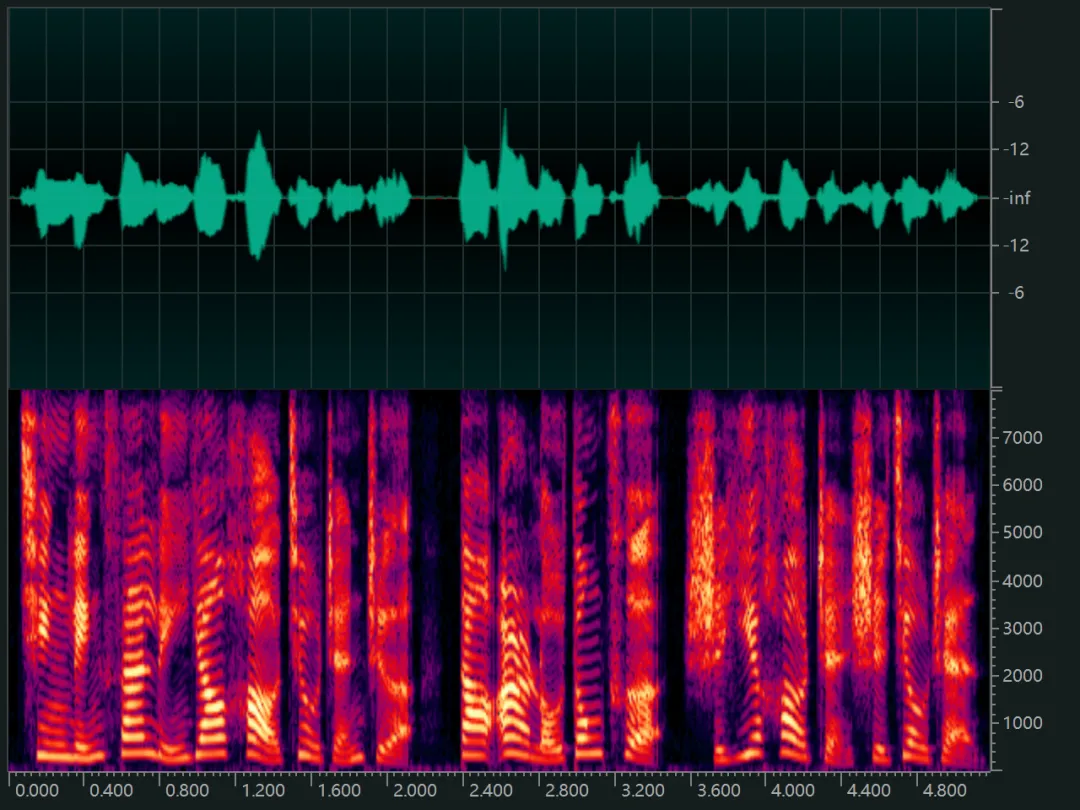
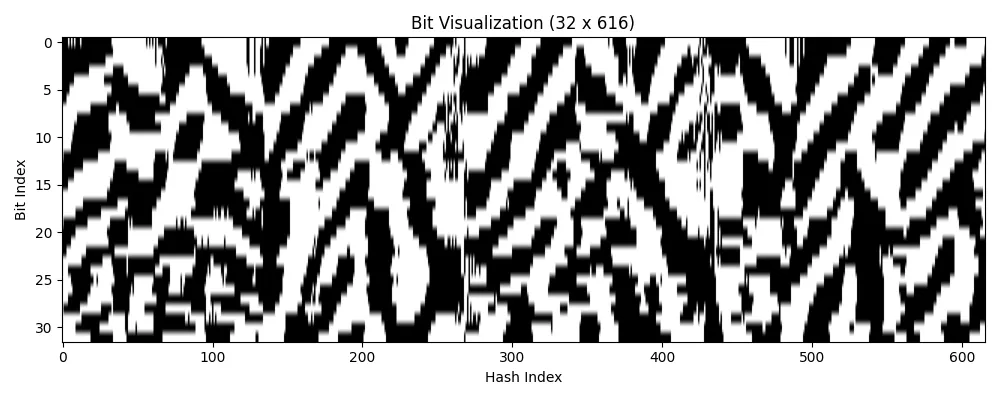
虽然是“感知”哈希,但其本质还是基于Bark频谱能量差分的结构化编码,仍容易受到注入:背景噪声变化(例如录音设备不同)淡化、回响、均衡器滤波等轻度后处理,小幅度剪辑(比如加了一个静音头或尾),这些都会导致哈希位的剧烈变化,使相似音频无法正确匹配
该算法是基于固定帧长、固定帧移的滑窗处理,对非线性时间变化不敏感
感知特征设计简单,未考虑语义内容,这意味着两个听起来相似但频谱不同的音频不会匹配成功(例如不同人说同一句话、不同乐器演奏同一旋律)
解决上述问题,可以采用更为鲁棒的学习型音频比对算法, 比如通过神经网络生成embedding,再进行相似度计算。
参考文献:[1].https://www.phash.org/docs/pubs/thesis_zauner.pdf
