
 语音小管家
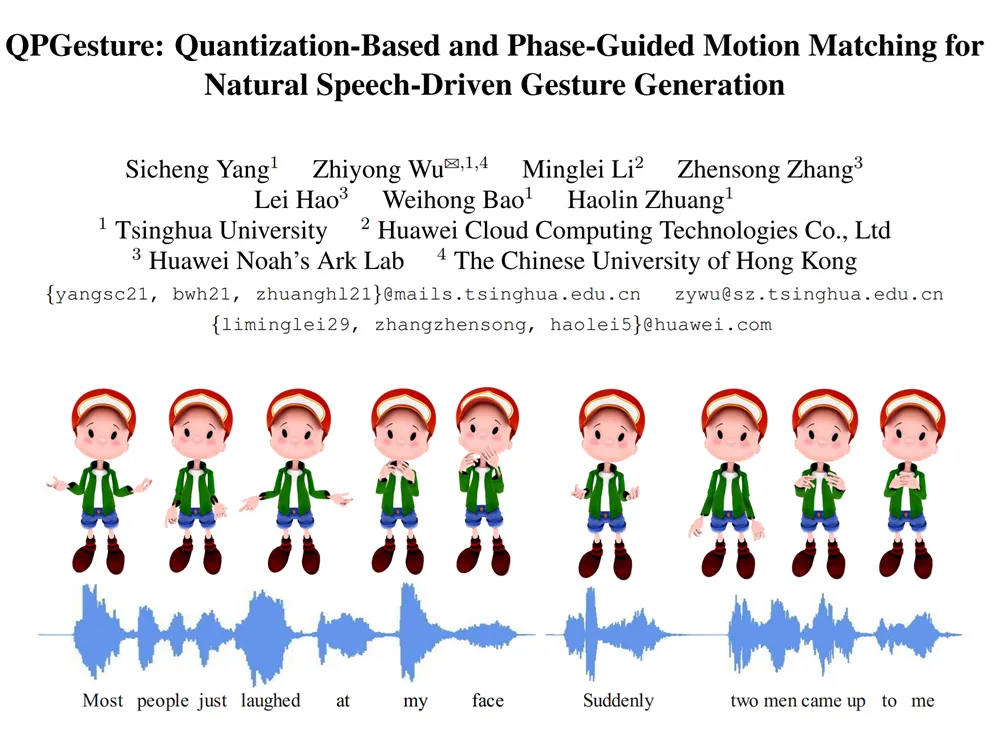
本文由清华大学与华为、香港中文大学合作,研究共语手势(co-speech gesture)的自动生成。语音驱动的手势生成因人类动作的随机抖动和语音与手势之间固有的异步关系而面临重大挑战。为应对这些问题,我们提出了一种新颖的基于量化和相位引导的动作匹配框架:QPGesture。
具体而言,该方法首先引入手势VQ-VAE模块,通过学习一个编码表来总结有意义的手势单元,有效缓解随机抖动问题。随后,利用基于音频量化的Levenshtein距离作为手势与语音对应关系的相似度度量,解决语音与手势的对齐问题。
此外,引入相位引导策略,根据上下文语义或音频节奏引导最优手势匹配,使生成的手势更加自然。大量实验结果表明,我们的方法在语音驱动的手势生成任务上优于近期的先进方法。
论文链接:https://ieeexplore.ieee.org/document/10204626
代码和模型开源:https://github.com/YoungSeng/QPGesture
背景介绍
随着人机交互技术飞速发展,非语言行为在传达信息中的作用愈发受到关注,包括面部表情、手势和身体动作等。语音驱动手势生成(Speech-Driven Gesture Generation)旨在通过分析人类语音生成相应的手势动作,以增强交流的自然性和表达的丰富性。然而,生成符合人类自然行为的手势仍然面临诸多挑战:
随机抖动问题:人们在讲话时常伴随小幅度的随机抖动和动作,这些细微的动作对手势生成的质量产生显著影响。
语音与手势的异步关系:人类的语音和手势之间存在固有的时间差异,这使得手势生成模型在对齐语音和手势时面临困难。
研究动机
现有的手势生成方法大多依赖于高维连续空间中的神经网络直接映射语音到3D关节序列,使用固定步长的滑动窗口进行生成。然而,这些方法在处理随机抖动和语音与手势的异步关系时表现不佳,导致生成的手势缺乏自然性和适宜性。为此,我们希望通过引入量化和相位引导的策略,提升手势生成的质量和自然度。
贡献
基于上述研究动机,本研究的主要贡献包括:
量化手势表示:提出手势VQ-VAE模块,通过离散化手势动作空间,减少随机抖动问题,提升手势生成的稳定性。
Levenshtein距离对齐:利用基于音频量化的Levenshtein距离作为语音与手势匹配的相似度度量,有效解决语音与手势的对齐问题。
相位引导策略:引入相位信息,根据上下文语义或音频节奏引导手势匹配,生成更加自然和协调的手势动作。
综合评估:通过大量实验和用户研究,验证了QPGesture在手势生成质量和自然性上的优越性。
研究方案
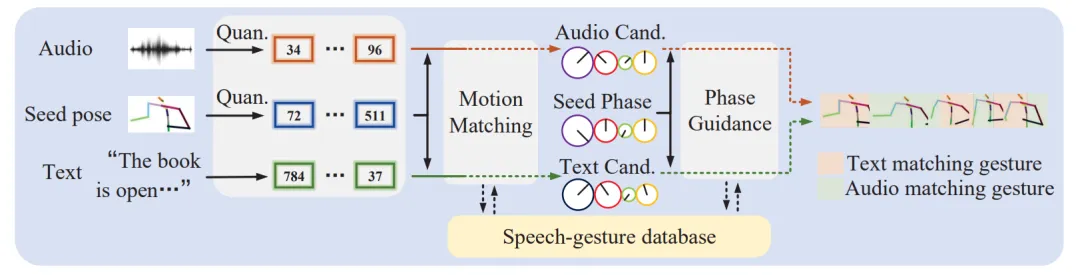
我们的方法以一段音频、对应的文本、初始姿势(seed pose)以及可选的一系列控制信号作为输入,输出一系列手势动作。首先,我们将这些输入以及手势数据库预处理成其量化的离散形式。然后,我们分别为语音和文本找到最佳的候选手势。最后,根据与初始姿势对应的相位以及与两个候选手势对应的相位,选择最优的手势。提出的QPGesture框架包括以下几个关键步骤:
手势量化:使用VQ-VAE模块将连续的手势动作序列编码为离散的手势编码,形成一个手势编码表。
音频量化与相似度计算:对输入的音频进行量化处理,并利用Levenshtein距离计算音频与手势编码之间的相似度。
相位引导的手势匹配:根据相位信息,选择最优的手势匹配,确保手势动作与语音节奏和语义的一致性。
手势生成:根据匹配结果生成连续的手势序列,实现自然的语音驱动手势生成。
手势量化
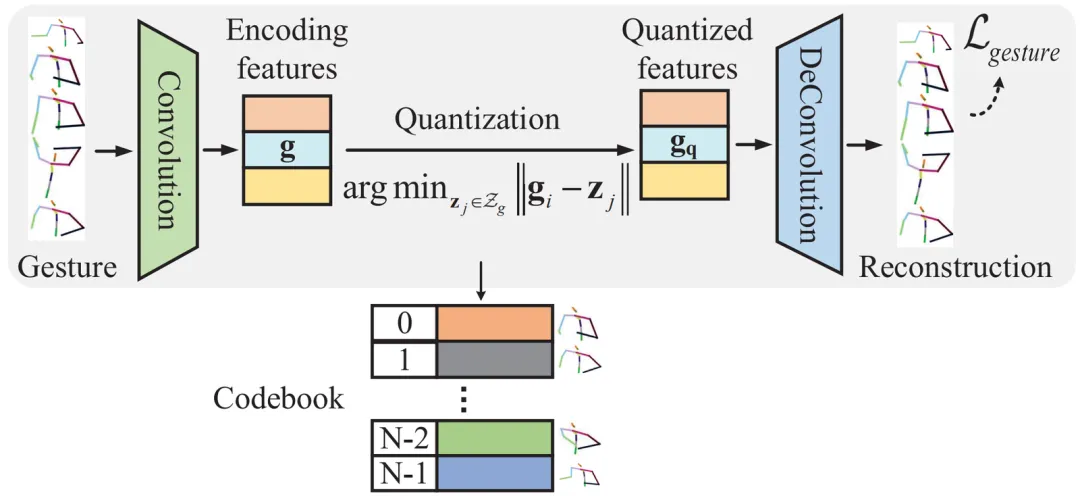
如上图所示,我们设计了一个手势VQ-VAE。给定手势序列G,我们采用一维时间卷积网络Eg将序列G编码为上下文感知特征g。编码表可以通过从分布中采样的样本来索引嵌入表。随后,反卷积解码器Dg将gq投影回运动空间,生成姿态序列Ĝ₁。
编码器、解码器和编码表可以通过优化以下目标进行训练:
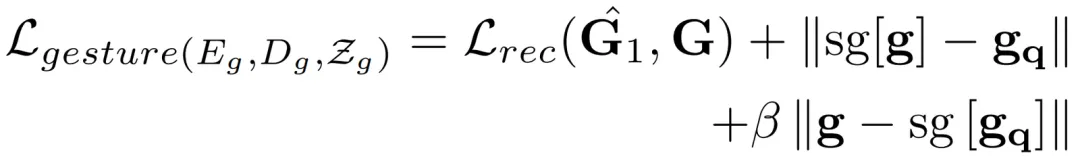
其中,Lrec是重建损失,用于约束预测的关节序列与真实值接近,sg[·]表示停止梯度操作,项||g - sg[gq]||是带有权重因子β的“Commit Loss”。我们在重建损失中添加了速度损失和加速度损失,以防止生成的手势出现抖动:
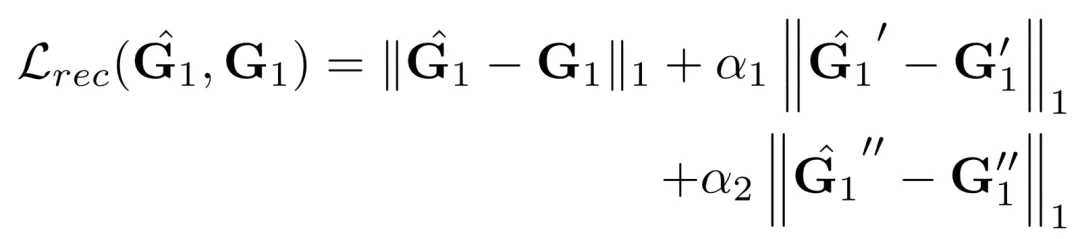
为了避免由关节全局位移引起的编码混淆,我们对输入G的绝对位置进行归一化,即将根关节(臀部)设为0,并使对象面向相同的方向。对所有关节应用标准归一化(零均值和单位方差)。
音频量化
我们使用在干净的100小时LibriSpeech子集上预训练的vq-wav2vec Gumbel-Softmax模型来对音频进行量化,该模型被离散化为39.9M个标记。我们将两个组的值相乘,作为音频片段的标记。卷积编码器生成表示z,对于每个时间步i,量化模块将原始表示z替换为来自Za的ẑ = aq,i,其中Za包含C'b个维度为n'z的编码集合。
基于音频和文本的动作匹配
我们的动作匹配算法接收一个离散文本序列t,一个离散音频序列
aq,以及一个初始的前一个姿态编码g-1,和一个可选的控制掩码序列M。输出为基于音频的候选Ca和基于文本的候选Ct。考虑到手势片段时间过长会降低手势的多样性,过短则会导致人类相似性差 ,我们通过文本转录中单词间隔大于0.5秒的时间间隔自动将每个手势动作拆分为片段级手势片段。这些片段级数据构成了语音-手势数据集。
为从数据集合中找到适当的输出手势序列Ca和Ct,我们同时考虑与当前测试语音的相似性以及每个T帧间隔的前一个搜索到的姿态编码g-1,以实现连续合成之间的更好连续性。在每次迭代中,我们首先比较初始编码g-1对应的关节与编码表中的每个编码gq对应的关节之间的欧氏距离,以获取基于姿态的预候选。在第一次迭代中,前一个姿态编码g-1通过从编码表Zg中随机采样一个编码,或设置为编码表中出现频率最高的编码(平均姿态编码)来初始化。
基于音频的搜索
为了编码与相关的过去和未来编码的信息,我们使用一个以当前时间为特征的搜索中心窗口(0.5秒长),然后得到音频特征序列Fa。为了解决语音与手势的固有异步性,使用 Levenshtein 距离来衡量测试音频的相似性,通过比较当前测试音频特征与数据库中片段的音频特征。对于数据库中的每个片段,我们计算每个编码每 d 帧对应的音频特征相似度,并取最小值作为每个编码的音频候选距离。然后我们得到基于音频的预候选。Levenshtein 距离作为手势与语音对应关系的相似度度量,有助于更好地将适当的手势与语音匹配,并很好地解决了语音与手势的对齐问题。
基于文本的搜索
类似地,我们使用当前编码前后0.5秒的文本作为当前编码的句子。为了获取上下文的语义信息,我们使用Sentence-BERT计算句子嵌入,作为文本特征序列Ft。对于数据库中的每个片段,我们计算每个编码每d帧对应的文本特征余弦相似度,并取最小值作为每个编码的文本候选距离。
我们不是对音频/文本和姿态项的相似度得分进行加权,而是为每个预候选项添加姿态相似度排名和音频/文本相似度排名,以选择最低排名的结果作为音频/文本候选。
相位引导的手势生成
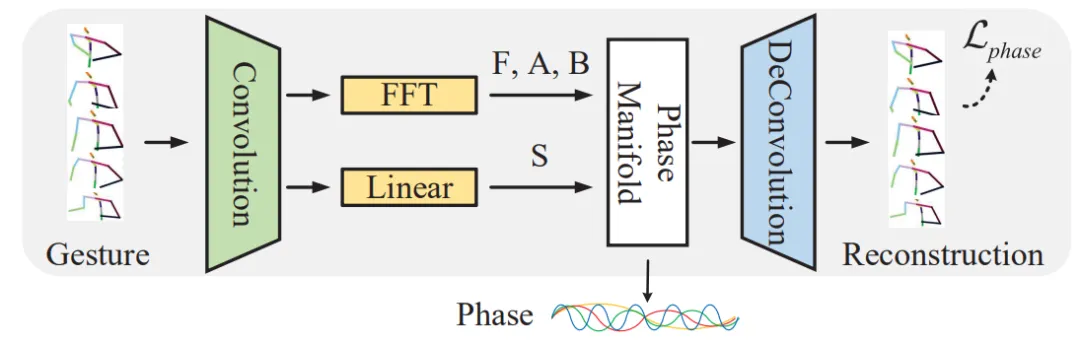
上图展示了周期性自动编码器网络的架构。为了将运动空间转换为学习到的相位流形,我们采用了类似于DeepPhase的时间周期性自动编码器架构。
卷积网络编码器学习手势的低维嵌入。然后,对每个通道应用可微的实数快速傅里叶变换(FFT)和全连接网络,以获取周期参数:振幅(A)、频率(F)、偏移(B)和相位偏移(S)。反卷积网络解码器将所有周期参数映射回原始运动曲线,以迫使周期参数重建原始潜在嵌入。
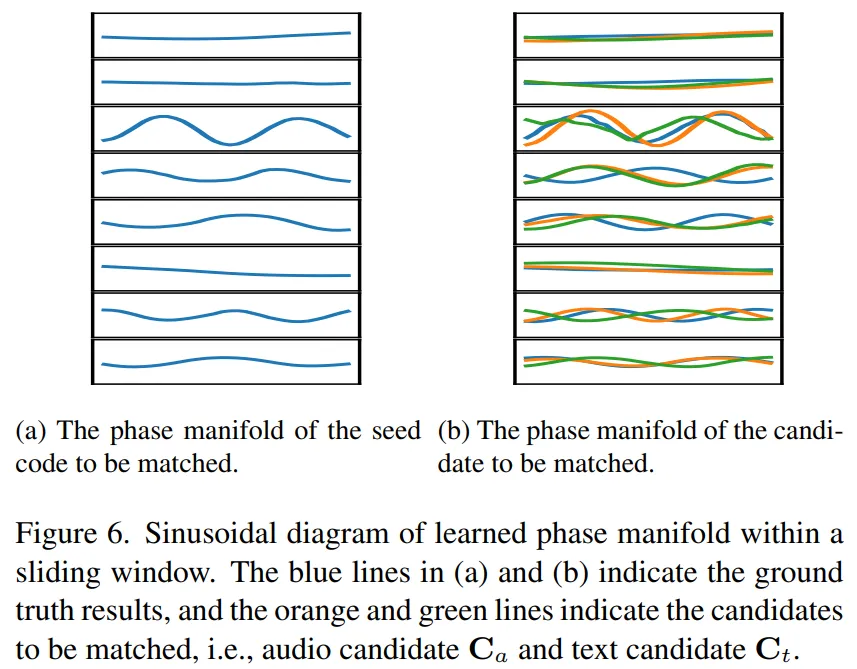
样本运动的相位流形P捕捉了原始时间序列数据当前状态的大量“信息”。手势曲线的相位流形如上图所示。我们没有像之前的研究那样使用相位来设置网络权重生成动作,而是使用相位引导来选择动作。为了找到适当的动作对齐,我们计算相位流形P中种子编码对应帧的后续Nstride帧和音频/文本候选Ca和Ct对应帧的前phase帧之间的余弦相似度:
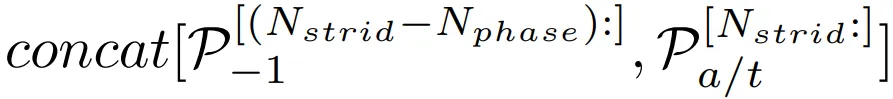
和
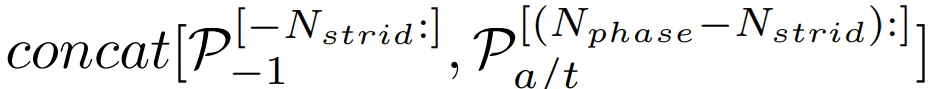
相位流形更相似的候选手势也会在最终匹配时更加自然。
实验验证
数据集
我们在BEAT数据集上进行了训练和评估,该数据集据我们所知是目前最大规模的公开可用的人体手势生成运动捕捉数据集。我们将数据按8:1:1的比例分为训练集、验证集和测试集,并使用所有说话者的数据训练编码表和基线模型。由于运动匹配更耗时,我们从两位说话者“wayne”(男性说话者)和“kieks”(女性说话者)中选择了4小时的数据,并为我们的实验构建了独立的数据库。
实现细节
在本研究中,我们使用了15个对应上半身的关节,不包括手和手指。我们计算了3×3旋转矩阵特征作为手势序列,姿态维度Dg为9。下采样率d设为8。编码表Zg的大小Cb设为512,维度nz也为512。
在训练VQ-VAE时,手势数据被裁剪为长度T=240(4秒),使用ADAM优化器(学习率为 1×10⁻⁴,β1=0.5, β2=0.98)进行200步训练,批量大小为128。我们设置β=0.1,α1=1和α2=1。
在运动匹配方面,音频和文本的窗口长度为4个姿态编码,分别对应过去和未来的语音信息,下采样率d=32。对于相位引导,我们使用旋转速度作为网络的输入。我们使用AdamW优化器进行100个epoch的训练,学习率和权重衰减均设为1×10⁻⁴,批量大小为128。相位通道数M设为8。为了计算相位相似度,帧数设为Nphase=8和步长Nstride=3。整个框架在一块NVIDIA A100 GPU上的学习时间少于一天。初始姿态编码通过从编码表Zg中随机采样一个编码生成。
评估指标
我们使用速度直方图之间的距离来评估手势质量。具体来说,我们计算速度分布直方图,并通过以下公式计算Hellinger距离H来与自然运动的速度分布进行比较:
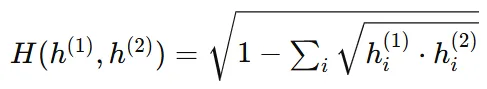
其中h(1)和h(2)分别表示两个速度分布直方图。
我们提出在特征空间上的Fréchet手势距离(FGD)作为衡量生成手势质量的指标。该指标基于图像生成研究中使用的FID指标。类似地,我们在原始数据空间计算FGD。为了计算FGD,我们使用Trinity数据集训练了一个自动编码器。更低的Hellinger距离和FGD值表示更好的性能。我们还在补充材料中报告了平均颤动、平均加速度和典型相关分析(CCA)的结果。
与现有方法的比较
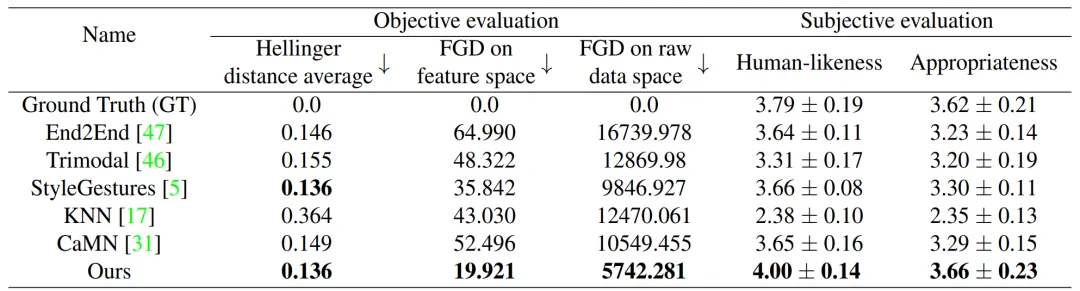
我们将我们提出的框架与End2End(基于文本)、Trimodal、StyleGestures和KNN进行比较。定量结果如上表所示。根据比较结果,我们的方法在所有评估指标上均优于其他现有方法。具体而言,在Hellinger距离平均值指标上,我们与StyleGestures取得了相同的优良结果。由于训练良好的模型应生成与特定说话者具有相似属性的动作,我们的方法在任何给定关节的运动速度曲线图谱上表现相似。此外,我们的方法在特征空间和原始数据空间上的FGD值分别比最佳基线模型StyleGestures改善了15.921(44%)和3837.068(39%)。
为了进一步了解我们方法的实际视觉性能,我们进行了一个用户研究,参与者比较了每种方法生成的手势序列与真实数据。根据GENEA的评估方法,我们从30分钟的测试集中选择了38个短段的测试语音及其对应的测试手势用于评估。这些段落长度约为8至15秒,理想情况下不短于6秒,并且确保评估中没有以“悬崖式”结束的口语短语。实验分别由23名参与者完成。生成的手势数据通过Blender渲染在一个头像上进行可视化。在人体相似性评估中,每个评估页面询问参与者“手势动作看起来有多像人类?”。在适宜性评估中,每个评估页面询问参与者“这些手势对语音有多适宜?”。每页展示六个视频,参与者以5到1的等级进行评分,标签(从最好到最差)为“优秀”、“良好”、“一般”、“差劲”和“糟糕”。
上表的最后两列报告了人体相似性和适宜性的平均意见分数(MOS)。我们的方法在人体相似性和适宜性方面显著优于比较的最先进方法,甚至在人体相似性方面超越了真实数据(GT)。然而,与真实数据的适宜性没有显著差异。根据参与者的反馈,我们生成的手势更“与语义相关”且“更自然”,而我们的方法相比真实数据“缺乏力度且手势夸张”。更多有关用户研究的细节见补充材料。
消融研究
还进行了消融研究,以评估框架中不同组件的性能影响。探讨了以下组件的有效性:
Levenshtein距离,
音频模态,
文本模态,
相位引导,
运动匹配。
分别对这五个组件进行了实验。
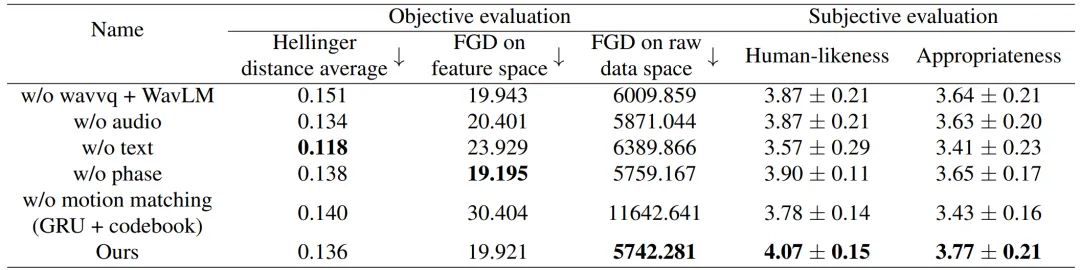
根据上表的结果,当不使用vq-wav2vec或Levenshtein距离来衡量手势与语音的对应相似性,而是使用预训练于Librispeech的WavLM并使用余弦相似度代替时,所有指标的性能都降低了。特征空间上的FGD变化不显著。Hellinger距离平均值和原始数据空间的FGD分别降低了0.015(11%)和267.578(4.7%)。
当模型在没有音频的情况下训练时,我们为基于文本的运动匹配选择了两个候选项而不是一个,然后基于相位引导合成手势。特征空间和原始数据空间的FGD分别下降了0.48(2%)和128.763(2%)。
当模型在没有文本的情况下训练时,类似地,我们为基于音频的运动匹配选择了两个候选项而不是一个。特征空间和原始数据空间的FGD分别减小了4.008(20%)和647.585(11%)。注意,当不使用文本和音频的其中一个模态时,FGD指标增加,而Hellinger距离平均值指标减少,这表明仅使用一个模态时生成手势的质量下降,但速度分布更好。
当移除相位引导时,我们每次在两个候选项之间随机选择一个。结果显示Hellinger距离平均值和原始数据空间的FGD轻微增加,而特征空间的FGD轻微下降,但变化不显著。一个可能的解释是,相位空间在生成更自然动作时丢失了原始特征空间的信息,如图所示。
当模型使用深度门控循环单元(GRU)来学习姿态编码而不是运动匹配时,特征空间和原始数据空间的FGD分别减小了10.483(53%)和6460.202(107%)。这证明了匹配模型相对于生成模型的优势。此外,该模型与基线模型的性能相当,也证明了编码表编码的手势空间的效率。
同样,我们对消融研究进行了用户研究。我们使用与前一节相同的方法,不同之处在于我们使用另一个头像角色来测试结果的鲁棒性。人体相似性和适宜性的MOS分数显示在表的最后两列。我们提出的框架的得分与之前的方法相似,略高,表明即使生成的结果相同,评分可能与不同角色的视觉感知有关。然而,没有显著变化。结果表明,模型在缺少任何模块时性能下降。注意,缺少文本的得分比缺少音频的得分下降更多,这表明匹配的手势主要与语义相关。不使用相位空间对结果的影响最小,这与预期一致,因为相位只提供指导。另一个显著的结果是,缺少音频或使用不带Levenshtein距离或音频量化的音频的结果相近,有效表明Levenshtein距离的有效性。此外,不使用运动匹配的结果在自然性方面与真实数据相当,进一步证实了编码表编码手势单元的有效性。
结论
为了解决语音驱动手势生成中的随机抖动和语音与手势异步问题,我们提出了基于量化和相位引导的QPGesture框架。通过手势量化、Levenshtein距离对齐和相位引导策略,QPGesture能够生成更加自然、协调和多样化的手势动作。未来的研究可以进一步融合更多模态信息,如情感和面部表情,以提升手势生成的表达力和适应性。
