
 语音小管家
在智能家居、老年护理和行为监测等领域,人类活动识别(Human Activity Recognition, HAR)技术的应用日益广泛。传统的HAR系统通常依赖于可穿戴设备、传感器网络或音视频数据来检测和分类人类活动。然而,基于声音的HAR系统因其非侵入性和传感器部署简便性而具有独特优势。这类系统能够利用环境声音推断人类活动,无需用户直接交互或佩戴设备。
基于声音的HAR系统在实际部署中面临的主要挑战之一是领域偏移(domain shift)。当模型在与训练环境不同的环境中部署时,由于环境条件、麦克风特性以及背景噪声的差异,模型性能会显著下降。例如,不同地点的水流声可能因水压、水槽材质和周围噪声条件的不同而产生不同的声音模式。
此外,传统HAR模型通常基于在控制环境中收集的大规模数据集进行预训练,这些模型难以泛化到现实环境中。而且,大多数现有系统假设分类标签是固定的,这限制了模型在不同环境中的适应性。在实际应用中,不同场所可能需要识别不同的活动集。例如,浴室可能需要检测冲水和刷牙的声音,而厨房则可能关注与烹饪相关的切菜和煮沸声音。
为了解决这些问题,韩国庆北国立大学的研究团队提出了一种基于位置感知的环境声音模型自适应系统,通过基于边缘的迁移学习和伪标签机制解决跨环境部署时的域迁移问题。系统可动态调整分类标签,利用本地数据微调预训练模型,并通过高置信度无标签数据迭代优化,支持实时推理和低功耗运行,适用于智能家居等边缘场景。研究成果发表在IEEE Access期刊上。
系统架构
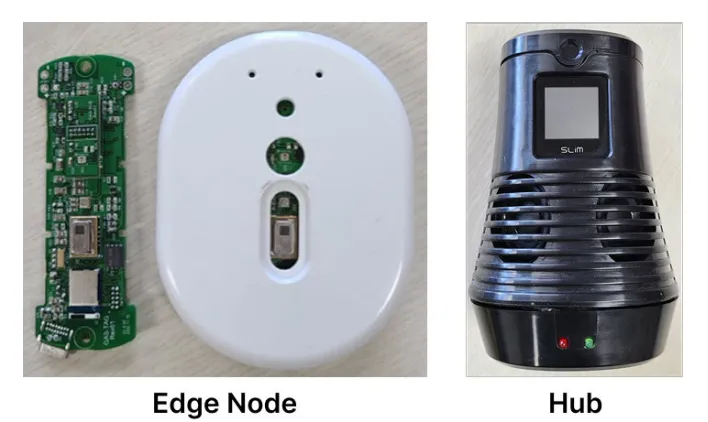
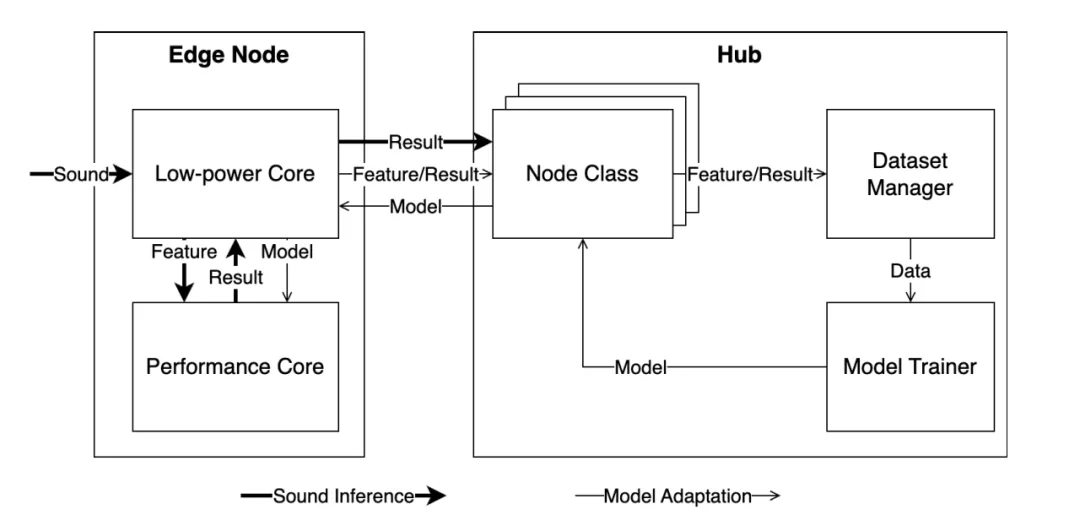
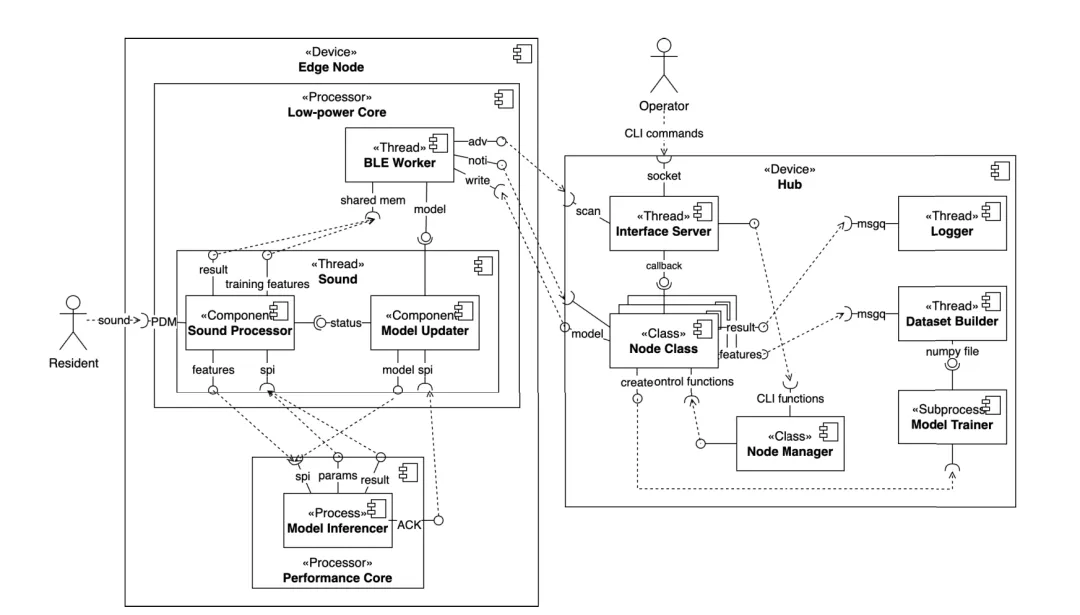
系统采用边缘节点与中枢设备协同工作的架构模式,共同完成声音数据处理、模型优化与部署等任务。
边缘节点与中枢设备的物理示意图
声音识别与自适应系统架构
系统组件图
(一)边缘节点:实时感知与轻量级推理
硬件与功能
边缘节点配备PDM麦克风,实时捕捉环境中的声音信号。采集到的原始声音信号会被预处理为Mel声谱图。为了降低计算负载,适应边缘设备资源有限的特点,系统将Mel声谱图量化为8位整数,减少数据存储与计算所需的空间和资源。
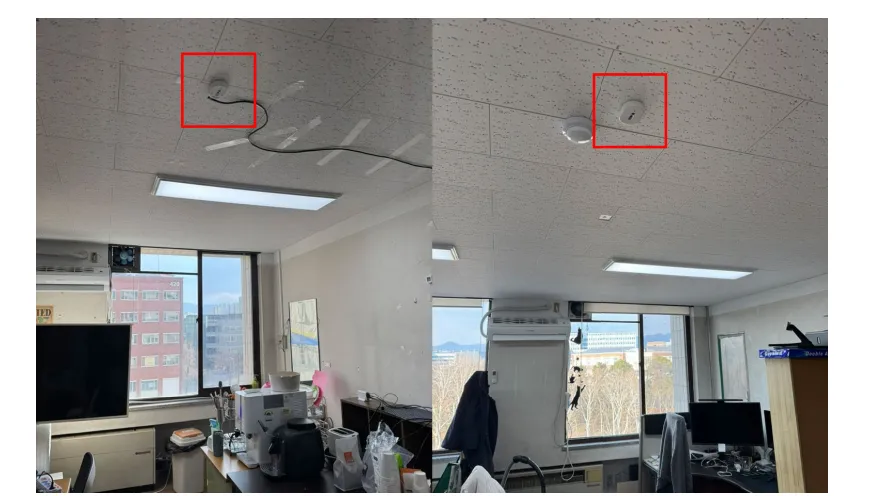
边缘节点安装示例
边缘节点运行轻量级的ResNet模型,模型以1秒为间隔进行实时分类,单次推理时间控制在500ms以内,确保对声音事件的快速响应。推理过程中,对于高置信度(如分类概率超过设定阈值,假设为0.85)的特征 - 结果对,边缘节点会将其存储至SD卡。这些数据后续将在设备空闲时段,通过蓝牙低功耗(BLE)传输至中枢设备,为模型优化提供数据支撑。
分类逻辑
边缘节点将声音分类为四大类,构建起空间感知的基础框架:
本地声(Local):指节点所在空间内发生的人类活动或设备运行产生的声音,具有强空间特异性。例如在浴室的边缘节点,“刷牙声”“冲马桶声”就属于本地声,这类声音能够直接反映该空间内正在进行的活动。
邻居声(Neighbor):代表相邻空间传入的声音。比如卧室节点检测到从客厅传来的“电视声”,这些声音虽然并非发生在本空间,但能提供周边环境的信息,辅助判断整体场景。
全局声(Global):是在多个空间甚至整个环境中都可能出现的声音,如“说话声”“脚步声”。这类声音不具备明显的空间指向性,但对于理解人类活动的整体情况具有重要意义。
噪声(Noise):主要包括背景环境中持续存在的、无特定意义的声音,如空调的嗡鸣声、冰箱的运转声。准确识别噪声并将其过滤,能够减少干扰,提高目标活动声音的识别准确率。
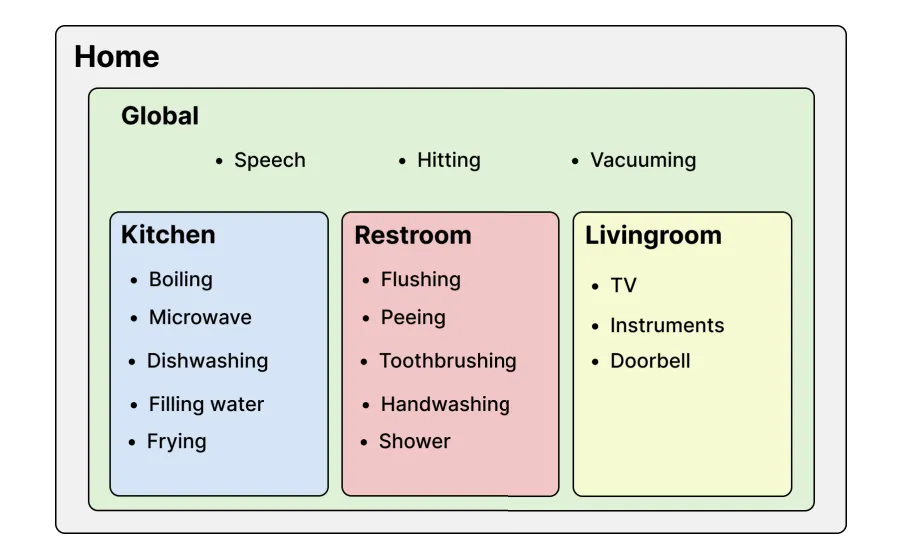
家庭环境中环境声音的分类
(二)中枢设备:模型更新与数据管理
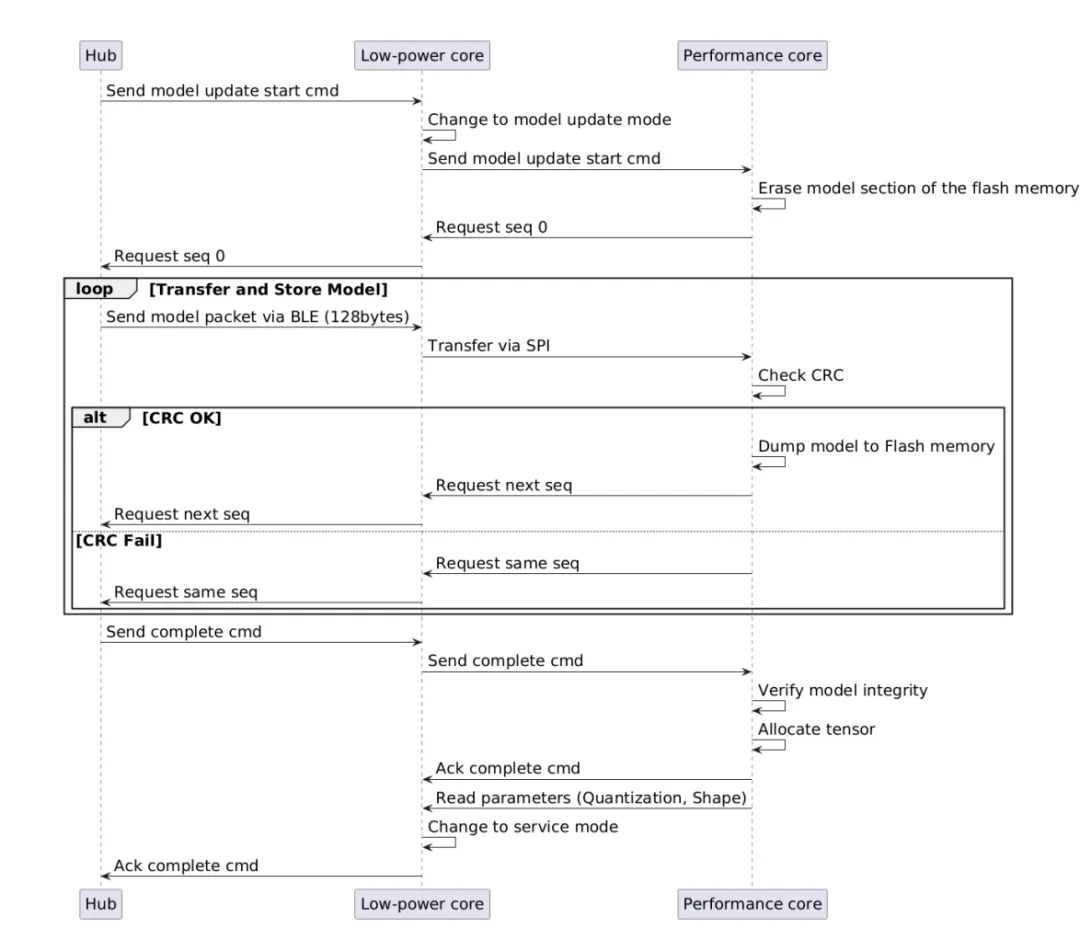
模型更新序列图
数据管理与数据集生成
中枢设备通过 BLE 接收来自多个边缘节点传输的特征数据,并结合每个节点的位置标签(如 “厨房”“客厅” 等),构建域特定数据集。除了收集包含目标活动声音的数据,中枢设备还会自动提取背景噪声数据,将其作为训练样本的一部分。
模型自适应训练与优化
迁移学习:
采用部分微调的迁移学习策略,仅对预训练模型的分类器层进行参数更新,保留底层的特征提取器(编码器)。通过保留编码器,系统避免了重新学习这些基础特征的过程,大幅减少了训练所需的数据量和计算资源。
实验表明,使用迁移学习后,仅需 200 个样本 / 标签,模型就能达到 90% 的分类准确率,而传统全模型训练方式则需要 1500 个样本 / 标签,效率提升显著。
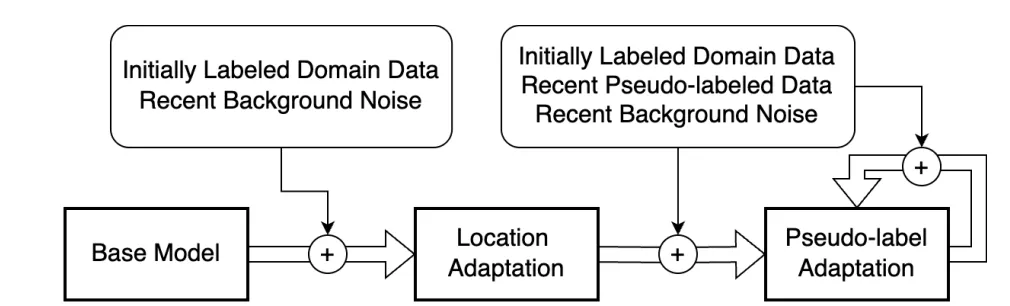
自适应步骤概览
伪标签机制:
为了进一步提升模型对环境变化的适应能力,中枢设备引入伪标签机制。对于无标签数据,模型会先进行预测,然后筛选出分类概率高(如大于 0.9)的样本,将模型预测的类别作为伪标签赋予这些样本。这些带有伪标签的数据会被加入到训练集中,用于迭代优化模型。通过这种方式,系统能够利用未标注数据不断学习新的声音模式,适应季节变化带来的噪声差异(如夏季空调噪声、冬季供暖声),无需人工进行大量标注工作。
模型部署与传输保障
经过自适应训练优化后的模型,由中枢设备通过 BLE 传输至边缘节点进行部署。为确保模型在传输过程中不出现数据损坏或丢失,系统采用 CRC 校验与序列编号机制。整个模型部署过程能够在 7 分钟内完成,保证了系统的实时性和稳定性。
实验验证
为了验证所提出方法的有效性,研究人员在两个真实家庭环境中进行了实验,分别标记为Home1和Home2。
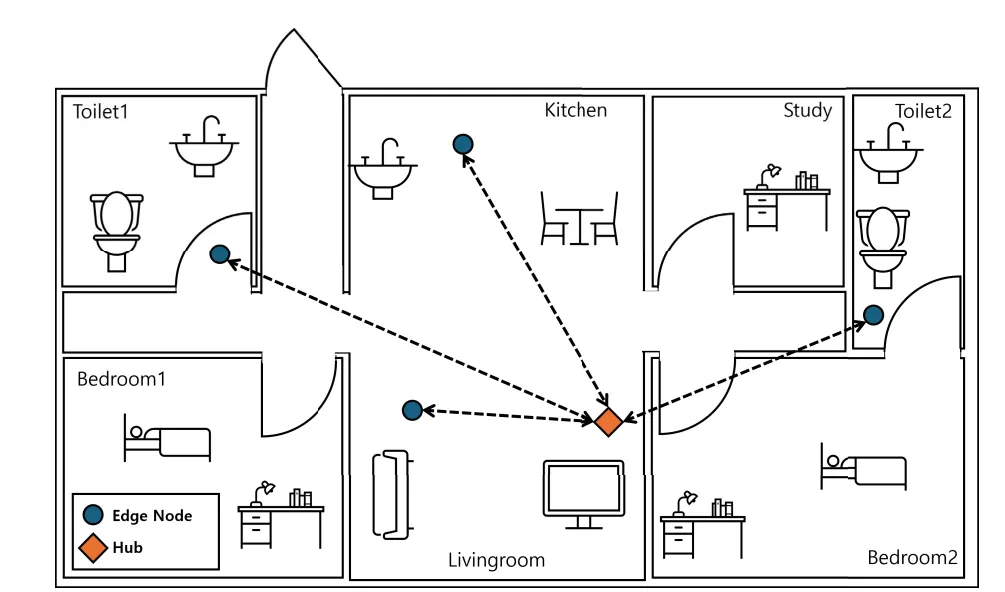
Home1系统概览
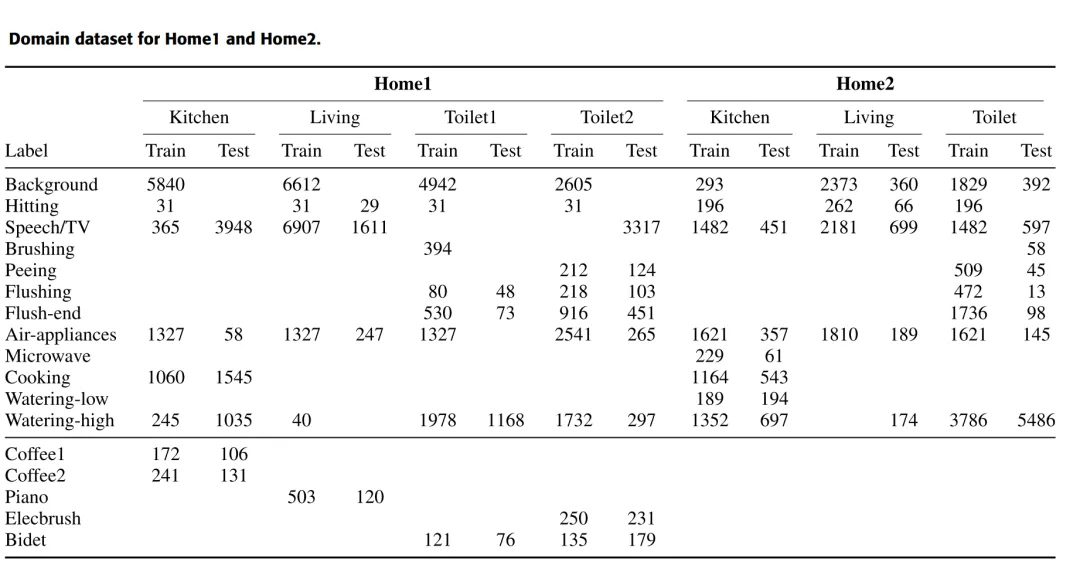
在每个家庭中,边缘节点被安装在厨房、客厅和浴室等不同位置。音频数据收集持续了五天,其中前两天的数据用于初始适应,第三和第四天的数据用于伪标签,第五天的数据作为测试集。实验中,研究人员使用了多种声音标签,包括背景噪声、打击声、语音/电视、刷牙、小便、冲水等常见活动声音,以及咖啡机、钢琴、电动牙刷和出水声等特定活动声音。
实验结果表明,在初始适应之前,基线模型在不同环境中的分类准确率较低,范围从厨房的57%到客厅的71%。经过迁移学习后的初始适应,分类性能显著提高,例如在Home1中,厨房的准确率从57%提高到92%,客厅从59%提高到95%。在Home2中,厨房的准确率从62%提高到95%,F1分数从46%提高到92%。
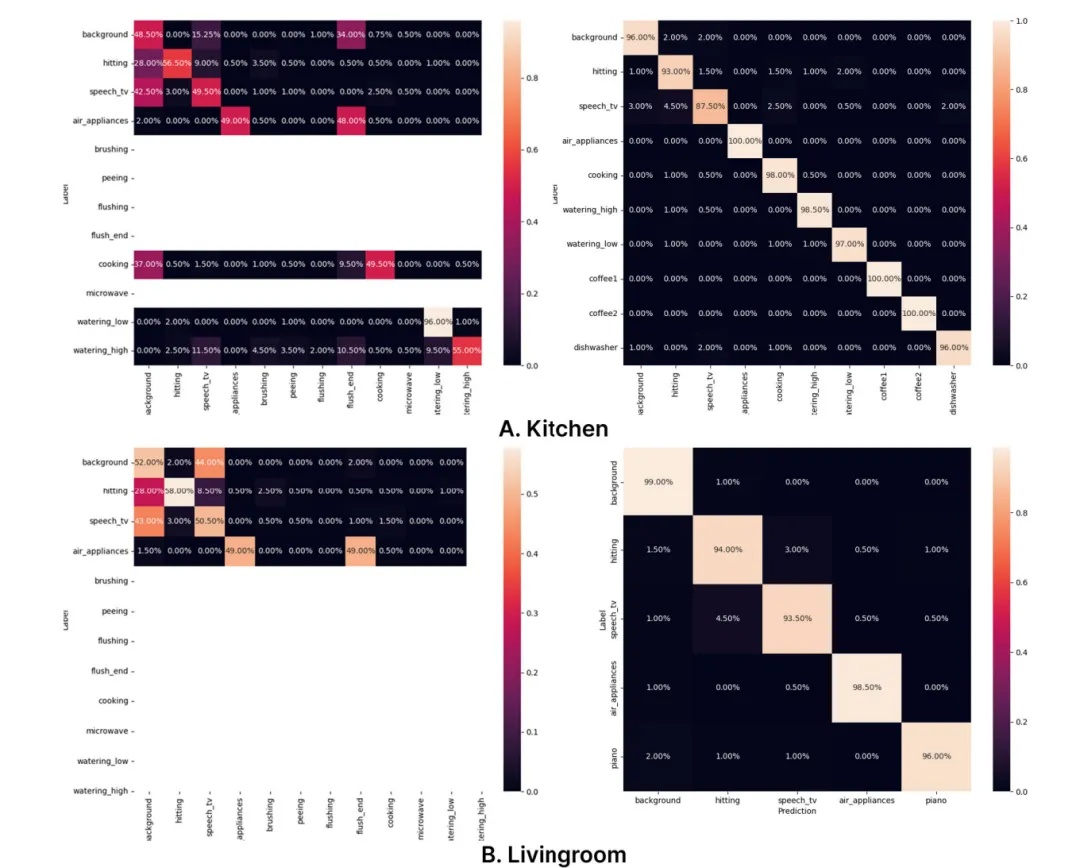
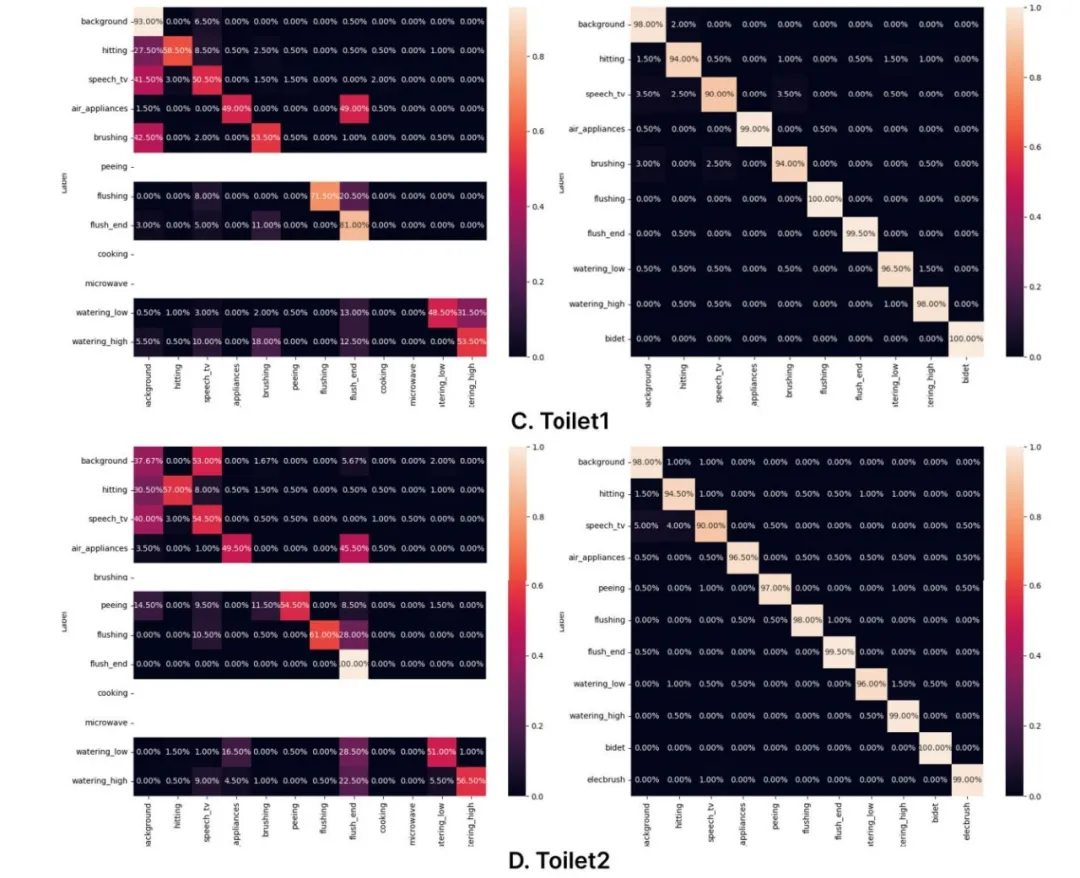
Home 1 的自适应结果
进一步通过伪标签进行持续适应后,所有位置的F1分数和损失都有额外的改善。例如,在Home1中,厨房节点的F1分数从91%提高到95%,损失从1.53降低到0.77。在Home2中,客厅节点保持了97%的高准确率,但损失从1.14降低到1.05,同时保持了93%的F1分数。这些结果突出了伪标签机制在利用未标记数据细化模型和提高分类置信度方面的有效性。
模型适应与部署总时间控制在 20 分钟内,满足边缘设备的实时性要求,且功耗低于传统云端方案。
总 结
尽管该研究在声音识别领域取得突破,但同类声音(如水活动与烹饪声)的混淆问题仍需优化。未来计划引入多模态数据融合(如结合运动传感器、热成像),并探索对抗学习等高级域适应技术,进一步提升复杂环境下的活动识别鲁棒性。这项研究为智能家居、智慧养老等场景提供了可落地的边缘智能方案,有望推动 “无感式” 环境感知技术的商业化进程。
参考文献:
Lee, C., Kang, H., & Kang, S. J. (2025). Location-Aware Ambient Sound Model Adaptation for On-Device Human Activity Recognition in Living Spaces.IEEE Access, 13, 84911-84924. DOI: 10.1109/ACCESS.2025.3568828。
