
 语音小管家
来源丨21db声学人
随着生成模型的快速发展,4D场景生成技术(即动态3D场景生成)在近年来取得了显著进展。4D生成技术能够从任意相机视角生成时空一致的渲染效果,广泛应用于增强现实(AR)、虚拟现实(VR)、机器人技术和自动驾驶等领域。
尽管视觉渲染技术已经能合成高度逼真的动态三维场景,但现有方法大多忽视了与场景匹配的空间音频生成,这极大限制了沉浸式视听体验的完整性。
基于此,中国科学技术大学的研究团队提出了Sonic4D 框架,将空间音频引入 4D 生成场景,通过三阶段流程实现了动态视觉与空间音频的协同渲染。相关研究成果已发表于预印本平台 arXiv。
核心框架
Sonic4D 的技术路线分为三个重要阶段。
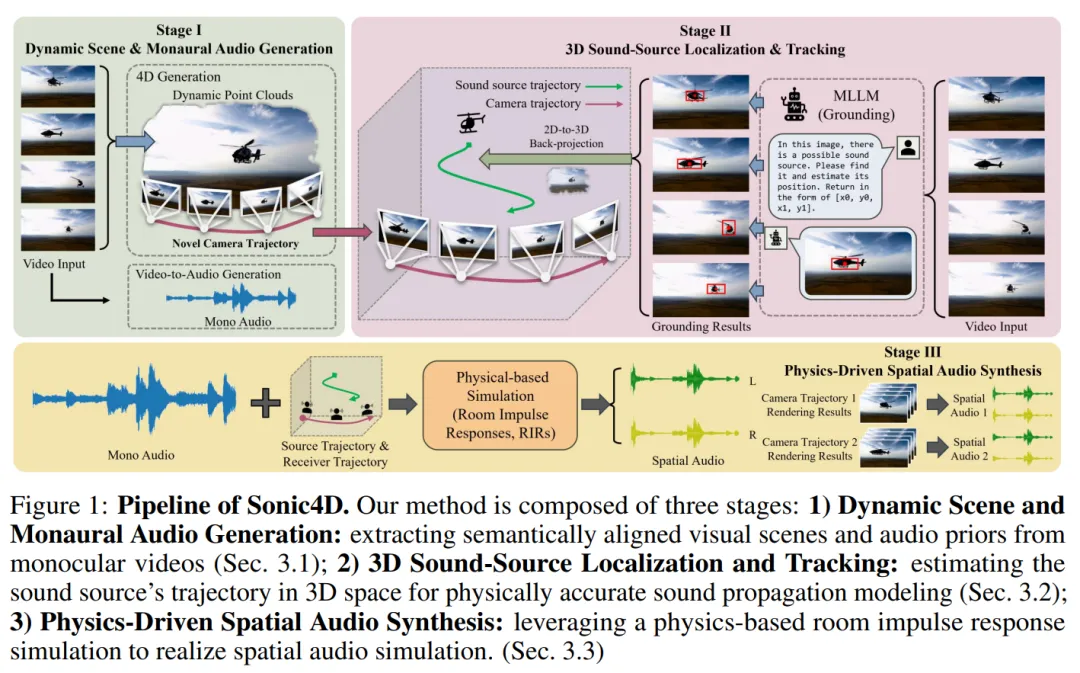
图1:Sonic4D 的流程。我们的方法由三个阶段组成:1)动态场景和单声道音频生成:从单目视频中提取语义对齐的视觉场景和音频先验;2)3D 声源定位与跟踪:估计声源在 3D 空间中的轨迹,以进行物理上准确的声音传播建模;3)物理驱动的空间音频合成:利用基于物理的房间脉冲响应模拟实现空间音频仿真。
首先,在动态场景与单声道音频生成阶段,团队利用预训练的 4D 生成模型 TrajectoryCrafter 从单目视频中提取动态点云,构建 4D 场景;同时借助 MMAudio 模型生成与视觉内容语义对齐的单声道音频,为后续处理提供基础声学输入。
其次,在 3D 声源定位与跟踪阶段,研究团队采用多模态大语言模型 GroundingGPT 进行像素级视觉 grounding,通过文本提示 “定位视频中的声源并返回坐标”,获取每一帧的声源 2D 位置,再结合单目深度估计将其反投影至 3D 空间。为消除噪声干扰,团队引入 DBSCAN 算法过滤异常点,并通过线性插值生成平滑的声源轨迹。
最后,在物理驱动的空间音频合成阶段,基于估计的声源与接收者(相机)轨迹,研究团队利用 GPU 加速的房间脉冲响应(RIR)模拟技术 gpuRIR,通过图像源方法(ISM)计算声波在环境中的传播与反射,将单声道音频转换为随视角变化的双耳音频。该过程考虑了房间尺寸、混响时间等物理参数,确保音频具有真实的空间方向性与环境反射特征。
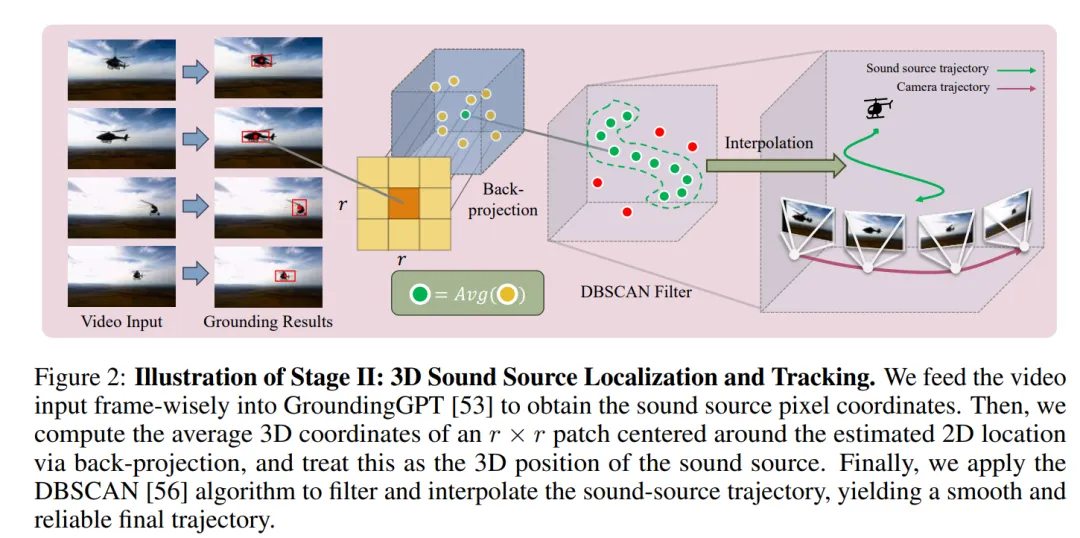
图2:第二阶段(3D声源定位与跟踪)的示意图。将视频输入逐帧送入 GroundingGPT以获取声源像素坐标。然后,通过反投影计算以估计的 2D 位置为中心的 r×r 补丁的平均 3D 坐标,并将其视为声源的 3D 位置。最后,应用 DBSCAN算法过滤和插值声源轨迹,生成平滑可靠的最终轨迹。
实验验证
研究团队通过用户偏好实验验证了 Sonic4D 的有效性。在与基线方法 MMAudio 的对比中,Sonic4D 以 89.03% 的偏好率领先,其生成的空间音频在空间定位准确性(MOS-SLA 评分 4.013 vs 2.322)和视听空间一致性(MOS-AVSC 评分 3.977 vs 2.418)上均表现更优。
定性实验进一步展示了 Sonic4D 对不同场景的适应性:当相机环绕吉他演奏者时,音频的左右声道差异能精准反映视角变化;在喷泉场景中,相机拉远时音频的音量衰减与视觉距离变化高度同步。这些结果表明,Sonic4D 生成的音频能有效传递空间位置与动态信息。
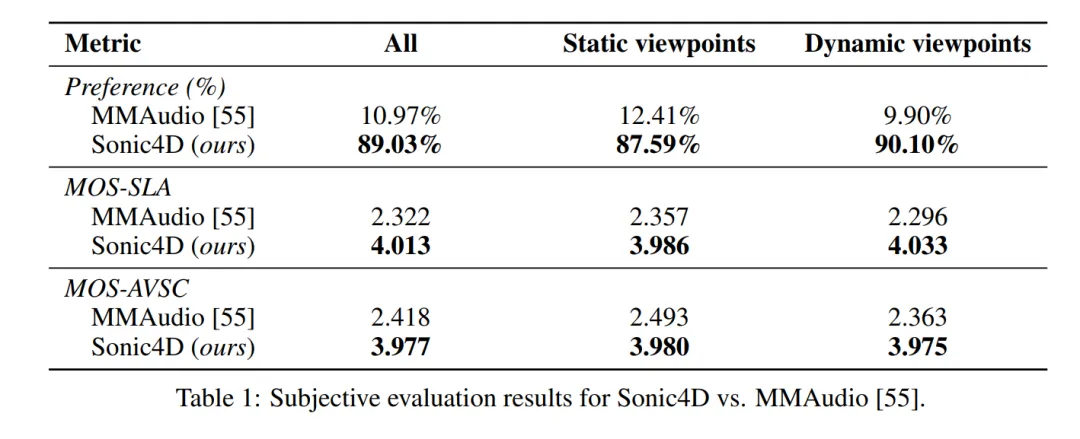
表 1:Sonic4D 与 MMAudio 的主观评估结果
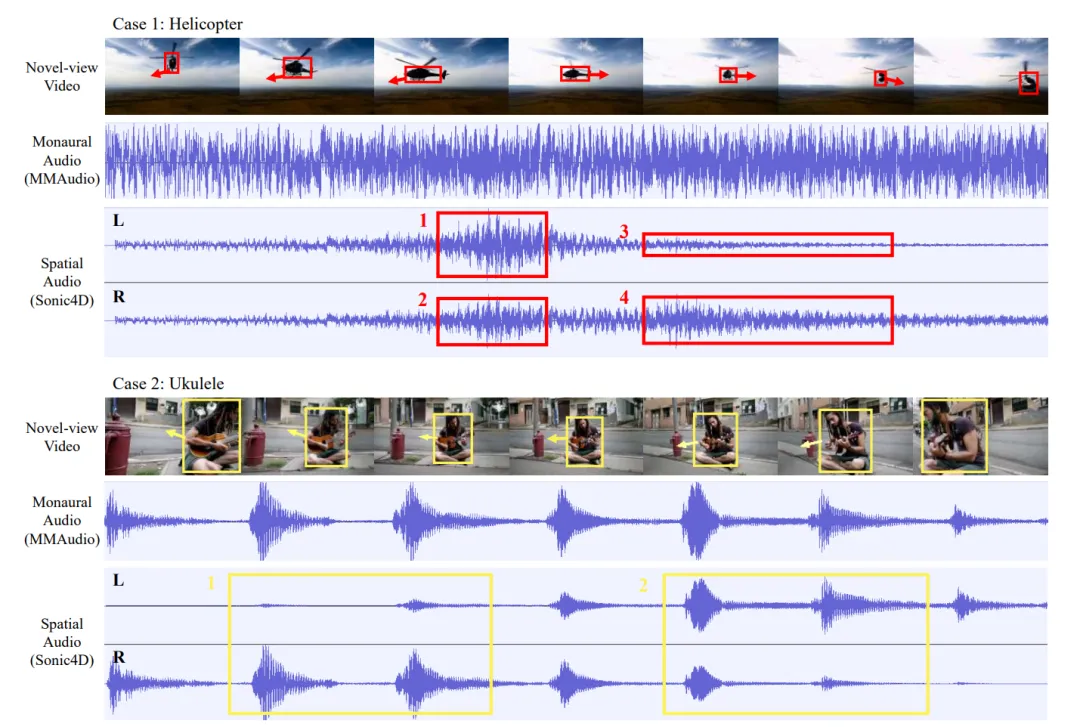
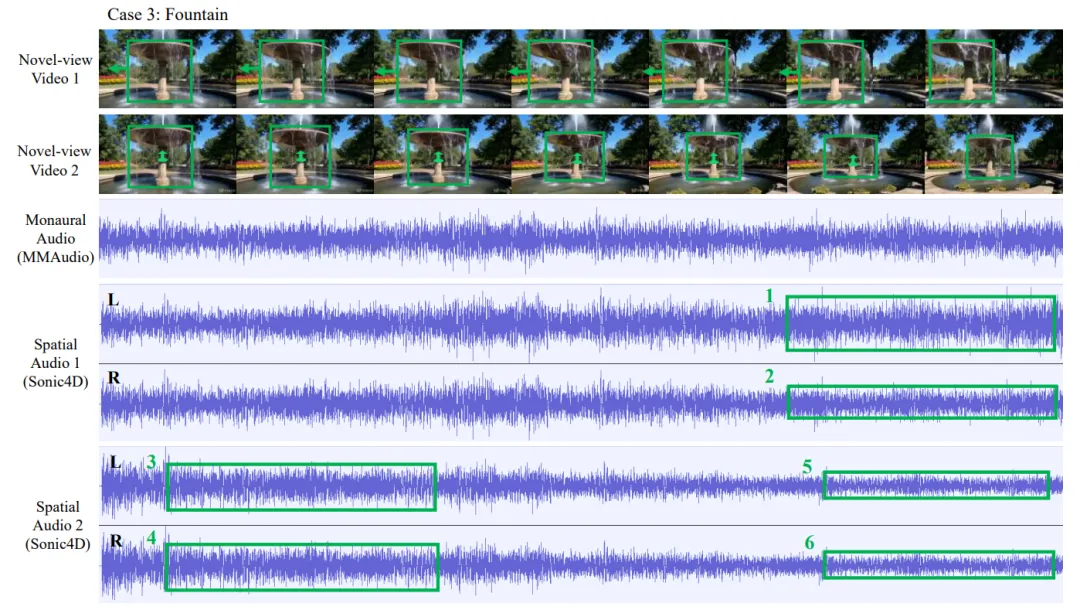
图 3:不同场景下的定性结果。图中展示了 Sonic4D 在各种相机轨迹(包括静态相机视角、相机环绕对象、向右平移和拉远)条件下生成的空间音频对比。这些示例展示了生成的空间音频与视觉对象运动的时间和空间对齐。
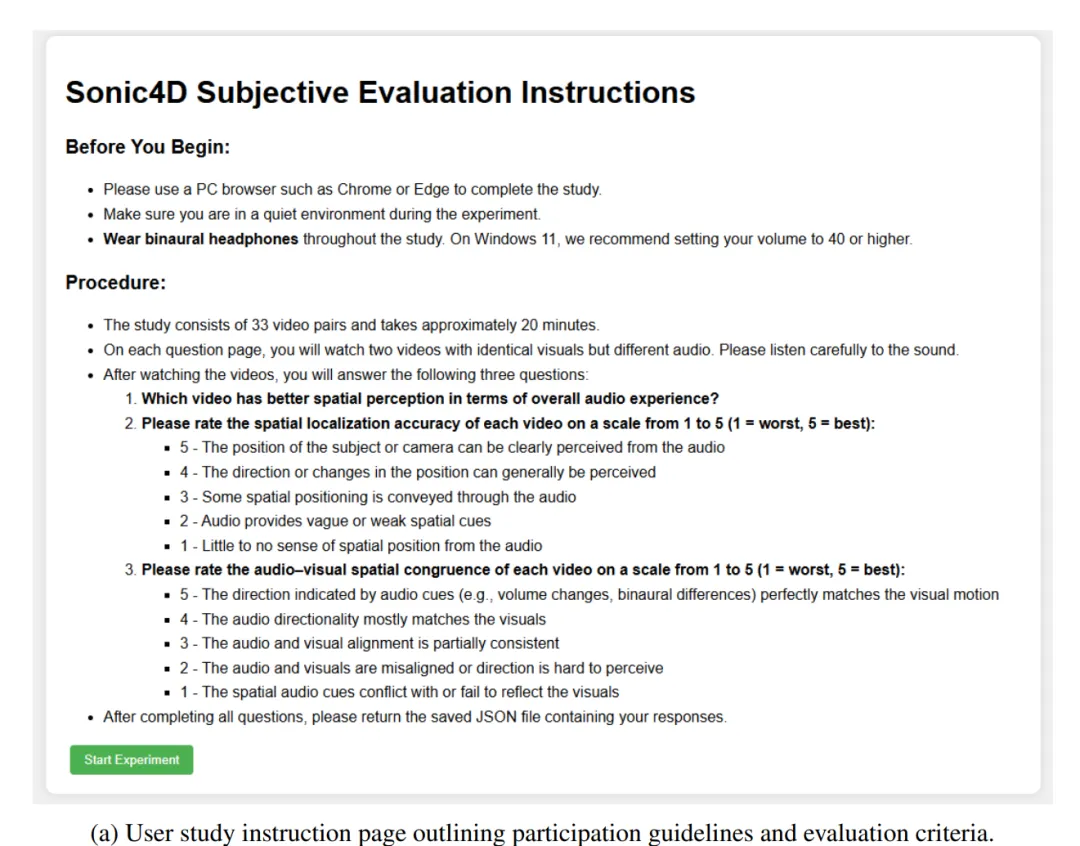
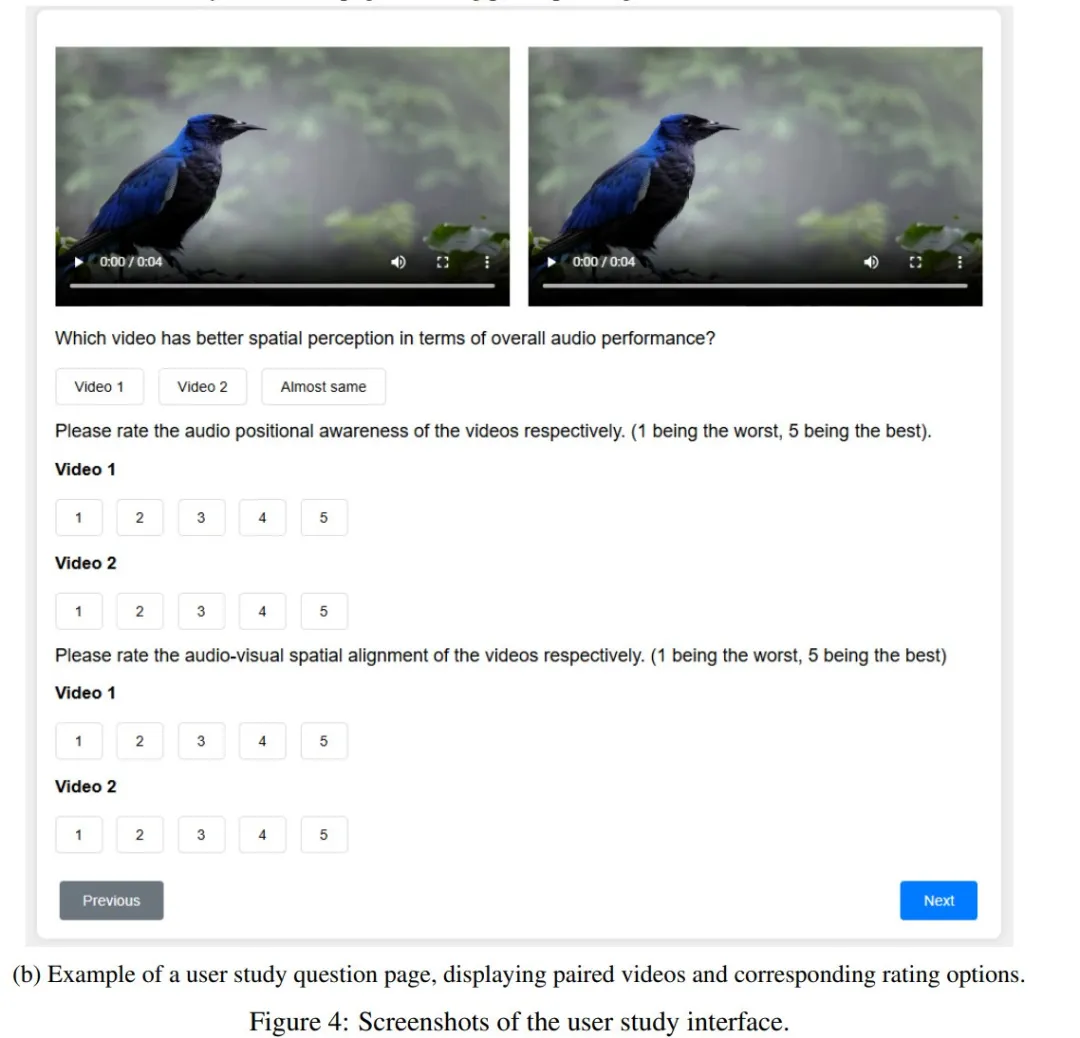
图 4:用户研究界面截图。(a)用户研究说明页面,概述参与指南和评估标准;(b)用户研究问题页面示例,显示配对视频和相应的评分选项。
局限与未来展望
Sonic4D框架的模块化设计使其能够轻松集成最新的预训练专家模型,确保了框架的可扩展性和未来潜力。但研究团队也指出当前局限:当前框架仅支持单声源场景,且依赖单目深度估计的点云建模,在复杂环境中可能影响音频传播的物理准确性;此外,模型未纳入头部相关传输函数(HRTF)等精细声学模型,限制了空间感知的细腻度。
未来,团队计划通过改进多模态大语言模型的提示策略,拓展多声源定位能力,并结合更精确的几何建模与声学模拟,进一步提升空间音频的物理真实性。
演示视频与技术细节可在(https://x-drunker.github.io/Sonic4D-project-page)上查看。
论文信息:Xie S, Zhu H, He T, et al. Sonic4D: Spatial Audio Generation for Immersive 4D Scene Exploration [J]. arXiv preprint arXiv:2506.15759v1, 2025.
