
 语音小管家
语音是最贴近人类本质的沟通方式,不仅传达语言,还承载情感、声纹、语气与节奏,展现说话者的个性与意图。在大语言模型(LLMs)推动下,语音语言模型迅速演进。离散语音 token(Discrete Speech Tokens) 正成为构建语音表征的基础范式。这类 token 以其“离散、紧凑、语义兼容”的特性,在压缩传输、低延迟推理中优势明显,且与语音语言模型建模框架天然契合,为语音与文字融合铺平道路。
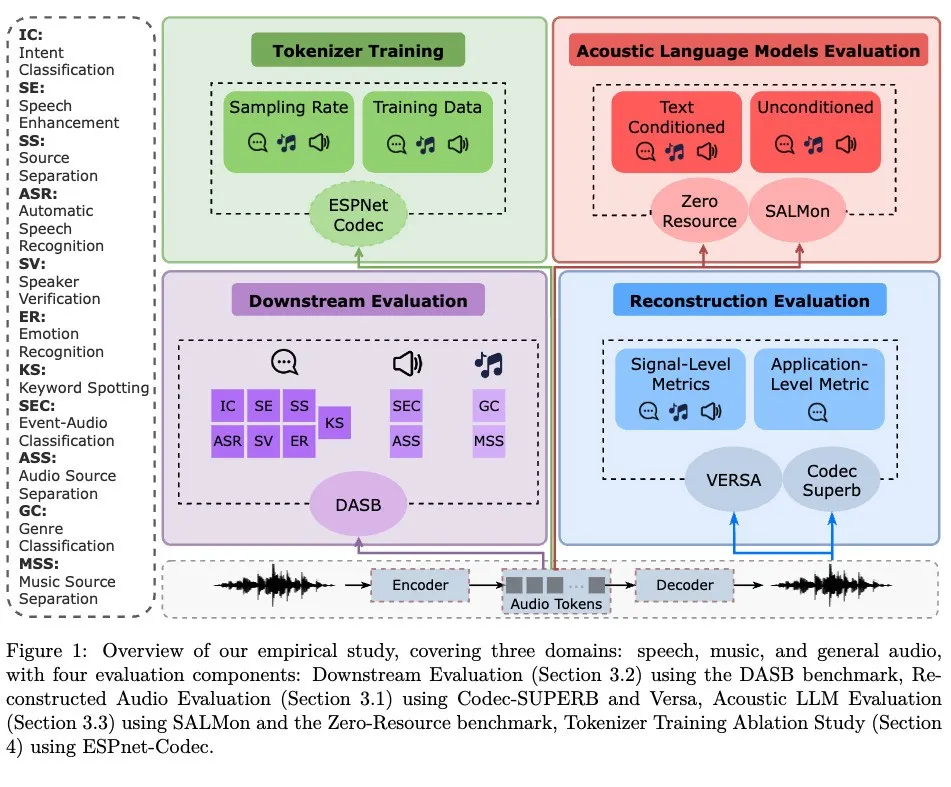
本文系统性回顾并评测了当前主流的离散音频 token 方法,覆盖语音、音乐与通用音频三个领域,提出统一的分类体系与评测基准,并在重建质量、下游任务表现和声学语言建模方面做出全面对比分析。我们还构建了公开数据库,为后续研究提供可复现的实验资源与分析框架。
论文全文:
项目主页:https://poonehmousavi.github.io/dates-website/
作者团队来自
工业界:微软、苹果、谷歌
学术界:CMU、Concordia、UCL、蒙特利尔大学、以色列希伯来大学、UIUC、台湾大学、剑桥大学等11家世界领先的高校。
为什么关注离散音频Token?
存储与推理效率:用紧凑的整数序列,替代连续声学特征,显著降低带宽与算力开销;
跨模态融通:把语音、音乐、环境声“抽象成token”,让它们自然接入大语言模型(LLM);
下游性能强大:在语音识别、TTS、音乐生成等任务上,有好的性能。
论文贡献一览
贡献 | 亮点 |
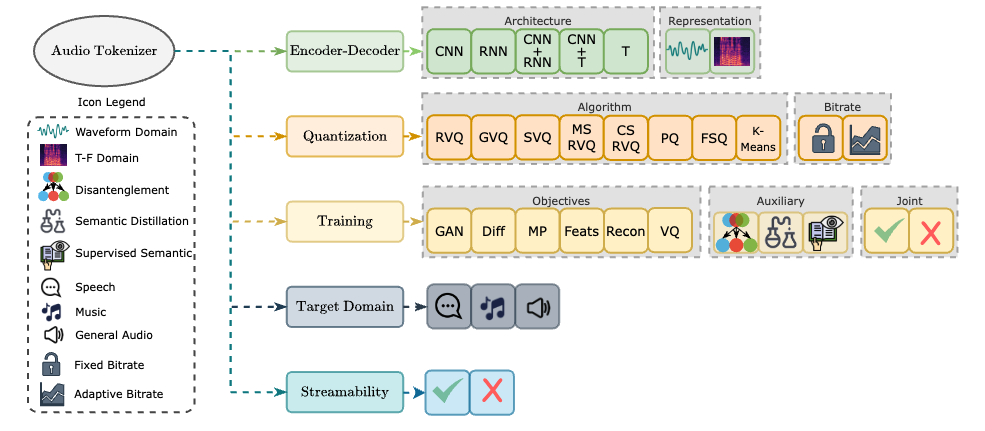
系统化分类 | 从编码-解码结构、量化方法、训练范式、可流式化、应用领域五条维度,将主流方法细颗粒度整理。 |
统一基准 | 覆盖语音/ 音乐 / 通用音频三大领域,统一评测重建质量、下游任务表现、声学语言建模能力。 |
公平对比 | 在受控实验下复现十余款热门tokenizer,量化优劣、揭示 trade-off。 |
开源资源 | 提供完整结果表、配置脚本与tokenizer 数据库,助力后续研究快速上手。 |
核心团队分工
Pooneh Mousavi:总体统筹、调查 & 基准设计
Haibin Wu + Pooneh Mousavi + Anastasia Kuznetsova:taxonomy 设计
Jiatong Shi: control setting 实验
Haibin Wu + Jiatong Shi + Darius Petermann:重建实验
Adel Moumen:SpeechLM 评测
Artem Ploujnikov:TTS 评测
Gallil Maimon: AudioLM 实验
Haici Yang: MusicLM 测评
所有核心成员均深度参与写作与润色;多位导师提供了关键反馈。
致谢
感谢Dongchao Yang分享SQ-Codec 实战经验,对分类体系提出建设性意见;感谢Jinchuan Tian在TTS 方向的讨论。
