
 语音小管家
在语音通信与人机交互场景中,噪声始终是语音质量和识别准确率的最大干扰之一。语音增强(Speech Enhancement, SE)技术旨在从嘈杂的语音中恢复出清晰、自然的干净语音,在语音通话、助听器、语音识别前端等应用中发挥着至关重要的作用。近年来,生成式方法(如语言模型和扩散模型)在语音增强领域展现了强大的建模能力。然而,它们也面临两大难题:语言模型方法存在量化损失,导致音质下降与说话人信息丢失;而扩散模型虽然效果优秀,但推理速度极慢,难以应用于实时系统。
针对以上问题,西工大音频语音与语言处理研究组(ASLP@NPU)与华为合作,提出了一种基于流匹配(Flow Matching)的生成式语音增强框架 —— FlowSE。相关成果论文“FlowSE: Efficient and High-Quality Speech Enhancement via Flow Matching”已被语音处理顶级会议 INTERSPEECH 2025 接收。该方法引入流匹配新范式,以“一步式建模”替代扩散的迭代过程,结合Diffusion Transformer(DiT)骨干网络,在保持增强质量的同时,将推理速度提升一个数量级。FlowSE 支持可选文本辅助输入,在有无语音转录信息的条件下均可灵活运行,实现高质量、低延迟、强鲁棒的语音增强。现对该论文进行简要的解读和分享。
论文题目:FlowSE: Efficient and High-Quality Speech Enhancement via Flow Matching
作者列表:王子谦,刘子楷,朱新发,朱毅可,刘铭帅,陈君,肖龙帅,翁超,谢磊
合作单位:华为
论文原文:https://arxiv.org/abs/2505.19476
背景动机
随着生成模型在语音领域的应用不断深入,越来越多的研究开始尝试使用语言模型(Language Models, LM)和扩散模型(Diffusion Models)来实现更自然、更真实的语音增强。尽管这些方法取得了一定成果,但它们在实际应用中仍存在显著瓶颈。
语言模型方法的“瓶颈”:语言模型类方法(如SELM[1]、MaskSR[2])通常借助离散编码器将语音量化为 token,并通过语言模型完成恢复。然而,量化过程本身会丢失连续语音的重要细节,导致增强语音中出现明显的伪影与失真,最终影响可懂度与说话人相似度。
扩散模型方法的“高开销”:扩散模型类方法(如CDiffuSE[3]、StoRM[4])通过多轮去噪步骤逐步恢复语音,可以获得高质量增强结果。然而,这种逐步采样过程 通常需要数百轮推理,带来极大的计算成本与高延迟,难以应用在实时通信、在线识别等低时延场景中。
为解决上述问题,研究者们将目光投向了Flow Matching[5] —— 一种新兴的高效生成建模范式。与扩散模型不同,Flow Matching 通过学习一个连续的速度场,在单步内完成从“噪声语音”到“干净语音”的映射,无需复杂采样流程,既兼顾效果,又兼顾速度。然而,已有 Flow Matching 应用大多依赖 U-Net 或 VAE 架构[6, 7],难以捕捉语音中跨时间-频率的长距离依赖结构;同时,也缺乏对文本辅助信息的有效整合方式。
基于上述观察,本文提出的 FlowSE 旨在解决以下三个核心挑战:
如何在不引入离散量化的情况下,实现高质量语音恢复?
如何兼顾增强质量与推理效率?
如何灵活引入语音文本信息,进一步提升语音理解与还原效果?
提出方法
为实现高质量、低延迟、强泛化的语音增强能力,FlowSE 采用了端到端的 Flow Matching 框架,整体架构如图所示,主要由三大模块组成:
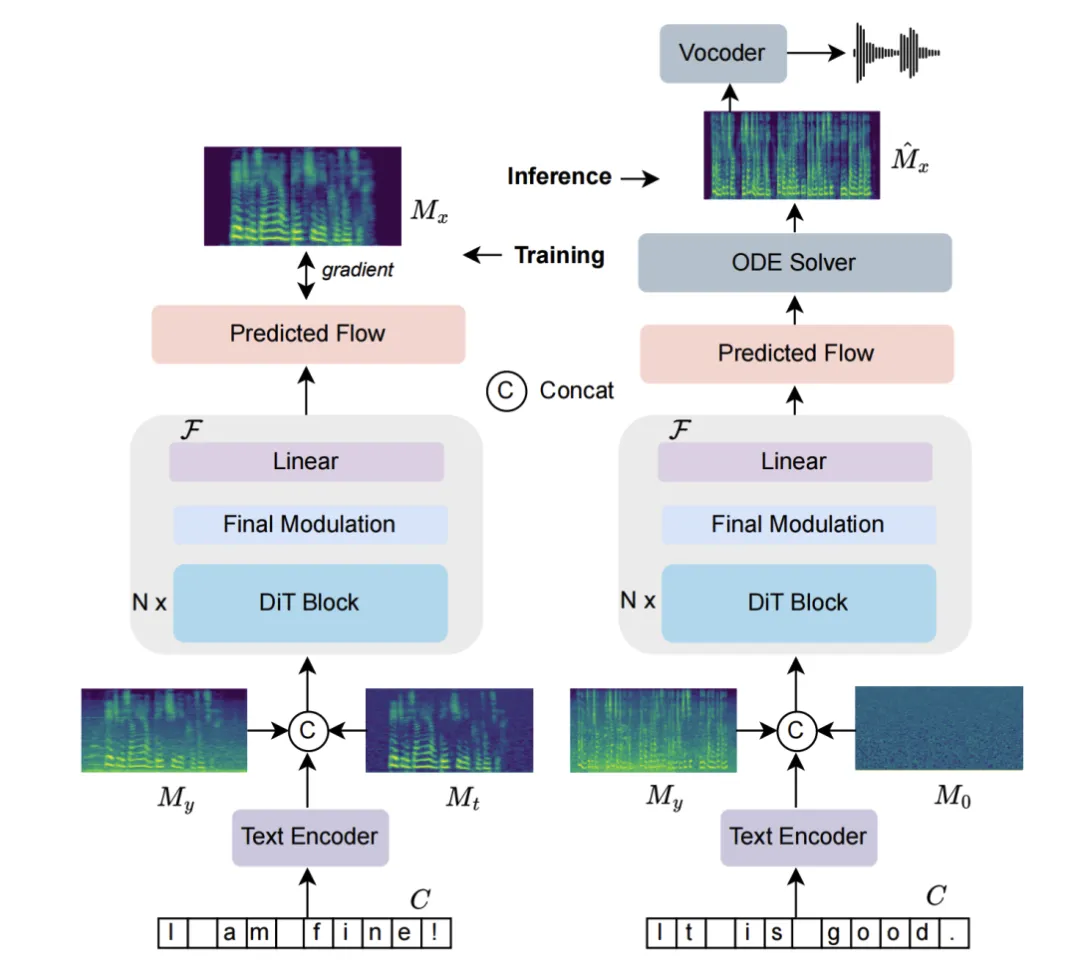
图1 FlowSE 模型结构图
输入处理
与多数语音建模任务类似,FlowSE 以 Mel 频谱图作为建模空间,直接使用 STFT 与 Mel 滤波器将原始语音信号转换为二维时间-频率表示。相比在波形上建模,这种表示更稳定、更易优化,也能减少模型参数量。
此外,FlowSE支持可选的 文本输入(Transcript),当提供语音转录信息时,模型可以更好地学习语音结构、强化语义对齐,提升低信噪比场景下的恢复能力。
核心模块
FlowSE 的核心在于引入了一个基于 Diffusion Transformer(DiT)[8]骨干网络的 Flow Matching 模块,它负责学习从“噪声语音”到“干净语音”的连续变换过程。
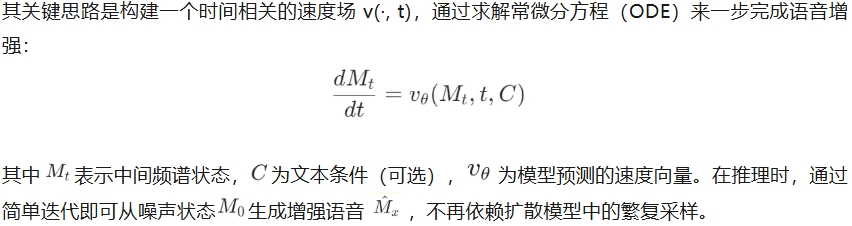
相比 U-Net 或 VAE 结构,DiT 拥有更强的时序建模与跨频率依赖捕捉能力[9],能更好还原复杂语音结构。
文本条件建模
FlowSE 中的文本信息由独立的ConvNeXt V2 [10]文本编码器处理,提取字符级嵌入后与 Mel 特征联合建模:
文本输入可在训练时随机置空,以增强模型在“无文本”场景下的鲁棒性。
在极端噪声环境中,有效的语音-文本对齐信息能显著改善增强效果。
这种设计让 FlowSE 既能在通用无监督场景下独立运行,也能在“语音识别 + 增强”协同任务中获得进一步性能增益。
波形还原
最后,FlowSE 使用预训练的 Vocos [11] 或BigVGAN [12]等高保真神经声码器,将增强后的 Mel 频谱转换回可听波形,实现音频级输出。声码器模块无需联合训练,提升整体训练效率;也便于后续模块替换与升级,具备良好可扩展性。
实验
为全面验证 FlowSE 的性能,我们在公有基准数据集、模拟极端噪声环境数据集上测试多项主观与客观指标,并对比了当前主流的语音增强模型。
训练数据
我们构建了大规模训练集,融合 WeNetSpeech[13]、GigaSpeech[14]、VCTK[15]、DNS Challenge[16]等语音数据;噪声来源包括 WHAM![17]、DEMAND[18]、房间冲击混响来自OpenSLR26,OpenSLR28[19];使用 Whisper 模型自动生成语音转录,用于训练文本条件版本。
测试数据
我们使用 DNS Challenge 2021官方测试集,评估真实场景下的增强能力;同时构建模拟测试集,将 VCTK 干净语音与未知噪声混合,SNR 从 -5 dB 至 10 dB,检验极端条件下模型鲁棒性。
评估指标
DNSMOS:模拟主观打分系统,衡量增强语音的自然度;
SpkSim(说话人相似度):通过 WeSpeaker [20]提取声纹,衡量增强语音对说话人身份的保持程度;
WER(词错误率):使用 Whisper 自动转录结果,评估增强后语音的可懂度;
RTF(实时因子):量化推理时间开销,衡量是否具备实时能力。
对比实验
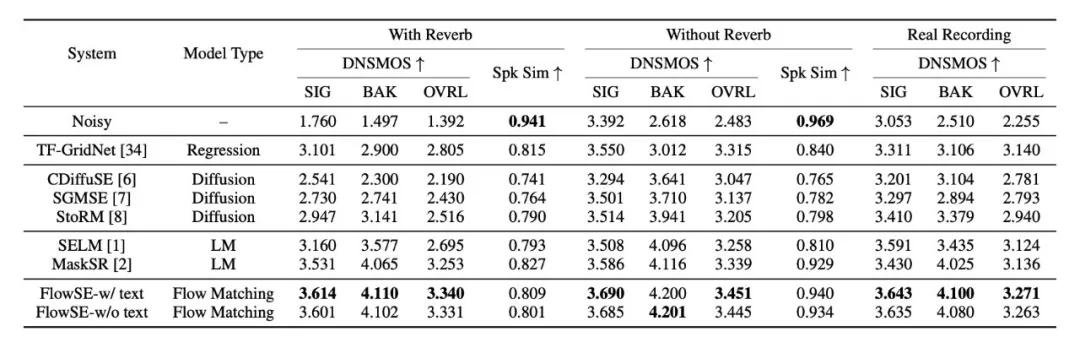
从表1可以看到,FlowSE 在音质(DNSMOS)和说话人保真度(Spk Sim)上均超越现有最优方法,特别是在真实录音场景中表现尤为稳定,且有文本与无文本版本性能差距极小,展现了极强的稳健性与可迁移性。
表1 DNS Challenge 三种场景下各方法效果对比
消融实验
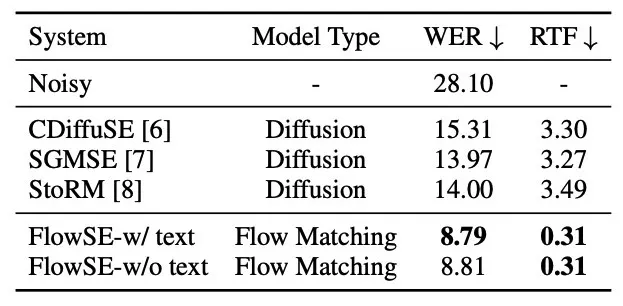
如表2所示,相比 RTF 超过 3 的扩散模型,FlowSE 实现了小于 0.31 的实时因子(即每秒语音只需约0.31秒推理),在保持增强质量的前提下,推理速度提高了10倍+。同时,显著降低的 WER 也表明增强语音并没有增大失真,更容易被后端识别系统准确转录。
表2 模拟测试集上各模型 WER 与 RTF
参考文献
[1] Z. Wang, X. Zhu, Z. Zhang, Y. Lv, N. Jiang, G. Zhao, and L. Xie, “Selm: Speech enhancement using discrete tokens and language models,” in ICASSP 2024-2024 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2024, pp. 11 561–11 565.
[2] X. Li, Q. Wang, and X. Liu, “Masksr: Masked language model for full-band speech restoration,” arXiv preprint arXiv:2406.02092, 2024.
[3] Y.-J. Lu, Z.-Q. Wang, S. Watanabe, A. Richard, C. Yu, and Y. Tsao, “Conditional diffusion probabilistic model for speech enhancement,” in Proc. ICASSP. IEEE, 2022, pp. 7402–7406.
[4] J.-M. Lemercier, J. Richter, S. Welker, and T. Gerkmann, “Storm: A diffusion-based stochastic regeneration model for speech enhancement and dereverberation,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 31, pp. 2724–2737, 2023.
[5] Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel, and M. Le, “Flow matching for generative modeling,” in The Eleventh International Conference on Learning Representations, 2023. [Online]. Available: https://openreview.net/forum id=PqvMRDCJT9t
[6] S. E. Eskimez, X. Wang, M. Thakker, C. Li, C.-H. Tsai, Z. Xiao, H. Yang, Z. Zhu, M. Tang, X. Tan et al., “E2 tts: Embarrassingly easy fully non-autoregressive zero-shot tts,” in 2024 IEEE Spoken Language Technology Workshop (SLT). IEEE, 2024, pp. 682– 689.
[7] A. A. Nugraha, K. Sekiguchi, and K. Yoshii, “A flow-based deep latent variable model for speech spectrogram modeling and enhancement,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 28, pp. 1104–1117, 2020.
[8] W. Peebles and S. Xie, “Scalable diffusion models with transformers,” in Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023, pp. 4195–4205.
[9] Y. Chen, Z. Niu, Z. Ma, K. Deng, C. Wang, J. Zhao, K. Yu, and X. Chen, “F5-tts: A fairytaler that fakes fluent and faithful speech with flow matching,” arXiv preprint arXiv:2410.06885, 2024.
[10] S. Woo, S. Debnath, R. Hu, X. Chen, Z. Liu, I. S. Kweon, and S. Xie, “Convnext v2: Co-designing and scaling convnets with masked autoencoders,” in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2023, pp. 16 133–16 142.
[11] H. Siuzdak, “Vocos: Closing the gap between time-domain and fourier-based neural vocoders for high-quality audio synthesis,” arXiv preprint arXiv:2306.00814, 2023.
[12] S.-g. Lee, W. Ping, B. Ginsburg, B. Catanzaro, and S. Yoon, “Bigvgan: A universal neural vocoder with large-scale training,” arXiv preprint arXiv:2206.04658, 2022.
[13] Z. Yao et al., “Wenet: Production oriented streaming and nonstreaming end-to-end speech recognition toolkit,” in Proc. Interspeech. ISCA, 2021, pp. 4054–4058.
[14] G. Chen et al., “GigaSpeech: An Evolving, Multi-Domain ASR Corpus with 10,000 Hours of Transcribed Audio,” in Proc. Interspeech, 2021, pp. 3670–3674.
[15] C. Veaux, J. Yamagishi, and S. King, “The voice bank corpus: Design, collection and data analysis of a large regional accent speech database,” 11 2013, pp. 1–4.
[16] C. K. Reddy et al., “The INTERSPEECH 2020 Deep Noise Suppression Challenge: Datasets, Subjective Testing Framework, and Challenge Results,” in Proc. Interspeech, 2020, pp. 2492–2496.
[17] G. Wichern, J. Antognini, M. Flynn, L. R. Zhu, E. McQuinn, D. Crow, E. Manilow, and J. L. Roux, “Wham!: Extending speech separation to noisy environments,” arXiv preprint arXiv:1907.01160, 2019.
[18] J. Thiemann, N. Ito, and E. Vincent, “The diverse environments multi-channel acoustic noise database (demand): A database of multichannel environmental noise recordings,” in Proceedings of Meetings on Acoustics, vol. 19, no. 1. AIP Publishing, 2013.
[19] T. Ko, V. Peddinti, D. Povey, M. L. Seltzer, and S. Khudanpur, “A study on data augmentation of reverberant speech for robust speech recognition,” in Proc. ICASSP. IEEE, 2017, pp. 5220– 5224.
[20] H. Wang, C. Liang, S. Wang, Z. Chen, B. Zhang, X. Xiang, Y. Deng, and Y. Qian, “Wespeaker: A research and production oriented speaker embedding learning toolkit,” in IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2023, pp. 1–5.
