
 语音小管家
语音与语言如何连接,机器耳朵与大脑如何高效协同?本文工作给出了探索回答。在自动语音识别(ASR)中,基于音素的多语种预训练与跨语言微调因其出色的数据利用效率和相较于基于子词模型的性能优势,正受到越来越多的关注。然而,传统的加权有限状态转换器(WFST) 解码方法存在着流程复杂、难以利用大语言模型(LLMs)等问题。
因此,本文提出了一种基于大语言模型的音素转字素(音字转换)解码方法(LLM-P2G),用于构建基于音素的 ASR 系统。该方法由两部分组成:语音转音素(S2P) 和 音素转字素(P2G)。但一个关键挑战在于,级联的 S2P 与 P2G 结构可能存在信息丢失,从而影响整体识别效果。为了解决这一问题,本文提出了两种训练策略:噪声音素数据增强(DANP)和随机 Top-K边缘化训练与解码(TKM)。
实验结果表明,在跨语言语音识别任务中,本文提出的 LLM-P2G 在波兰语和德语上相较于 WFST 系统分别实现了 3.6% 和 6.9% 的相对词错误率降低,表现出优异的准确性和泛化能力。以音素连接语音与语言,用大语言模型替代WFST,更好实现了机器耳朵与大脑的高效协同,为建立高效率语音识别新范式迈出坚实一步。
背景:传统WFST解码流程繁琐复杂
在语音识别(ASR)研究中,已有一个日益明确的趋势:基于音素(Phoneme)的建模正在重新获得研究者的关注。尤其在多语种场景下,这一建模方式因其良好的跨语言迁移能力和较高的数据利用效率,逐步展现出强大潜力。近期工作 Whistle[1]进一步验证了弱监督音素建模在多语种任务中的有效性与竞争力,为后续研究提供了关键基础。
最新进展可参考Whistle论文:
Saierdaer Yusuyin, Te Ma, Hao Huang, Wenbo Zhao, Zhijian Ou. Whistle: Data-Efficient Multilingual and Crosslingual Speech Recognition via Weakly Phonetic Supervision. IEEE/ACM Transactions on Audio, Speech and Language Processing, 2025.
https://ieeexplore.ieee.org/abstract/document/10923750
https://arxiv.org/abs/2406.02166
(开源发布Whistle: 基于弱音素监督推进数据高效多语言和跨语言语音识别)
然而这类模型以音素连接语音与语言获得高效率多语种语音识别同时,带来一个新挑战:如何高效、灵活地解码(也就是从语音到音素后再到字素)?
基于音素的语音识别系统,依赖WFST(加权有限状态转换器)来完成从音素到文字的映射,其系统流程如图(a)所示。
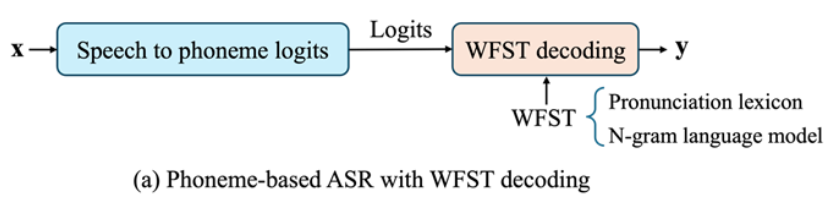
这种方法虽然效果好,但问题也很明显:
解码流程复杂,难以灵活扩展到多语种;
无法有效利用大语言模型(LLM)的上下文建模能力;
解码模块与语言建模割裂,整体系统结构臃肿、维护成本高。
方法:音素建模与大语言模型结合
新框架:LLM-P2G,大模型驱动的音字转换解码
为了突破上述挑战,本文提出了一个新框架:LLM-P2G(LLM-based Phoneme-to-Grapheme),如图(b)所示。
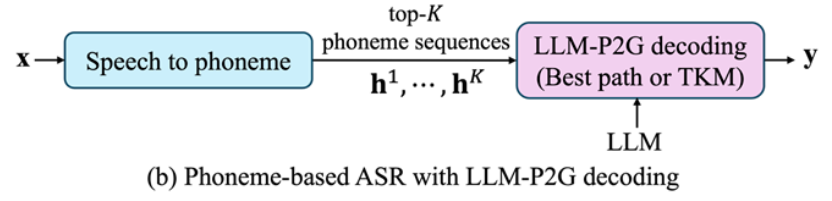
它把整个ASR过程分成两个阶段:
S2P(Speech-to-Phoneme):基于音素的声学模型,将语音转为音素序列;类似机器耳朵,用于声音的辨识,可以多语言共享训练得到一个声学基座。
P2G(Phoneme-to-Grapheme):可以使用一个多语种大语言模型(如mT5[2])将音素转为文字,类似机器大脑。
这个新框架看似简单,实际上却有非常大的优势:
可以利用 LLM 强大的语言能力;
能灵活适配多语种、低资源语言;
摆脱 WFST 解码图构建的限制,模块清晰,维护成本低。
挑战:两阶段模型的“信息断裂”
将S2P和P2G串联起来后,面临一个新的问题:音素信息可能在传递过程中不完整或带有噪声,导致错误在 P2G 阶段进一步传播,影响整体识别效果。
本文发现,直接把声学模型预测的音素输入P2G模型,效果并不理想——因为测试时音素预测是带有噪声的;另外LLM也需要多样输入才能训练得更好。
创新点一:DANP(Noisy Phoneme Augmentation)
本文引入了一种“噪声音素数据增强”训练策略:
利用采样或束搜索等方式,生成多个音素候选序列;
模拟声学模型的不确定性;
训练P2G模型时输入这些带有带噪音素序列,提高模型鲁棒性。
这样一来,LLM在训练时就学会如何从真实世界中可能出现的音素噪声中恢复出正确文字。
创新点二:TKM(Top-K Marginalized)
进一步地,本文提出了一种训练与解码的新策略:随机选取 Top-K 的音素路径,并在训练和推理中进行边缘化处理。简而言之:
不再只用一条音素路径;
而是考虑多条高概率路径的组合结果;
TKM是对以音素连接语音与语言的隐变量模型的比较好的近似。
与 DANP 主要在训练阶段引入多样性不同,TKM 将多候选路径的使用扩展到了训练与解码两个阶段,进一步提升了模型在真实语音分布下的表现能力。
这一思想受到了自然语言问答中RAG(Retrieval-Augmented Generation)[3]方法的启发。RAG 在文本生成中,从多个检索结果中进行概率加权;TKM则在语音识别中,从多个音素路径中进行加权组合,生成文字序列。两者都可视为隐变量模型的训练和解码。
本文用如下近似边缘化公式对其训练:
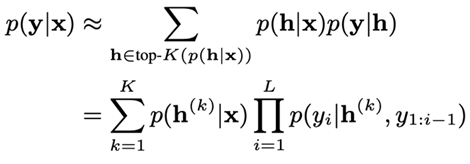
该公式表示,对每个高概率音素路径h(k)分别计算其出现概率与对应的文本生成概率,再整体加权求和,得到最终的输出概率 p(y|x)。这是一种多候选解码策略,有效缓解了两阶段系统中的错误传播问题。
实验结果与分析
核心结果:强大的跨语言泛化能力,超越WFST解码
本文在两个低资源语言——波兰语(Polish)与德语(German)上进行跨语言语音识别任务,对比评估了传统 WFST 解码与本文提出的 LLM-P2G 解码框架,覆盖了低资源(130 小时)与极低资源(20 小时)两种场景。
实验采用Whistle[1]作为声学基座,进行跨语言音素或子词微调(基线);在此音素声学模型基础上,在大语言模型mT5[2]上进行P2G的DANP和TKM微调。实验结果如下表所示。
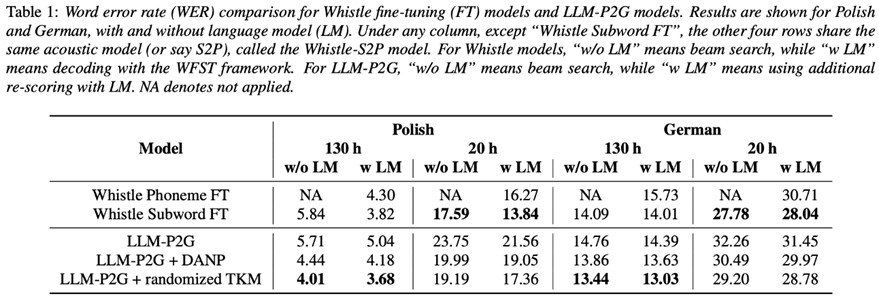
在 130h 训练条件下,波兰语和德语的LLM-P2G + TKM(3.68% 和13.03%)都超越了 WFST 解码(3.82%和14.01%),达到新的 SOTA。
在 20 小时训练条件下,虽然整体性能有所下降,但 DANP 与 TKM 显著提升了 LLM-P2G 的鲁棒性,德语模型在极低资源下依然取得了可比的性能。
消融分析:
(1)LLM-P2G 推理效率接近传统WFST模型,兼具性能与可用性
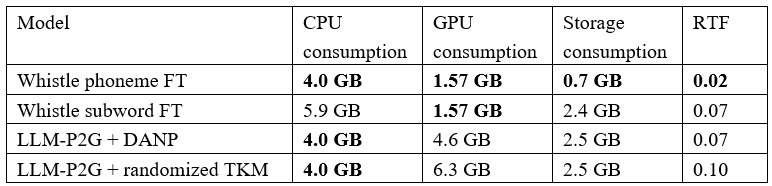
LLM-P2G模型与WFST模型解码过程中的CPU内存、GPU显存、存储占用与实时因子对比结果下表所示:
RTF(实时因子)对比:
LLM-P2G + DANP 的 RTF 为 0.07,与传统的 Whistle subword FT 持平,意味着加入大模型后的解码效率仍处于可接受范围。
LLM-P2G + TKM 由于涉及多路径边际化计算,RTF 上升至 0.10,但仍可用于大多数应用场景。
GPU 显存对比:
LLM-P2G + DANP 约为 4.6 GB,TKM 上升到 6.3 GB,相比传统模型(1.57 GB)明显上升。
这反映了使用 LLM(如 mT5)在 P2G 阶段对 GPU 资源的需求更高,但仍在主流显卡(如 8GB~16GB)的处理能力范围内。
CPU 内存以及存储对比:
LLM-P2G 模型CPU 占用和 Whistle phoneme FT 持平(4.0 GB),低于子词微调(Whistle subword FT)模型(5.9 GB)。
存储空间消耗略高(2.5 GB),但相比子词WFST模型没有明显劣势。
(2)LLM-P2G 是否真优?看显著性结果
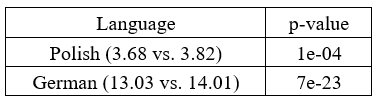
本文对两个语言的LLM-P2G最优模型(3.68和13.03)与WFST最优模型(3.82和14.01)进行显著性检验[4],结果如下表所示
显著性非常强(小于0.01)
两个 p-value 都远小于常用显著性水平(0.01),说明结果几乎不可能是偶然出现的,而是模型能力真实提升的体现。
即使在波兰语上的相对 WER 改进不大(3.82 → 3.68),也能获得显著结果,说明模型性能波动很小,误差分布稳定;
在德语上,提升更明显(14.01 → 13.03),p值更小,进一步验证 LLM-P2G + TKM 的鲁棒性与优势。
(3)对比主流方法(SpeechLLM[5]):音素接口 vs 映射器接口,谁是更优解?
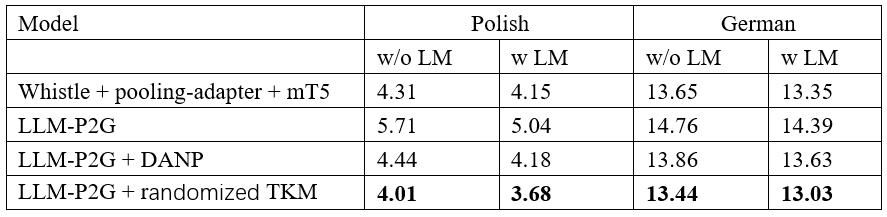
SpeechLLM 系列(Whistle + adapter + mT5) 相比传统的 WFST 解码基线有优势,但弱于TKM方法训练的LLM-P2G;
究其原因,音素是更自然的语音单位,具备语言可迁移性,天然支持多语种、低资源语言;LLM-P2G采用音素作为语音与语言的中间接口,不仅具有可解释性,而且音素是离散符号(token),与大语言模型的输入空间自然相融。映射适配器(adapter)是黑箱,需依靠映射器将声学特征投射到语言空间,映射器对每种语言需要做复杂的适配,性能受限。
总结
本文提出了 LLM-P2G,一种融合音素建模与大语言模型的全新解码框架,有效克服了传统 WFST 解码流程复杂、扩展性差、无法利用 LLM 的局限。通过引入噪声音素增强(DANP)与 Top-K 边缘似然(TKM)两项关键优化策略,缓解了声学与语言分解建模带来的信息丢失问题,在跨语言识别任务中显著提升了准确率与鲁棒性。
尽管 LLM-P2G 相比WFST,在推理成本与效率方面稍有不足,但其在识别性能上的显著优势,以及对多语种和低资源语言的泛化能力,使其成为未来更具前景的新一代方案。此外,与主流映射器方案 SpeechLLM 相比,验证了以音素连接语音与语言,基于音素接口方式融合大语言模型的语音识别新范式的可行性与优势。以音素连接语音与语言的新框架的更多潜力,值得进一步探索。
参考文献
[1] S. Yusuyin, T. Ma, H. Huang, W. Zhao, and Z. Ou, “Whistle: Data-efficient multilingual and crosslingual speech recognition via weakly phonetic supervision,” IEEE Transactions on Audio, Speech and Language Processing, pp. 1–14, 2025.
[2] L. Xue, N. Constant, A. Roberts, et al., “mT5: A massively multilingual pre-trained text-to-text transformer,” in Proceedings of the 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies. Association for Computational Linguistics, 2021, pp. 483–498.
[3] P. Lewis, et al., “Retrieval-augmented generation for knowledge-intensive nlp tasks,” Advances in Neural Information Processing Systems, vol. 33, pp. 9459–9474, 2020.
[4] L. Gillick and S. J. Cox, “Some statistical issues in the comparison of speech recognition algorithms,” in International Conference on Acoustics, Speech, and Signal Processing (ICASSP), 1989.
[5] S. Rajaa and A. Tushar, “SpeechLLM: Multi-Modal LLM for Speech Understanding,” [Online]. Available: https://github.com/skit-ai/SpeechLLM
