
 语音小管家
本文由清华大学与腾讯AI Lab合作,研究基于大语言模型与检索增强生成(RAG)技术的自动语音风格匹配文本转语音合成(TTS)系统。当前主流TTS方法虽已实现高保真语音合成,但在语音风格控制方面仍依赖人工设定的提示语,难以自适应待合成文本内容的变化。
为解决这一问题,本文提出了一种全新的AutoStyle-TTS框架,通过构建高质量语音风格知识库并结合LLaMA、PER-LLM-Embedder和Moka多模态风格嵌入提取器,实现了根据待合成文本自动匹配风格提示并进行灵活切换。在多种语音数据集上进行主客观实验,结果表明本方法在风格匹配准确性和语音连贯性方面均优于现有方法,具有实际应用价值。
背景与动机介绍
语音合成技术在人机交互、播客生成和数字助理等场景中正扮演着日益重要的角色。作为语言表达的重要载体,合成语音不仅需要具备清晰的发音和正确的语义传达,更应展现出与语境一致的风格与情感变化,以提升交流的自然度与沉浸感。
以往研究通常通过人工设定语音提示或固定风格编码的方式控制语音风格,这些方法存在两个明显局限:一是手动选择风格提示词效率低下且缺乏灵活性;二是风格与待合成文本内容之间常出现脱节,导致合成语音缺乏连贯性与表现力。而在播客、故事叙述等复杂语境下,风格的自然过渡尤为关键。为此,继续一种能够根据待合成文本上下文自动匹配并灵活切换语音风格的方法。
主要贡献
为解决上述问题,本文提出了一个新型的能根据待合成文本实现自动语音风格匹配的语音合成框架AutoStyle-TTS,用于解决以往系统在可用性以及内容与风格脱节方面的缺陷。为了实现自动选择匹配的风格提示,我们引入了检索增强生成(RAG)机制,结合多模态嵌入提取与风格知识库检索,能够根据待合成文本语义与用户偏好自动选取最合适的风格提示,进而生成风格自然、语境一致的语音输出。通过主客观实验验证,本文方法显著提升了语音生成系统的可用性和生成语音的一致性,在风格匹配度与语音连贯性方面均优于现有TTS系统,展现出良好的实际应用价值和应用前景。
研究方案
模型整体架构
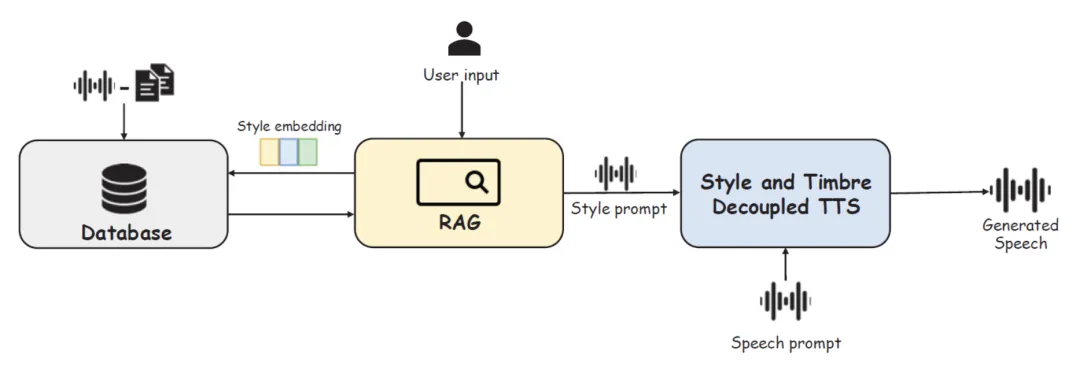
模型整体架构如上图所示,主要包括三个模块:
语音风格知识库:该知识库由文本与语音语料构建而成,包含高质量的语音片段,涵盖不同的情感表达、语调变化等内容。具体来说,它由提取出的风格嵌入与对应音频组成的数据对构成。
RAG风格选择模块:该模块根据用户输入的查询分析风格信息,从检索式知识库中提取最相关的音频数据,并将其组织为风格提示,供合成模块使用。
风格与音色解耦的语音合成模块:该模块接收来自RAG风格选择模块的风格提示,以及用户指定的零样本音色提示,提取所需的风格和音色,用于生成目标语音。
语音合成模块
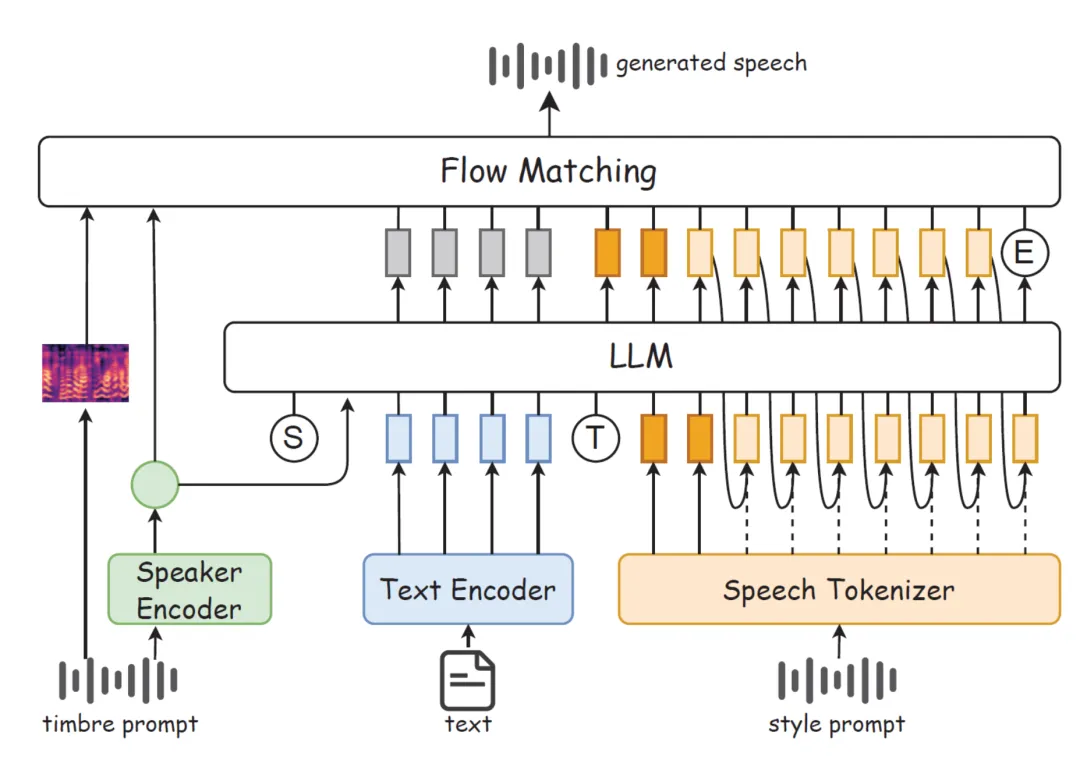
我们以CosyVoice为主干结构,并对其部分模块的输入进行了修改。在前端,音色信息由基于CAM++的Speaker Encoder提取得到的说话人嵌入向量提供;而内容与风格信息则通过文本编码器Text Encoder及语音分词器Speech Tokenizer提取的文本和语音token表示。整个语音生成任务被建模为两个阶段:大语言模型(LLM)建模阶段和流匹配(Flow Matching)阶段。其中,风格信息仅注入到LLM建模阶段,而说话人嵌入在两个阶段中都参与,以用于全局向量控制。
在LLM建模阶段,输入序列的结构为:
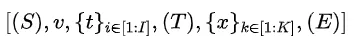
其中(S)表示序列开始,(T)表示文本token与语音token的过渡点,(E)表示序列结束;v是通过说话人编码器从提示语音中提取的说话人嵌入,包含丰富的音色信息;{t}是通过文本编码器从待合成文本中得到的token序列;{x}是从语音中提取的token,包含风格特征。该阶段的训练目标函数采用交叉熵损失。
流匹配阶段则负责根据上述生成的语音token序列,使用Flow Matching模型生成语音的梅尔谱(Mel-spectrogram)。该模块的输入包括:说话人嵌入向量、掩蔽后的梅尔谱特征、以及由LLM模块生成的语音token。在这些条件下,流匹配模型被训练为使其参数匹配真实语音数据的向量分布场。
语音风格知识库构造与检索
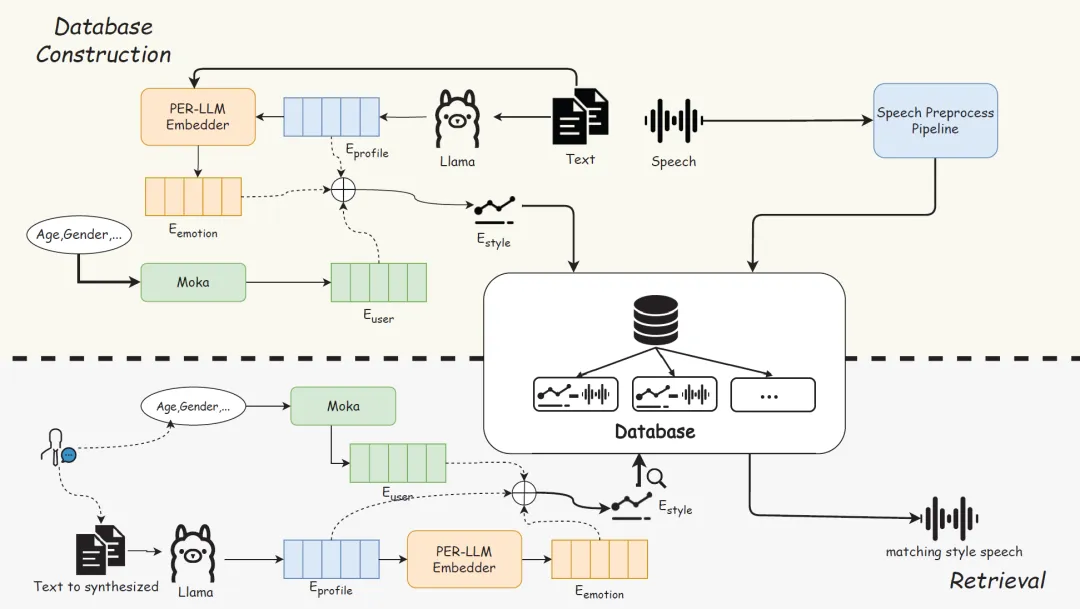
为了使系统能根据待合成文本内容灵活调整语音风格,提供更自然、贴合语境的听觉体验,我们设计并构建了一个语音风格知识库,为RAG模块提供支持。该外部知识库包含多种语境下的高质量语音样本,涵盖不同的情感表达变化、语调变化等特征。
语音风格知识库构建过程中,预处理方式和嵌入表示会影响检索效率与匹配准确率。为此,我们采取以下步骤:
1.切分语音:将原始语音按5到10秒切段,提升检索精度,适应不同长度文本。
2.预处理:包括降噪、说话人分离、基于语音活动检测(VAD)进行修剪。质量合格的片段通过语音识别(ASR)转写为文本,并整理为结构化数据。
3.嵌入提取:我们使用LLaMA 3.2、PER-LLM-Embedder和Moka三种模型提取风格嵌入,流程如下:
a.角色信息嵌入(profile):LLaMA 3.2提取反映说话角色的整体风格;
b.情绪嵌入(emotion):PER-LLM分析文本情绪与角色特征;
c.用户偏好嵌入(user):Moka提取用户的年龄、性别、地域等信息。
最终风格嵌入表示为:
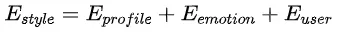
这些嵌入与语音片段组成可搜索的数据库,使用Milvus建立索引。语料来源包括部分Microsoft EXPRESSO数据集及其他高质量中英文语音,涵盖30位说话人,共计超过2000条语音片段。
在检索阶段,系统先判断是否需要检索,再进行增强处理,主要包括:首先,基于用户输入重写查询;其次,使用上述三个模型生成查询嵌入;最后,利用嵌入相似度,采用最大内积搜索在数据库中选出最相关的前K条记录。
实验验证
评测指标
本文采用了客观与主观相结合的评估方式。
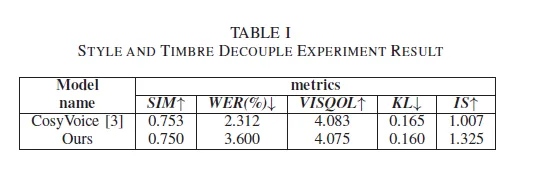
在客观指标方面,我们使用了五种评价标准:说话人相似度(SIM)用于衡量生成语音与参考语音的音色相似性;词错误率(WER)用于比较生成语音转写文本与参考文本之间的差异;VISQOL是用于评估语音感知质量的全参考型客观指标;KL散度衡量生成语音与真实语音在分布上的差异;Inception分数(IS)用于评估生成语音的多样性与真实性。
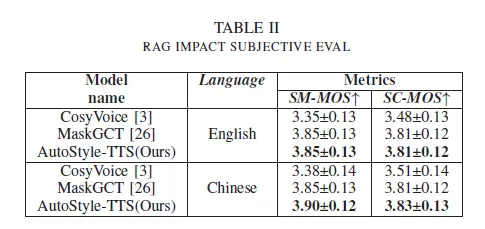
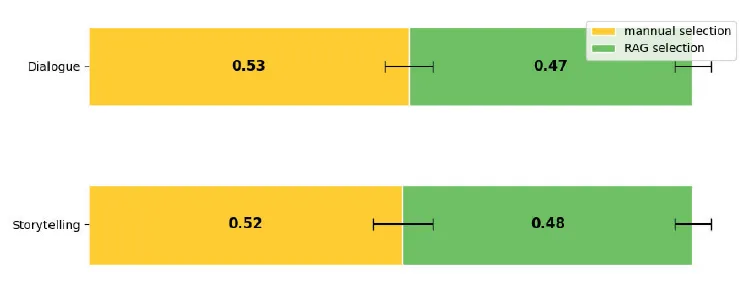
在主观评估方面,我们设计了两项平均意见评分(MOS)测试:风格匹配度评分(SM-MOS)用于衡量合成文本与合成语音风格之间的匹配程度;风格连贯性评分(SC-MOS)用于评估生成语音整体风格是否连贯、情感起伏是否自然。此外,我们还进行了AB测试,比较模型自动选择风格与人工选择风格之间的效果差异。
实验结果
为了验证我们的方法在不影响音色准确性和语音内容正确率的前提下能实现语音风格转换,我们选用了Common Voice和DiDiSpeech-2数据集中共100条样本作为测试集。使用Cosyvoice对每条样本生成4句语音;使用我们的方法为每条样本生成4种不同风格的结果。评估指标包括:WER(词错误率)、SIM(相似度)、VISQOL(语音质量)、KL散度、IS(风格多样性)。结果如下表所示,我们的方法在保持音色和语音质量的同时,实现了对风格的控制。此外,IS指标显示我们的方法生成风格更丰富,具有更强的灵活性。
RAG影响实验
我们对CosyVoice、MaskGCT以及我们的方法进行了主观评估,使用指标为SM-MOS(风格匹配)和SC-MOS(风格连贯性),共15人参与测试。测试集按语言分组,每组包含12条音频样本,涵盖故事叙述和对话场景。CosyVoice使用前一句生成的语音作为下一句的提示。实验结果如下表显示,我们的方法在两个指标上均明显优于CosyVoice,说明在文本风格匹配和语音连贯性方面有显著提升。
此外,我们还进行了AB偏好测试,让30名参与者比较我们的方法与人工挑选风格生成的语音。测试包含10段待合成文本(含叙述与对话),分别使用人工选择和自动选择的风格进行合成。结果如下图显示,我们的方法与人工挑选风格在用户偏好上表现相当,证明自动风格匹配机制不仅能替代繁琐的人工流程,还能保持语音风格与合成文本一致,提供自然连贯的听觉体验。
消融实验
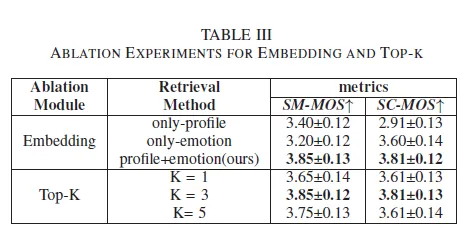
为验证LLaMA和PER-LLM-Embedder提取的角色特征与情境情绪在风格嵌入中的有效性,我们进行了消融实验。评估指标、测试人数和样本数与主实验相同。结果如下表,其中:only-profile表示仅使用角色特征匹配风格提示,only-emotion表示仅使用情境情绪匹配,K表示检索到的风格提示数量,K个提示拼接后输入TTS模块。
结果表明,同时使用角色特征和情境情绪时效果最佳。仅用角色特征时,SM-MOS(情感匹配)和SC-MOS(情绪连贯性)均下降。原因是缺乏单句情绪信息,导致合成语音与文本情绪不一致。仅用情绪信息时,SC-MOS下降,原因是缺乏整体角色控制,导致语音连贯性受损;但下降不明显,这是因为情绪提取时仍部分依赖角色信息,能保留部分全局一致性。我们还评估了风格提示数量对RAG方法的影响,随着提示数量增加,音色相似度提高,这是因为TTS可以获得更多风格信息;但当提示数量超过3条时,效果反而下降,可能的原因为不同来源的风格提示可能不一致、破坏了语音连贯性。
结论
本文提出了一种融合RAG技术的新型文本转语音(TTS)框架,该框架能够根据待合成文本提示和用户偏好动态调整语音风格,从而生成更自然、更具表现力的语音。我们构建了一个覆盖多种语境的语音风格知识库,并结合风格匹配策略与嵌入提取模块,实现了与待合成文本语境高度匹配的风格选择与应用。实验结果表明,该方法在合成文本与合成语音之间的风格匹配度以及语音整体风格连贯性方面均取得了优异效果。
