
 语音小管家
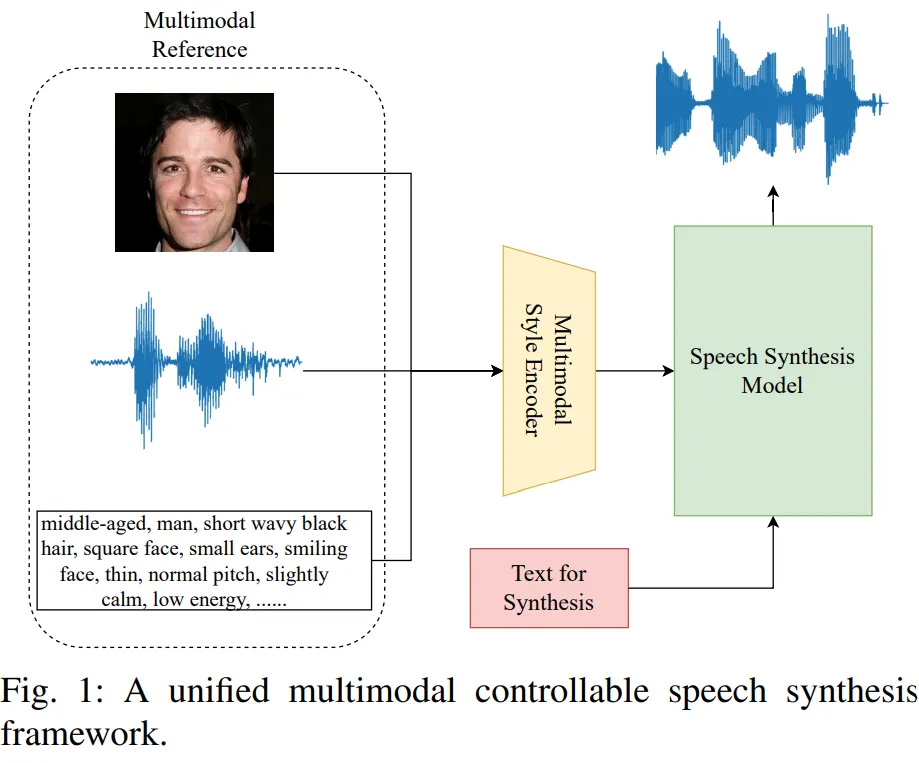
本文由清华大学与腾讯优图实验室合作,研究基于多模态数据的可控语音合成。现有的面部驱动的语音合成方法由于数据质量限制,在鲁棒性和泛化性方面存在缺陷;而文本描述驱动的语音合成方法则存在多样性有限和精细控制不足的问题。另一方面,尽管多模态驱动的语音合成方法旨在整合各种模态,但它们严重依赖完全匹配的训练数据,这显著限制了该类方法的性能和适用性。本文提出了一种三阶段的框架来应对这些挑战。实验结果表明,无论是基于面部的语音合成、还是基于文本描述的语音合成,所提方法均优于单模态基线方法,突显了其在生成高质量语音方面的有效性。
背景介绍
近年来,语音合成技术显著进步,生成语音的可懂度与自然度接近人类水平,但如何控制生成语音风格以满足个性化需求成为挑战。可控语音合成旨在从参考输入中提取音色、韵律和风格信息,进而生成高度一致且逼真的语音。
多模态输入为语音合成提供更实际的解决方案,但其依赖完全匹配的语音-面部-文本描述三元组数据,限制了数据质量与数量,制约模型性能。为此,本文提出新方法,将三元组数据需求转化为三种配对数据,分三阶段训练:先对齐面部与语音特征,再通过多模态数据训练文本编码器,最后利用高质量语音数据优化合成模型。实验表明,该方法优于单模态基线方法。
主要挑战与解决方法
可控语音合成主要有三个挑战:一是基于面部图像的合成方法因数据质量限制导致鲁棒性和泛化能力不足;二是基于文本描述的合成方法因特征组合有限导致多样性低且精细控制困难;三是多模态合成方法依赖完全匹配的三元组训练数据,导致数据质量和数量受限,模型性能与适用性不足。
对于第一个挑战,由于面部数据易受光照、姿态等因素影响且与语音特征映射复杂,本文采用监督学习、知识蒸馏与对比学习结合的方法训练面部编码器。通过共享权重分类损失强制面部特征学习语音模态的说话人标识信息,利用预训练人脸识别模型的相似性矩阵避免模式崩溃,并通过对比损失拉近同说话人跨模态特征,提升面部特征的判别性与泛化能力。
对于第二个挑战,由于文本描述依赖有限特征组合音色多样性不足,本文结合多模态数据联合训练文本编码器。通过同时输入文本描述-面部和文本描述-语音配对数据,扩展文本语义覆盖范围,并利用注意力池化生成句子级嵌入,支持自然语言自由描述。
对于第三个挑战,由于多模态三元组数据采集成本高且跨模态对齐困难,本文将训练过程拆解为三个阶段,利用人脸-语音、文本描述-面部、文本描述-语音三类配对数据替代三元组数据。通过分阶段对齐架构,先实现面部与语音特征共享嵌入空间对齐,再将文本嵌入分别与前两者对齐,并利用知识蒸馏损失保留跨模态相似性结构。
研究方案
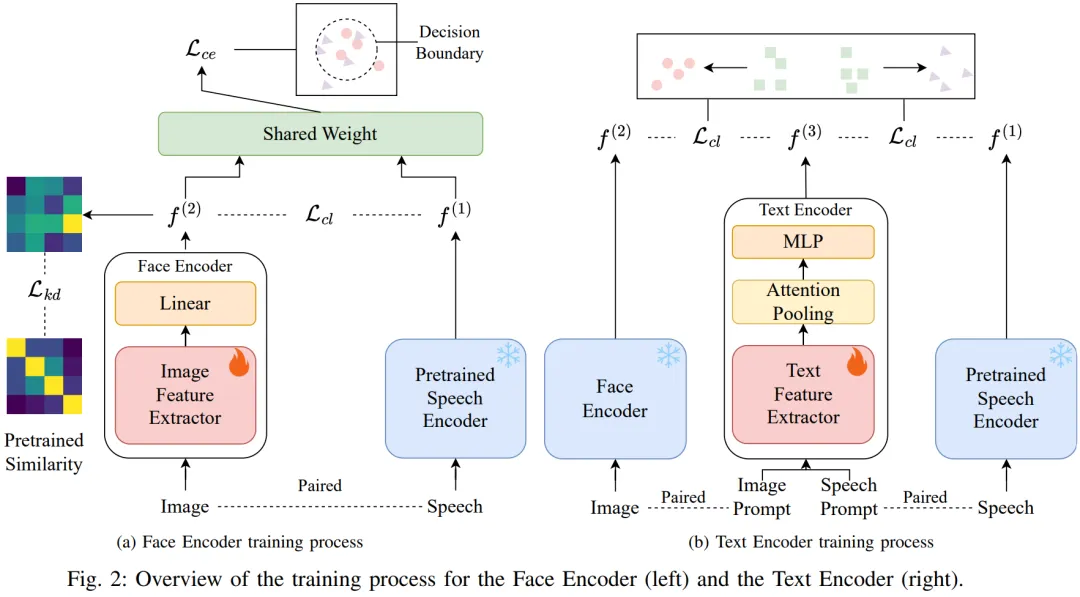
所提出的方法包括三个训练阶段:面部嵌入与语音嵌入对齐、文本嵌入与面部和语音嵌入对齐,以及训练语音合成模型。上图(a)展示了面部编码器的训练过程,其目标是使所提出的面部编码器与预训练的冻结语音编码器共享说话人空间。通过使用监督学习和知识蒸馏方法训练模型,使得基于面部的说话人表示变得更具判别性和泛化性。上图(b)展示了文本编码器的训练过程。通过使用面部-文本描述对和语音-文本描述对,文本编码器获得了从各种提示生成多样化说话人嵌入的能力。最后,本文使用高质量语音数据和语音说话人编码器训练语音合成模型。在推理阶段,所提出的模型可以使用来自所有模态的参考输入合成语音。
面部-语音对齐
在配对数据不足的情况下,强制两个不同模态之间的对齐通常面临泛化问题。为了训练面部编码器与预训练语音编码器对齐,同时提高其泛化能力,我们使用了三种不同的损失项Lce,Lkd,Lcl。
1、权重共享分类
为了增强模型对同一说话人不同图像的鲁棒性,我们在训练期间采用了分类损失。这种方法利用来自数据集的监督信息来提高模型的泛化能力。然而,直接使用交叉熵损失训练面部嵌入可能导致模型依赖面部模态的特征,而不是模态间共享的特征。因此,基于AMSoftmax,我们提出了一种模态间共享权重的分类损失,其公式如下:
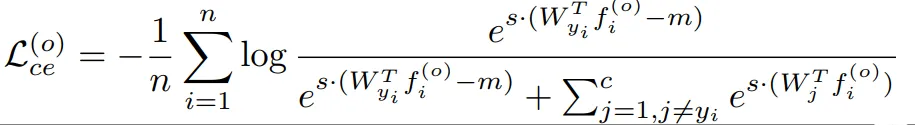
其中,n是小批量中的样本数量,W是共享的可学习参数,fi(o)是模态o中的说话人嵌入(o=1表示语音,o=2表示面部图像,o=3表示文本描述),yi是对应的说话人标签,c是说话人数量,α是平衡超参数,m和s是控制类别边界和规模的超参数。
通过使用共享权重,决策边界被引导到面部特征与语音特征重叠的区域。这允许从语音模态导出的说话人识别信息传递到面部编码器,迫使其学习共享的说话人特征。
2、联合知识蒸馏
预训练的人脸识别模型表现出高水平的泛化能力。然而,模态对齐后的表示空间可能会遇到模式崩溃问题(即,将不同的说话人映射到相似的表示)。知识蒸馏从教师模型中提取知识并将其与学生模型集成,从而增强学生的知识和性能。为了解决模式崩溃问题,我们尝试将两种模态的预训练模型的精细知识转移到面部编码器。考虑到学生和教师模型之间以及各种模态的教师模型之间的训练目标差异,我们从教师那里构建与任务无关的可转移知识项。
我们利用教师知识构建相似性矩阵,该矩阵有效地捕捉实例之间的高阶比较信息,并从教师那里提供更丰富的监督。具体而言,相似性矩阵为:
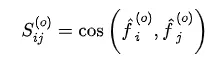
其中,fi(o)是来自预训练教师网络的嵌入,cos()是余弦相似度。不同模态的相似性矩阵进一步合并为统一的相似性矩阵:
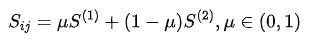
利用相似性矩阵,我们得到知识蒸馏损失为:
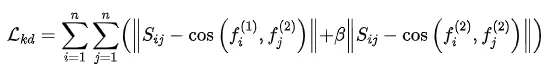
知识蒸馏损失项确保模型在训练过程中保留教师模型在不同模态之间以及同一模态内的相似性,从而提高模型的泛化能力。
3、对比学习对齐
对比学习是多模态对齐中常用的方法。它通过鼓励同一说话人的嵌入之间的相似性,同时确保不同说话人的嵌入之间的差异,在统一的空间中对齐不同模态的嵌入。这里我们使用较为常用的InfoNCE损失作为Lcl。通过对比学习,模型可以学习更通用的表示,使其能够适应新数据,提高其灵活性和实用性。
文本描述对齐
一旦获得语音和面部编码器,我们就可以使用它们来训练文本编码器。我们使用预训练的T5编码器模型作为文本特征提取器的主干。之后,我们利用注意力池化来获得句子级嵌入。
在训练阶段,同时使用来自三种模态(文本描述、面部和语音)的数据。我们首先获得面部-文本描述对和语音-文本描述对。然后,我们使用前面描述的对比学习对齐损失将文本嵌入分别与面部嵌入和语音嵌入对齐。
语音合成
前面所提出的架构与各种语音合成模型兼容。在本文中,我们使用端到端的VITS模型。在训练阶段,我们仅使用语音说话人编码器来确保模型性能。在推理阶段,我们可以利用来自各种模态的对齐编码器来实现个性化语音合成。
实验验证
实验设置
对于面部-语音对齐训练,我们使用广泛使用的LRS3数据集。它包含一个有4004个说话人的训练集和一个有457个说话人的测试集。对于文本编码器训练,我们使用了两个数据集:面部描述数据集CelebAText-HQ和语音描述数据集LibriTTS-P。CelebAText-HQ由15010张面部图像组成,每张图像包含10条手动标注的面部描述。LibriTTS-P包含2443个说话人和总共373868条描述。语音合成模型使用LibriTTS进行训练。
评估指标
我们进行了大量实验以验证所提架构的性能。在客观评估中,采用说话人验证中常用的等错误率(EER)和最小检测成本函数(minDCF)来评估说话人表征的判别能力。为验证模型生成音频的自然度及其与参考音频的相似度,我们开展了主观评估:5级自然度平均意见得分(N-MOS)和说话人一致性MOS测试(S-MOS)。对于基于文本描述的语音合成,除主观指标外,我们还使用轮廓系数(Silhouette Score)。生成样本的说话人嵌入按性别分为两个簇,通过轮廓系数量化数据簇的内聚性和区分度。较低的轮廓系数表示簇分布范围更广,即生成语音的多样性更优。
基于面部的语音合成结果
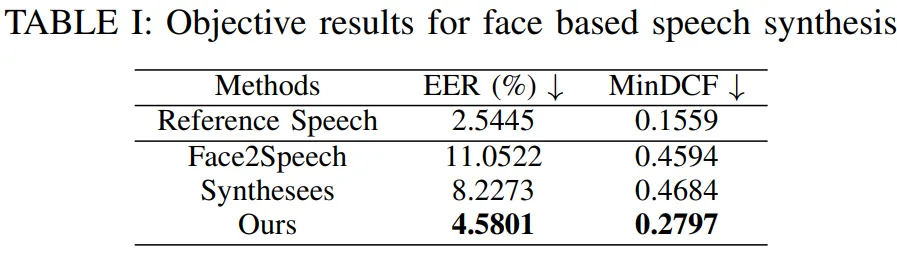
上表展示了从面部图像和语音中提取的说话人表征的EER和MinDCF结果。结果表明,我们的方法在判别未见说话人的能力和泛化能力上显著优于基线方法。仅使用对齐损失的Face2Speech方法表现最差,表明利用面部数据集的标签信息进行监督是有益的。此外,我们的方法也优于同样使用标签信息的Synthesees方法,这表明利用预训练人脸识别模型进行知识蒸馏可增强模型的泛化能力。
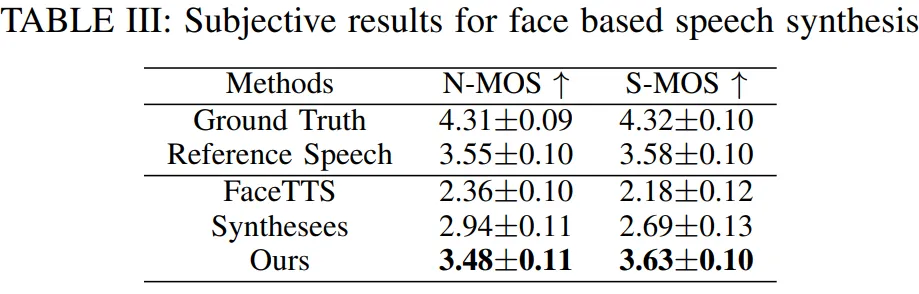
上表展示了合成语音的自然度(N-MOS)和相似度(S-MOS)结果。我们的方法获得了最高的自然度得分,这证明了结合高质量训练数据的三阶段训练策略能够生成更自然的语音。FaceTTS的N-MOS表明,使用小规模、低质量的完全匹配数据集进行端到端合成难以生成预期语音。此外,我们的方法在说话人相似度方面也有所提升,验证了从面部图像中捕捉与语音相关的风格属性并合成更合适语音的有效性。
基于文本描述的语音合成结果
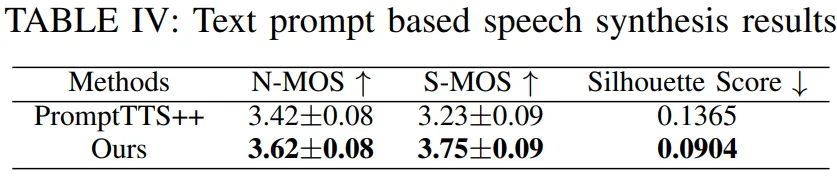
上表展示了基于文本描述的语音合成实验结果。与基线方法相比,我们的方法在语音自然度和与文本描述的匹配度上均有所提升。结果表明,我们的方法在自然语言建模和捕捉风格信息方面具有鲁棒能力。此外,我们的方法在轮廓系数上具有明显优势,这表明合成的说话人分布更广,即利用面部提示和语音提示生成更多样化语音的方法是有效的。
结 论
本文引入了一种多阶段的多模态可控语音合成框架,以解决完全匹配训练数据不足带来的限制并提高合成语音的质量。我们采用监督学习和知识蒸馏来解决面部特征的不一致性并增强其泛化能力。此外,文本编码器在文本描述-面部和文本描述-语音数据的组合上进行训练,从而增加了生成语音的多样性。实验结果表明,我们的方法在基于面部和基于文本描述的语音合成中均优于单模态基线模型,证实了其在生成高质量语音方面的有效性。
