
 语音小管家
多说话人对话识别是语音处理领域中最具挑战性的问题之一,尤其准确识别重叠语音区域极具挑战。多说话人语音重叠不仅涉及语音片段的重叠,还涉及说话人表征的重叠。有效应对这些挑战对于说话人分离、语音识别以及多说话人对话系统等应用至关重要 。重叠语音检测(Overlapping Speech Detection, OSD)作为解决这些问题的关键环节,正日益受到重视。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)与理想汽车合作的论文 “Towards Robust Overlapping Speech Detection: A Speaker-Aware Progressive Approach Using WavLM” 被语音领域顶级会议 Interspeech 2025 接收。该论文提出了一种说话人感知的渐进式OSD模型,利用渐进式训练策略增强语音活动检测(VAD)与重叠检测等子任务之间的关联性,并通过说话人注意力模块在帧级别丰富说话人信息特征,以获得较好的重叠检测效果。现对该论文进行简要的解读和分享。
论文题目:Towards Robust Overlapping Speech Detection: A Two-Stage Speaker-Aware Method
作者列表:孙照凯,张丽,王晴,周盼,谢磊
合作单位:理想汽车
论文原文:https://arxiv.org/abs/2505.23207
背景动机
说话人语音重叠是对话中常见的现象,检测这些语音重叠的OSD(Overlapping Speech Detection)任务对包括语音识别与理解、人机语音交互、语音大模型数据处理管线等诸多下游任务至关重要。
多任务学习(MTL)[1] 在通过整合相关任务(如语音活动检测,VAD)来提升OSD性能方面展现了良好潜力。将VAD作为子任务有助于捕捉人类语音模式,增强OSD系统的整体鲁棒性。然而,许多现有方法将MTL视为三类分类问题,往往未能充分利用任务之间的内在关系。例如,CRNN等模型 [2]将音频帧分类为静音、单说话人和重叠三类,但这种简化可能导致精确率和召回率之间的不平衡。
除了语音重叠检测外,区分重叠区域内的说话人身份也是一个关键挑战。说话人识别作为语音分析的另一个重要组成部分,为解决重叠语音问题提供了宝贵的信息 [3]。通过提取说话人特征,说话人识别系统支持访问控制、个性化语音服务和对话分析等应用。
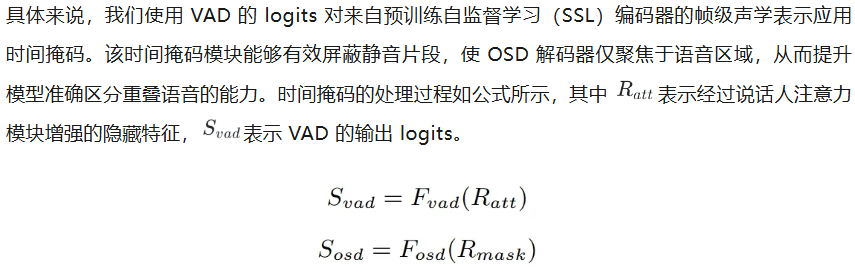
为了解决这些挑战,我们提出了一个鲁棒且渐进的重叠语音检测(OSD)框架,利用WavLM并融合说话人表示以增强重叠检测能力。我们的方法引入了渐进学习策略,更好地利用任务之间的关联,实现对语音活动检测(VAD)和OSD组件的逐步优化。具体而言,我们使用VAD的logits对编码器的隐藏状态进行掩码处理,并将掩码后的表示输入到OSD解码器中。此外,受到研究指出单说话人和重叠段特征分布相似性的启发 [4],我们设计了一个帧级说话人注意力模块。该模块提取说话人表示,并将其与预训练SSL模型的音频特征融合,丰富OSD解码器的输入。
提出的方案
如图1所示,所提出的说话人感知渐进式OSD模型由四个关键组件组成:预训练的自监督学习(SSL)编码器、说话人注意力模块、时间掩码模块以及解码器。在推理过程中,输入音频与说话人信息融合,以增强SSL特征表示。这些融合后的表示随后通过VAD(语音活动检测)输出的logits进行掩码处理,再输入到OSD解码器中进行预测。
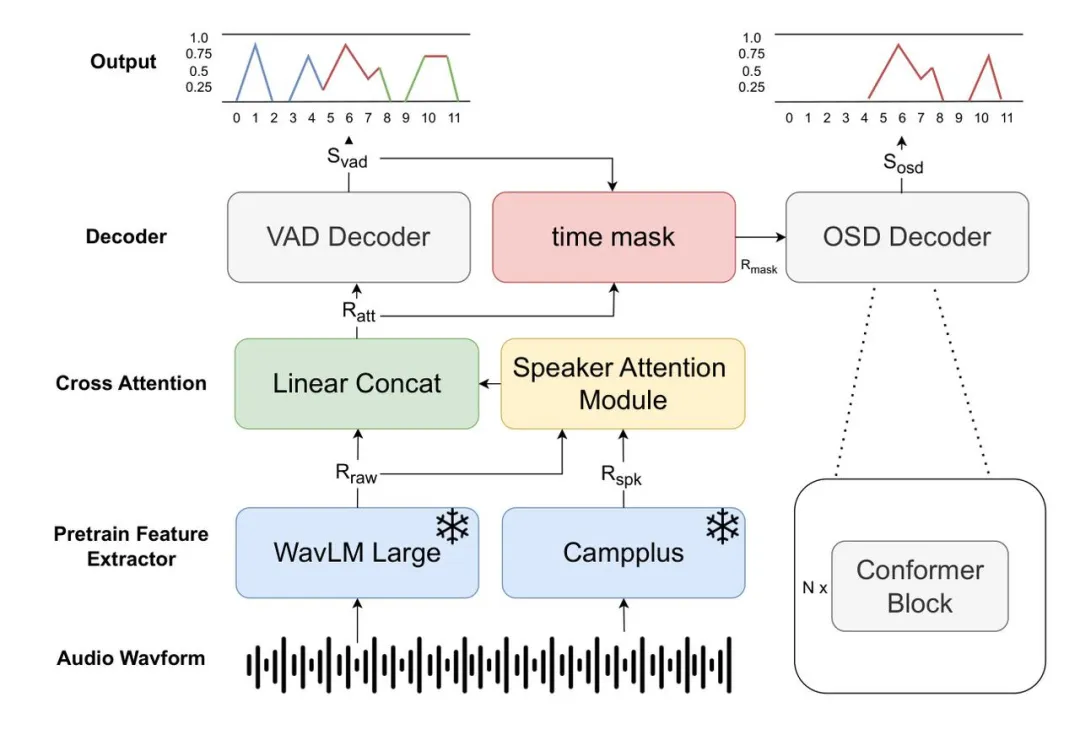
图1 系统架构
渐进式模型架构
我们提出的渐进式建模方法如图 1 所示。以往的研究通常在最后一步同时生成 VAD 和 OSD 的预测结果,并对两个任务分别应用分类损失函数。然而,这些方法并未明确建模两个任务之间的关系。我们的目标是通过显式建模 VAD 与 OSD 任务之间的关系,从而进一步提升 OSD 的性能。
说话人注意力模块
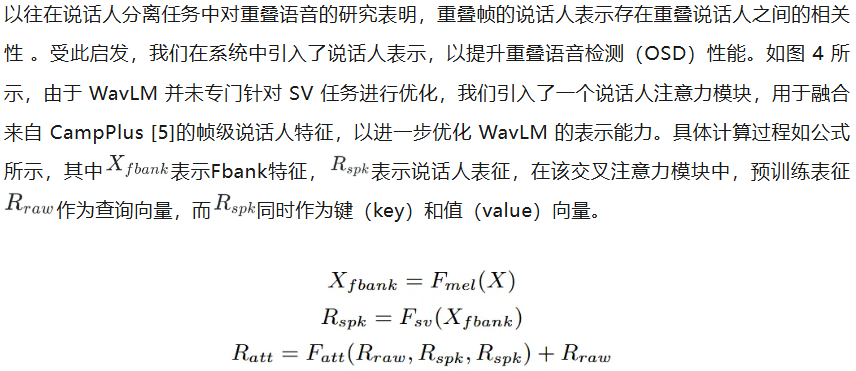
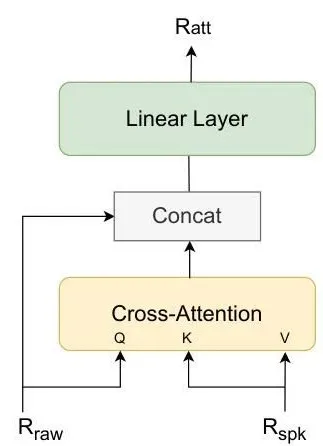
图2 说话人注意力模块
实 验
实验数据
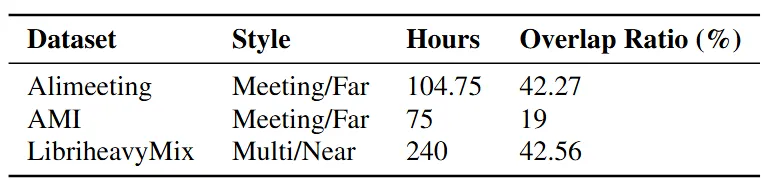
一个理想的重叠语音检测系统应当具备对语言、说话风格以及说话人与麦克风之间距离变化的强鲁棒性。为了提升模型的泛化能力,我们从多个开源资源中汇集了一个多样化的多说话人对话数据集。在训练过程中,模型首先在 LibriHeavyMix[6] 数据集上进行五轮预训练 ,随后使用真实场景数据进行微调。各数据集的详细信息见下表。
表1训练数据
此外,我们对训练数据进行了人工筛选,使每个对话 session 中静音片段、单说话人片段和重叠语音片段的比例保持为 1:1:1,以保证分布的平衡。为了应对标注的不确定性,我们在 VAD 和 OSD 的边界区域采用了一种模糊标注策略。具体而言,在重叠语音标签的边界附近,我们在 10 帧的范围内将标签值从 1 平滑衰减至 0,从而实现更平滑的过渡,并提升模型的鲁棒性。
训练配置
训练语音被划分为每段 5 秒的区间。为了保证与预训练前端的兼容性,音频帧长设置为 25 毫秒,帧移为 20 毫秒。我们采用 Adam 优化器,初始学习率设为 1e-4,用于训练所有 OSD 模型,权重衰减设置为1e-4,并使用余弦学习率调度器动态调整学习率,从而实现更平滑的优化过程。我们还研究了训练过程中混响增强的影响。但实验结果表明,添加混响并未带来显著的性能提升,因此未将其纳入最终的训练流程。
实验结果
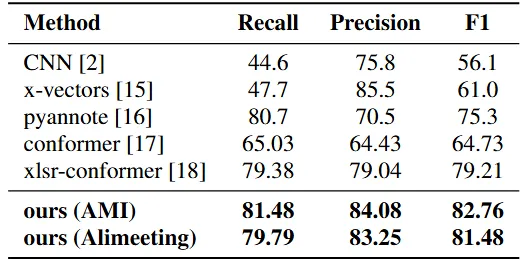
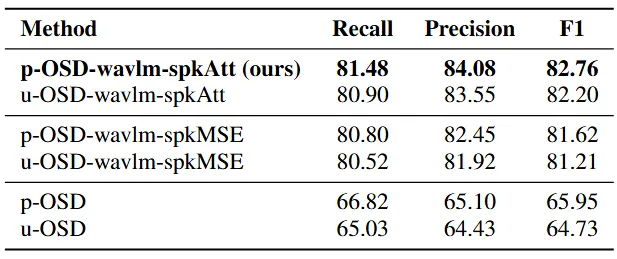
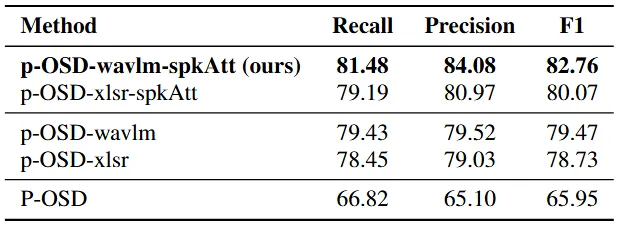
为了全面评估我们方法的有效性,我们进行了四项主要实验。表 2 展示了我们的系统与现有最具竞争力方法的对比。表 3探讨了说话人注意力模块的影响。表 4 评估了渐进式学习策略在不同系统配置下带来的改进。最后,表 5 通过替换不同的预训练自监督学习编码器,研究了其对特征提取效果的影响
第一项实验结果如表 2 所示,我们的系统取得了82.76%的F1分数,优于所有此前报道的方法。值得注意的是,相较于之前的最先进系统 XLSR-Conformer,性能实现了4.4%的相对提升。此外,召回率和准确率均有显著提高,表明渐进式学习方法有效提升了整体系统性能。
表2 效果对比
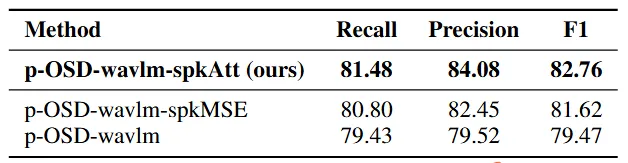
第二项实验考察了将说话人信息融入OSD系统的不同方法。为了进行比较分析,我们还实现了先前提出的一种方法,该方法通过均方误差(MSE)损失使OSD表示与说话人特征对齐。如表 3 所示,带有说话人注意力模块的渐进式OSD系统在AMI测试集上取得了82.76%的F1分数,而使用MSE方法的系统则为81.62%。结果表明,相较于基于MSE的对齐,注意力机制能够更有效地利用说话人信息,从而提升系统性能。
表3 说话人信息消融
第三项实验旨在展示我们两阶段方法在提高召回率和降低误报率方面的有效性。为了保证公平比较,我们将以往OSD系统中使用的多任务建模策略改为渐进式方法,同时保持相同的建模框架。如表 4 所示,融合了WavLM和说话人注意力模块的渐进式OSD系统取得了最高的F1分数,表现出0.6%的相对提升。统一方法与渐进式方法的对比结果表明,渐进式模型在召回率和误报率上均优于统一模型,进一步验证了所提出渐进学习策略的有效性。
表4 渐进式架构消融
我们提供了额外的实验探究SSL前端对系统效果的影响。如表5所示,融合了WavLM和说话人注意力模块的渐进式OSD系统取得了最高的F1分数,无论是否应用说话人注意力,WavLM前端系统较xlsr系统性能均有提升。
表5 预训练前端消融
参考文献
[1]Y. Zhang and Q. Yang, “A survey on multi-task learning,” IEEE transactions on knowledge and data engineering, vol. 34, no. 12,pp. 5586–5609, 2021.
[2]S. Zheng, S. Zhang, W. Huang, Q. Chen, H. Suo, M. Lei, J. Feng,and Z. Yan, “Beamtransformer: Microphone array-based overlap-ping speech detection,” arXiv preprint arXiv:2109.04049, 2021.
[3]Y. Tu, W. Lin, and M.-W. Mak, “A survey on text-dependent and text-independent speaker verification,” IEEE Access, vol. 10, pp.99 038–99 049, 2022
[4]T. Cord-Landwehr, C. Boeddeker, C. Zoril˘a, R. Doddipatla, and R. Haeb-Umbach, “Frame-wise and overlap-robust speaker embeddings for meeting diarization,” in ICASSP 2023-2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2023, pp. 1–5.
[5]H. Wang, S. Zheng, Y. Chen, L. Cheng, and Q. Chen, “Cam++: A fast and efficient network for speaker verification using context-aware masking,” arXiv preprint arXiv:2303.00332, 2023.
[6]Z. Jin, Y. Yang, M. Shi, W. Kang, X. Yang, Z. Yao,F. Kuang, L. Guo, L. Meng, L. Lin et al., “Libriheavymix: a 20,000-hour dataset for single-channel reverberant multi-talker speech separation, asr and speaker diarization,” arXiv preprint arXiv:2409.00819, 2024.
