
 语音小管家
当前,尽管语音基础模型 (Speech Language Model (SLM)) 在模拟人类对话方面取得了显著进展,但如何让机器真正理解并参与到自然、流畅、实时的口语互动中,尤其是在两人对话场景下,仍是一个巨大挑战。现有方法往往难以充分利用双声道语音数据中蕴含的丰富交互动态。
针对这一痛点,本文提出的“下一个Token对预测”(Next-Token-Pair Prediction, NTPP)范式,开创性地探索了利用解码器纯架构 (decoder-only) 进行端到端双声道语音对话学习的策略,旨在赋予 SLM 更强的对话能力、真实感和更低的延 迟 。
论文标题:NTPP: Generative Speech Language Modeling for Dual-Channel Spoken Dialogue via Next-Token-Pair Prediction
(NTPP:通过下一 Token 对预测实现双声道口语对话的生成式语音语言建模)
项目主页:https://audio-3059.pages.dev
论文地址:https://arxiv.org/abs/2506.00975
Github:
通讯作者及邮箱:
Ziqiao Meng zq-meng@nus.edu.sg
Peilin Zhao masonzhao@tencent.com
NTPP:专为真实对话设计
传统的 SLM 通常处理单声道音频或未能充分挖掘双声道数据的潜力。双声道录音能够独立捕捉对话双方的语音,从而明确地展现重叠、停顿、打断和附和等真实的对话动态。NTPP 的核心思想正是充分利用这些信息。
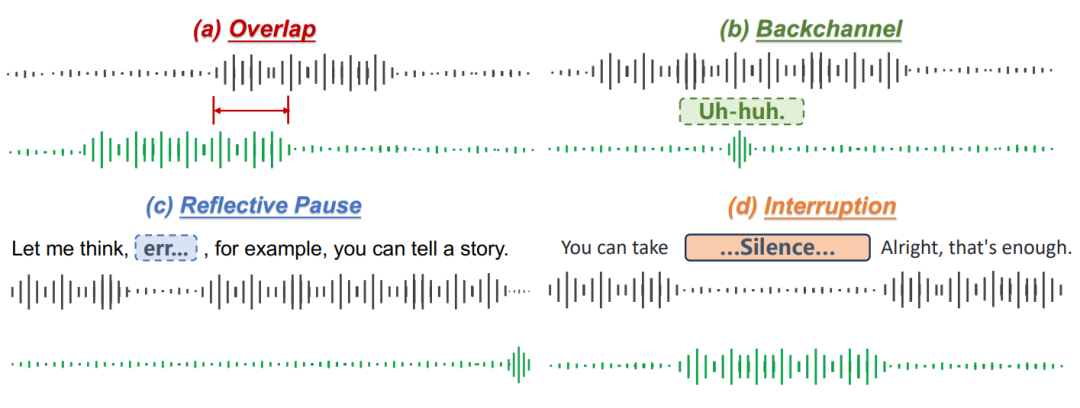
NTPP 的关键创新与优势:
下一Token对预测 (Next-Token-Pair Prediction):不同于以往模型预测单个音符,NTPP 学习预测下一时刻 两个声道同时 的语音Token对 (sta,stb) 。这使得模型能直接对双声道语音序列的联合概率分布 p(Sa,Sb) 进行建模,而非仅仅是条件分布。
Decoder-only架构:首次在Decoder-only架构上实现双声道语音对话学习,提升了学习和参数效率,并简化了模型结构。
说话人无关性 (Speaker Independence):NTPP 学习到的分布对于说话人顺序具有排列不变性,这意味着模型性能不受说话人声道分配的影响,更具鲁棒性。
无需语音活动检测 (VAD):模型以完全数据驱动的方式学习多样的对话轮转行为,无需额外的 VAD 模块。
单一 KVCache:提高了内存和推理效率,尤其在长对话中优势显著。
具体而言,我们对比了三类方法,以突出NTPP相较于现有开源方案的独特之处:
第一类方法,是常见的 turn-based dialogue modeling ,通常将一个声道作为前缀条件(prefix),另一个声道作为生成目标,这是一种典型的多模态生成范式。然而,这类方法天然只能建模回合式对话,不适合流式语音交互,生成过程不够自然,难以捕捉真实对话中的交叉与重叠语音现象。
第二类方法,以近期的 Moshi 和 LSLM 为代表,开始尝试对双声道语音进行直接建模。这类方法依然遵循“下一个 token 预测”(Next-Token Prediction, NTP)这一主流预训练范式,通常将一个声道编码为 latent 表征,作为条件输入用于预测另一个声道。这类方法的局限在于它们仅建模条件分布 p(Sb∣Sa),难以捕捉说话人之间的对等交互关系,从而无法实现真正的全双工对话,也不具备 speaker-independence 的性质。此外,由于依赖 encoder 结构,该类模型参数量大,计算复 杂 度也较高。
第三类方法,即我们提出的 NTPP(Next-Token-Pair Prediction)预训练范式,该方法直接学习双声道语音序列的联合分布 p(Sa,Sb),从而自然实现说话人无关(speaker-independent)建模。与早期的 dGSLM 方法相比,后者采用 encoder-decoder 结构,参数效率较低;而我们的方法则在保证建模能力的同时,实现了纯 decoder-only 架构,显著提升了训练和推理效率。
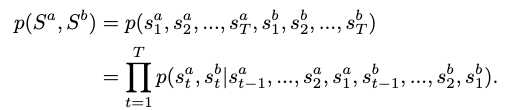
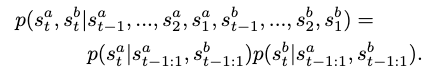
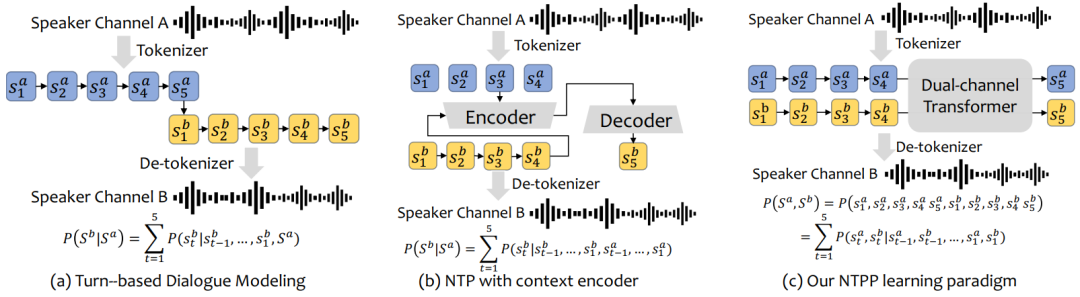
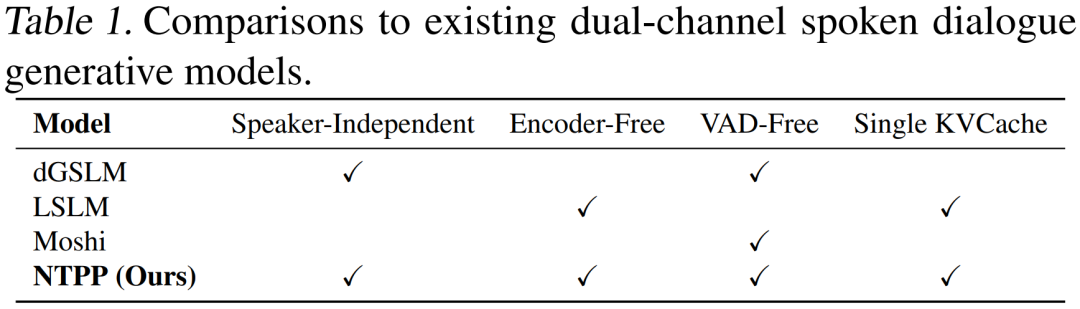
表1. 与现有双声道口语对话生成模型的比较
NTPP 如何工作?
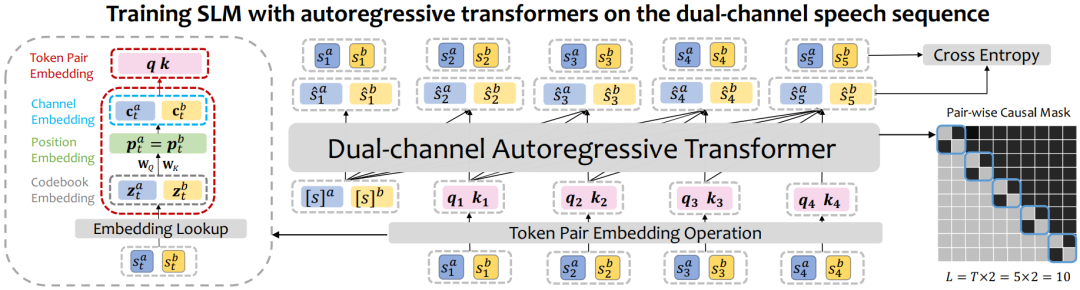
NTPP 通过对标准的 Transformer Decoder架构进行巧妙调整,实现了对双声道语音序列的有效处理,主要包含以下三个设计:
Token对嵌入 (Token Pair Embedding):为每个音符对 (sta,stb) 设计了专门的嵌入操作,融合了码本嵌入(codebook embedding)、共享的位置嵌入 (shared positional embeding) 以及区分说话人的声道嵌入(speaker identity embedding)。
成对因果注意力掩码机制 (Pair-wise Causal Masking):修改了注意力机制中的因果掩码,确保在预测当前token对时,每个声道的Token仅能关注到之前时刻的Token,并且同一时刻的两个声道token之间不相互泄露信息。
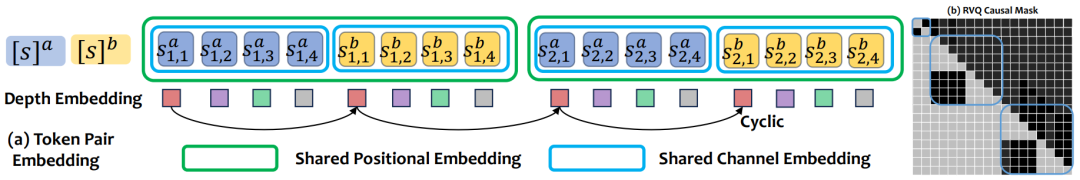
针对 RVQ 的扩展:对于更高级的 RVQ 编码器,NTPP 进一步引入了循环深度嵌入 (cyclic depth embedding) 和相应的 RVQ 因果掩码机制,以处理其二维的码本结构。其中,cyclic depth embedding可以有效地告诉模型第i个token处于第几个RVQ depth。
通过这些设计,NTPP 能够有效地从双声道数据中学习对话的复杂动态。
实验效果显著
研究团队在标准的Fisher 数据集[1]上对 NTPP 进行了全面评估,并与多种基线模型进行了比较。
对话能力提升:NTPP 在轮转预测、响应连贯性和自然度方面均显著优于现有方法 [2]。例如,在模拟对话中的轮转事件(如停顿、间隙、重叠)分布上,NTPP 生成的对话更接近真实人类对话。
中断与反馈处理:在处理中断和需要适时插入反馈(如“嗯哼”)的场景中,NTPP 的行为更接近人类的判断。
人类评估领先:在由人类评估员进行的自然度(Naturalness) 和意义性 (Meaningfulness) 评分中,NTPP 表现出色,尤其在 Fisher 数据集上取得了接近真实电话录音的评分。
推理延迟大幅降低:相较于需要双KVCache 的模型 (如 Moshi),NTPP 的单 KVCache 设计使其在多轮对话中的推理延 迟 显著降低,且延 迟 增长更平缓,保证了实时交互体验。
优越的说话人无关性:在交换输入声道顺序的测试中,NTPP 的性能保持高度 稳 定, 远 超其他依赖特定说话人顺序的模型。
消融研究验证设计:实验证明了两阶段训练(先在单声道大规模数据上预训练,再在双声道数据上用NTPP 微调)以及采用 RVQ 编码器的有效性。
可视化训练过程也显示,NTPP 能够有效降低模型的困惑度 (Perplexity)。
我们采用两阶段的训练策略:第一阶段进行单声道音频建模,第二阶段进行双声道对话建模。在第一阶段中,模型通过大规模单声道音频学习基本的音频分布,从而获得一个具备音频理解能力的基础语音语言模型(Speech Language Model, SLM);在第二阶段,模型进一步在双声道语音数据上学习对话分布,最终形成具备双说话人建模能力的 NTPP 对话模型。
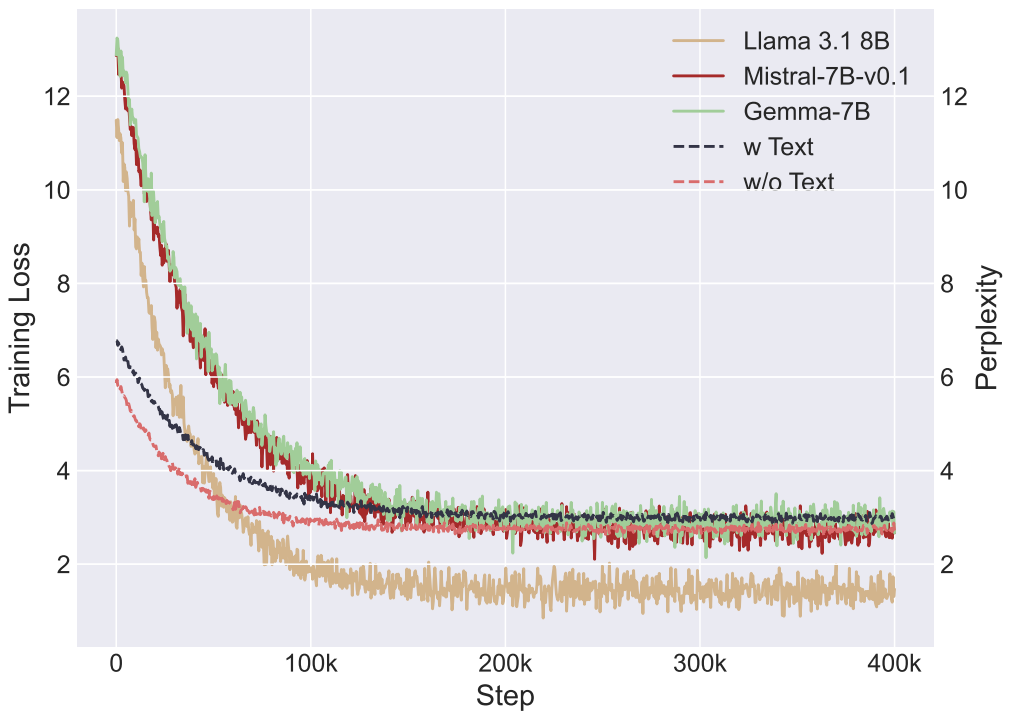
在单声道音频建模中,我们考察了不同基础语言模型的影响。实验结果表明,在所选的几个基础模型中,LLaMA 3.1-8B 的表现最为优异。这一结果印证了我们的假设:更强大的文本预训练模型在迁移到音频建模任务时具有更优的表现能力,即“更强的文本基础模型可以更好地学习音频”。
NTPP在对话turn-taking events分布学习benchmark上展现出了超越baseline的能力。
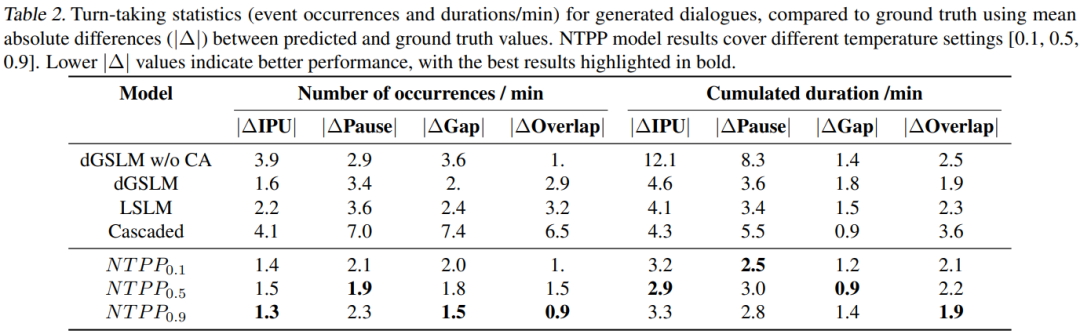
表2. 生成对话的轮转统计数据
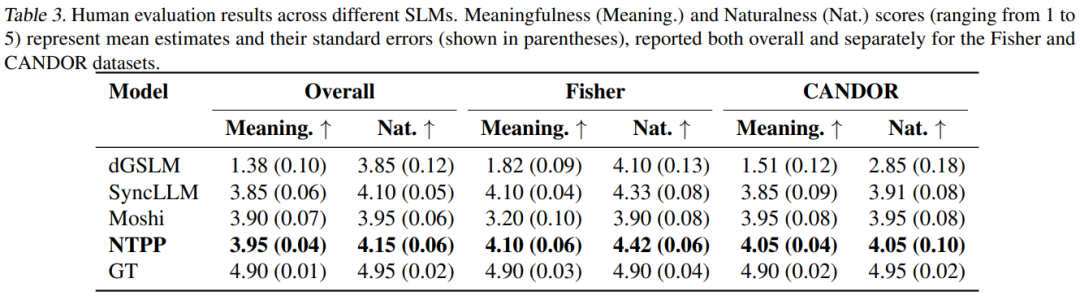
表3. 不同SLM的人类评估结果
NTPP在人类评估上表现超越baseline模型。NTPP 在 speaker independence (说话人无关性)评估中表现出色。相比之下,Moshi 无法保证这一特性 —— 在测试中,当交换输入语音中两位说话者的顺序时,Moshi 的生成效果明显下降,性能波动较大,说明其对说话人顺序较为敏感。
此外,在“打断”与“接话”两个关键场景下,NTPP 的表现更接近人类判断。图中展示了模型与人类参考答案的一致性,结果表明 NTPP 与 Human Reference 的对齐程度更高,体现了其更强的对话理解与响应能力。
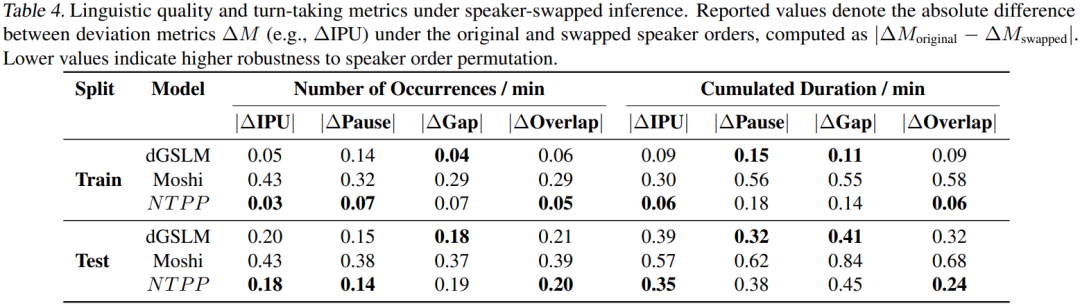
表4. 说话人顺序交换下的语言质量和轮转指标
随着对话轮次的增加, Moshi 的推理延 迟 显著上升;相比之下, NTPP 在多轮对话中的推理延迟增长幅度较小,表现出更好的延 迟稳 定性。这一性能优势可能得益于 NTPP 所采用的 decoder-only 架构 ,其利用单一的 KV Cache 实现了更高效的上下文存储与读取,从而有效降低了内存访问开销与推理延迟 。
消融实验显示一阶段和二阶段的训练都是必要的;RVQ的效果学习效果强于VQ,验证了拓展RVQ方案的必要性。
为什么NTPP 能起作用?
NTPP 的成功源于其直接从双声道数据中学习对话的内在结构和动态。
捕捉交互本质:双声道数据天然包含了对话中的时间对齐信息以及如语音重叠、轮转等关键交互特征。NTPP 通过预测音符对,直接利用了这种时间对齐特性。
联合分布建模:对两个说话人语音序列的联合分布进行建模,使模型能够理解和生成双方的相互依赖关系,而不是简单地将一个说话人作为另一个的条件。
端到端学习:避免了传统级联系统(ASR-LLM-TTS)中各模块错误累积的问题,也无需复 杂 的对齐或融合策略。
局限性与未来展望
尽管NTPP 取得了显著成果,但其主要局限在于大规模、高质量双声道语音数据的稀缺性。与易于获取的单声道数据不同,双声道数据的收集或处理更具挑战性。
未来,研究团队计划探索利用合成数据策略来生成高质量的双声道语音数据,以进一步推动该领域的发展。
总结:NTPP 通过创新的下一音符对预测范式和高效的解码器纯架构,显著提升了语音语言模型在双声道对话场景下的自然度、连贯性和实时性,为构建更高级、更具交互性的人工智能语音系统铺平了道路。
参考文献
[1] Cieri C, Miller D, Walker K. The Fisher corpus: A resource for the next generations of speech-to-text[C]//LREC. 2004, 4: 69-71.
[2] Défossez A, Mazaré L, Orsini M, et al. Moshi: a speech-text foundation model for real-time dialogue[J]. arXiv preprint arXiv:2410.00037, 2024.
