
 语音小管家
内蒙古大学S2LAB刘瑞教授联合美国约翰霍普金斯大学、美国卡耐基梅隆大学、香港中文大学(深圳)等单位推出了首个面向情感一致性建模的多情感语音编辑数据集——ECD-TSE。该数据集大约90小时,涉及到5种情感,涵盖11个主题内容,总计84,000条语句。该数据集已在GitHub等平台开源。在Hugging Face平台开放了数据下载页面。🚀🚀🚀
📌Hugging Face数据集页面:https://huggingface.co/datasets/Gaphy/ECD-TSE
📌GitHub:https://github.com/AI-S2-Lab/EmoCorrector
📌论文地址:https://arxiv.org/abs/2505.20341
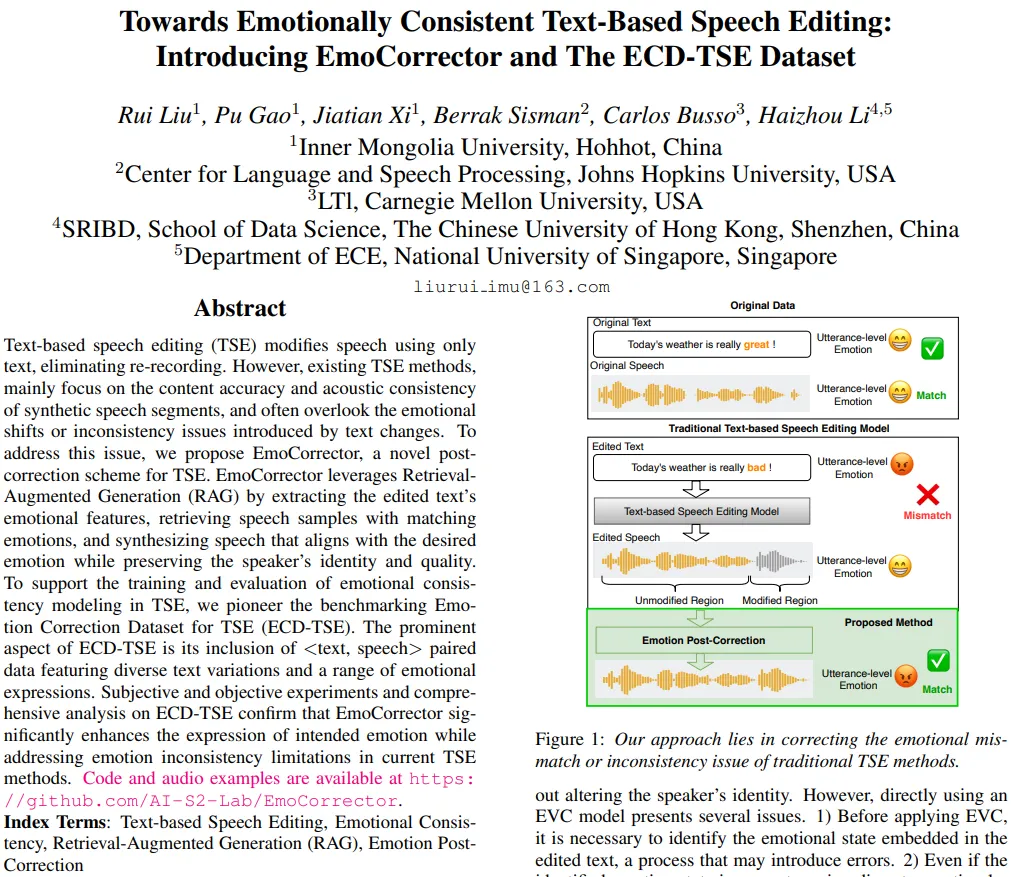
ECD-TSE数据集简介:
🔎超90小时语音数据,由3个当下最先进的TTS模型生成。
🌏支持英语(En)
📣丰富的语音场景:涵盖超过10种主题和内容,12个说话人
🏆首个面向情感一致性的语音编辑数据集
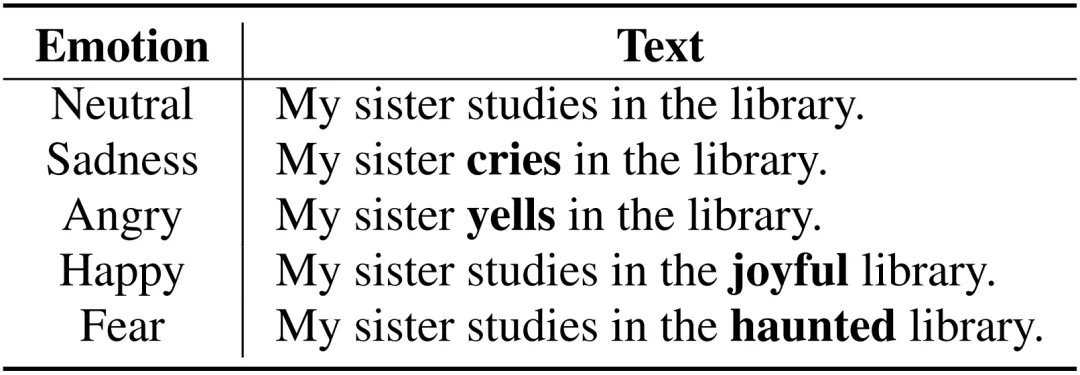
文本数据示例:不同文本之间只有一两个词的差异,但它们的情感表达却完全不同
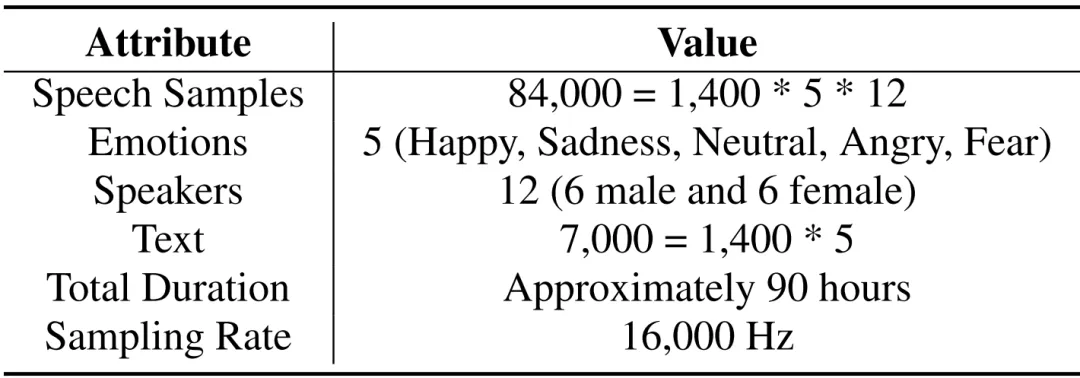
ECD-TSE的统计信息
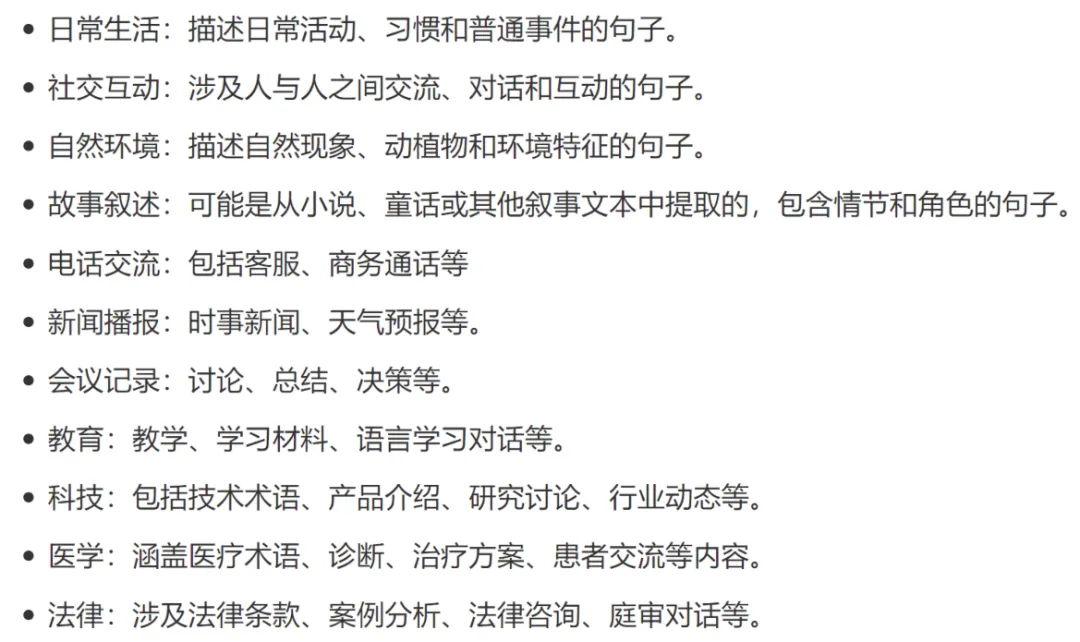
语音内容包含11个主题
通过ECD-TSE数据集,研究者和开发者可以进行情感校正模型的训练和开发,为推动情感校正任务的发展提供强有力的支持!期待大家在使用ECD-TSE数据集时能够发掘更多惊喜,欢迎分享您的研究成果与经验
🔔 请注意:该数据集仅可用于非商业科研目的。想把该数据集用于商业用途,请联系S2LAB实验室。
联系方式:liurui_imu @163.com、gaopukb@163.com
内蒙古大学语音理解与生成实验室 S2LAB:https://ttslr.github.io/
