
 语音小管家
在语音合成(Text-to-Speech, TTS)领域,自回归(Autoregressive, AR)模型以其在韵律自然性和风格迁移上的优势备受青睐,但长期以来受限于语音时长难以精确控制的难题。与之相对,非自回归(Non-Autoregressive, NAR)模型虽能控制时长,却常在语音的自然度上有所妥协。如何在保留AR模型优势的同时,突破其核心限制,成为该领域的前沿挑战。
近期,一种对传统AR范式的重大革新引起了广泛关注。它通过引入创新的“时间编码”机制,首次让AR模型具备了媲美NAR模型的精确时长控制能力,打破了两者之间的固有壁垒。
本期介绍的IndexTTS2,正是引领这一AR范式革新浪潮的代表作。它不仅通过新颖的架构设计解决了时长控制问题,更引入了音色与情感的解耦建模,实现了前所未有的情感表现力和灵活控制。接下来,我们将深入解析IndexTTS2的核心技术及其在语音合成领域的突破性贡献。
标题:IndexTTS2: A Breakthrough in Emotionally Expressive and Duration-Controlled Auto-Regressive Zero-Shot Text-to-Speech
作者:Bilibili Inc. IndexSpeech Team
论文地址:
Demo体验:https://index-tts.github.io/index-tts2.github.io/
语音合成技术,特别是零样本(Zero-Shot)语音合成,在个性化内容创作和多媒体应用中展现出巨大潜力。然而,尽管早期版本的IndexTTS及其他AR模型在多场景应用中表现出色,但在两个关键维度上仍存在瓶颈:情感表达的细腻度和语音时长的精准性。在实际应用中,用户往往需要对生成语音的语速、节奏进行精细调整,而传统AR模型在这一方面能力受限。同时,要获得兼具目标音色与准确情感的参考音频极为困难,限制了模型在复杂场景下的表现力。为了解决这些问题,并推动零样本TTS技术走向真正的实用化,IndexTTS2应运而生。
为攻克上述挑战,研究者对模型架构进行了深度优化,提出了一个由Text-to-Semantic (T2S)、Semantic-to-Mel (S2M)和声码器构成的框架。其核心创新点如下:
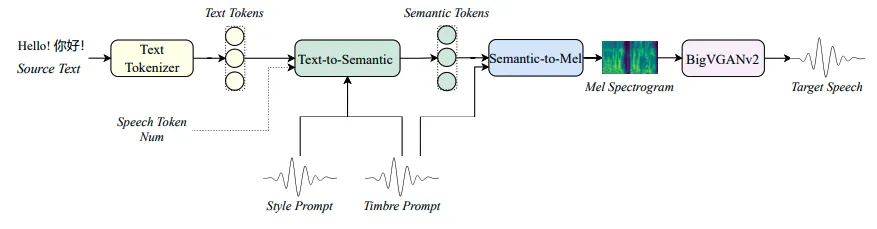
图1:IndexTTS2整体框架
1、基于AR架构的时长控制
研究者首创了一种通用于AR模型的”时间编码“机制。该机制通过在训练序列中引入一个调节输出长度的特殊嵌入向量,使得模型能够在生成时精确控制Token数量,从而实现对语音时长的任意调整。这一设计在保留AR模型韵律优势的同时,赋予了其NAR模型的关键能力。
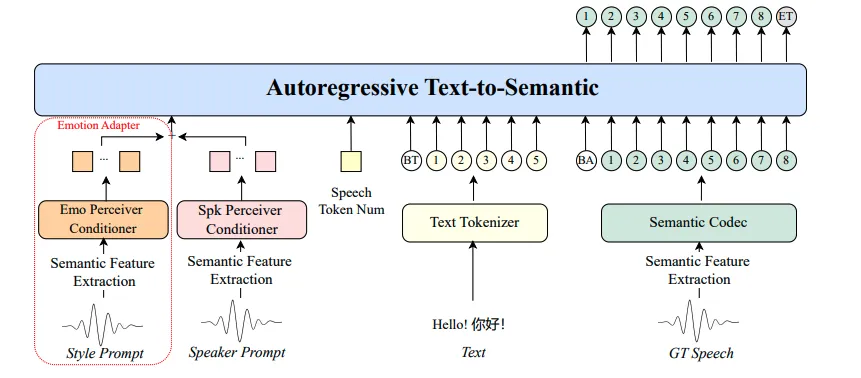
图2:自回归Text-to-Semantic模块,集成了时长与情感控制
2、音色与情感解耦
IndexTTS2对情感表达和说话人身份进行了有效解耦。模型不仅支持从单一参考音频中复刻音色与情感,还支持分别指定独立的音色参考和情感参考。这意味着用户可以用一个人的音色,说出另一个人的情感,极大地提升了控制的灵活性。
3、多模态情感控制
为了降低使用门槛,模型集成了两种情感控制方式。除了通过音频参考进行情感迁移,还引入了基于自然语言描述的情感软指令机制。通过微调大型语言模型(LLM),用户可以使用文本(如自然语言描述、场景描述)来精确引导生成语音的情绪色彩。
4、高表现力下的稳定性增强
为了提升在高强度情感(如哭腔、怒吼)下的语音清晰度,模型引入了GPT式潜在表征,并采用基于流匹配(Flow Matching)的S2M模块,显著增强了语音生成的鲁棒性和梅尔频谱图的重建质量。
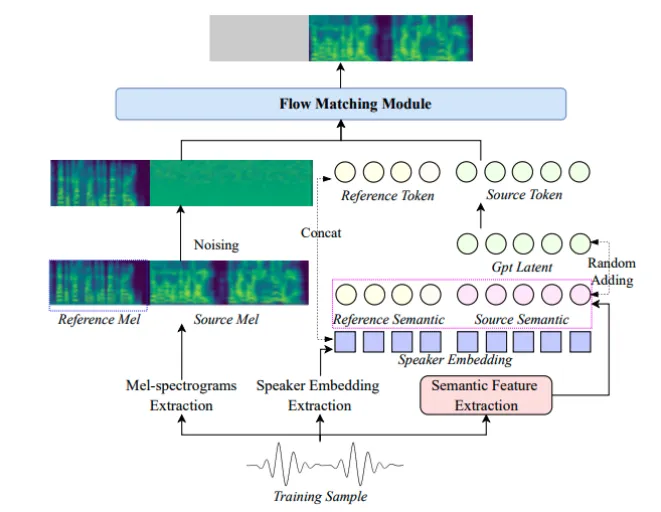
图3 :基于Flow Matching的Semantic-to-Mel
1、时长控制的准确性
IndexTTS2在时长控制方面展现了极高的精确度。在对原始语音时长进行0.75倍至1.25倍的变速测试中,生成语音的Token数量误差率几乎不超过0.03%,在多数情况下低于0.02%,证明其时长控制能力精准可靠。
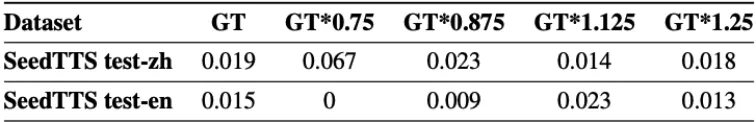
Table 1:不同设置下对持续时长控制的token数错误率
2、情感表现力
在情感表现力测试中,IndexTTS2显著优于其他SOTA模型。其情感相似度(ES)高达0.887,情感MOS(EMOS)评分达到4.22,合成的语音情绪饱满、渲染自然,同时保持了极低的词错误率(WER, 1.883%),实现了表现力与清晰度的完美结合。
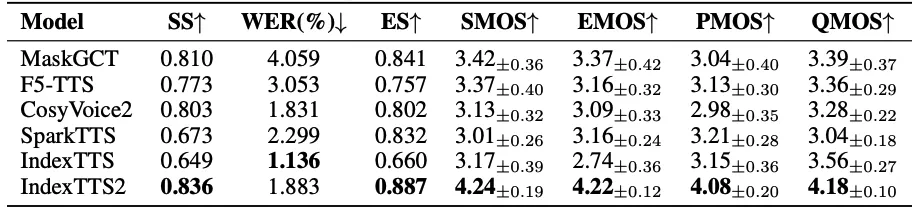
Table 2:在情感测试集上的结果
3、零样本语音合成能力
在多个公开基准测试集(如LibriSpeech, SeedTTS)上,IndexTTS2在客观指标(词错误率WER、说话人相似度SS)和主观MOS评分(音色、韵律、质量)上均达到或超越了当前最先进的开源模型,包括MaskGCT, F5-TTS, CosyVoice2等,展现了其强大的基础合成能力和鲁棒性。
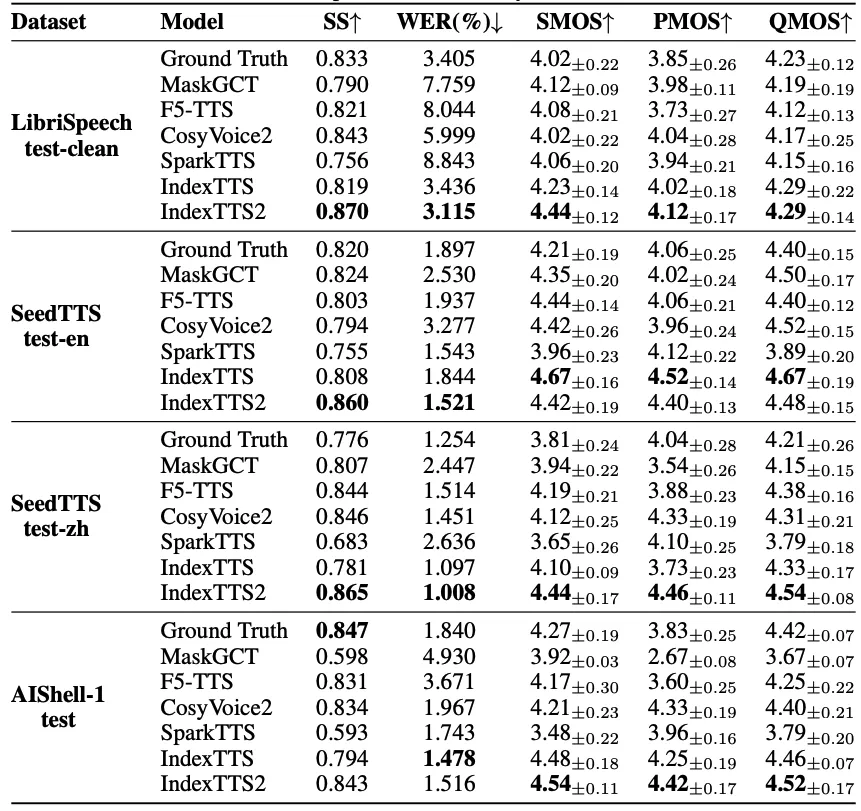
Table 3:在公开测试集上的结果
4、消融实验验证
实验证明,模型中的GPT潜在特征对于保证语音清晰度和发音准确性至关重要;而基于流匹配的S2M模块相比于传统的离散声学Token方案,极大地提升了合成语音的保真度和自然度。
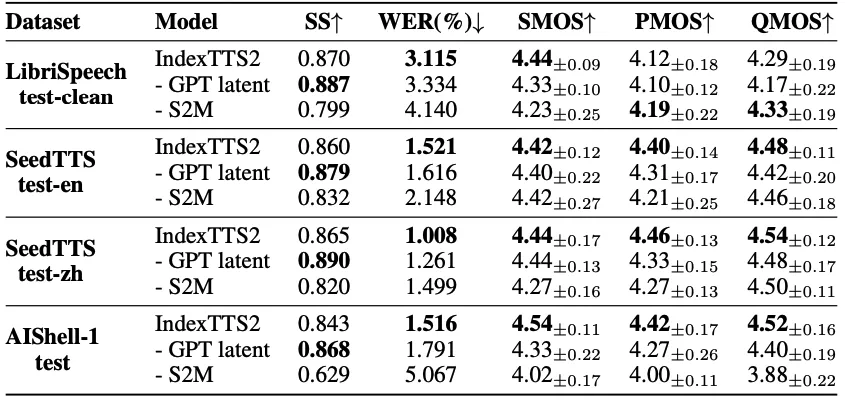
Table 4:消融实验结果
1、理论意义
IndexTTS2提出的“时间编码”机制为自回归(AR)语音合成范式提供了一个全新的解题思路,成功攻克了AR模型无法精确控制时长的传统难题。其音色与情感的解耦建模也为实现高表现力、高可控性的语音生成开辟了新路径。
2、现实意义
IndexTTS2卓越的时长与情感控制能力,使其在现实应用中具有极高的价值。该技术广泛适用于AI配音、视频翻译、有声读物、动态漫画、语音对话等多种场景。同时,模型代码与权重的全面开源,将极大地推动语音合成技术的开放创新与行业应用落地。
3、未来启示
该研究为未来语音合成技术的发展指明了重要方向:如何在AR框架下实现对情感、语调等更复杂语音特征的细粒度控制,并持续优化模型性能,为更广泛的交互式应用提供支持。
