
 语音小管家
近日,阿里通义实验室开源了旗下首个音频生成模型ThinkSound,该模型首次将CoT(Chain-of-Thought,思维链)应用到音频生成领域,让AI可以像专业音效师一样逐步思考,捕捉视觉细节,生成与画面同步的高保真音频。
目前,ThinkSound的代码和模型已在Github、HuggingFace、魔搭社区开源,开发者可免费下载和体验。
https://huggingface.co/spaces/FunAudioLLM/ThinkSound https://www.modelscope.cn/studios/iic/ThinkSound
技术原理
为视频生成真实的声音不仅仅是识别物体那么简单,它还需要对复杂的视觉动态和上下文进行深入推理—比如判断猫头鹰是在叫还是在扇动翅膀,识别树枝轻微摇曳的动作,并在一个场景中同步多个声音事件。
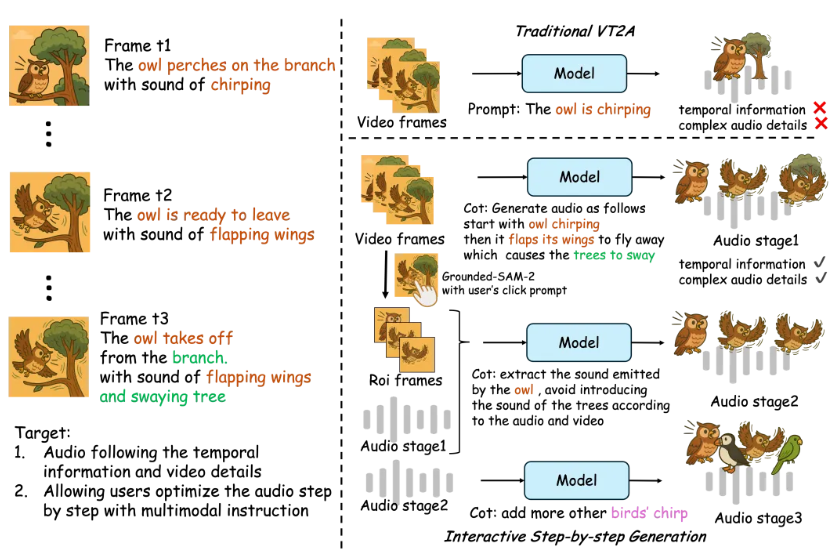
ThinkSound 借助 Chain-of-Thought(CoT)思维链推理,实现以下三步流程:基础拟音(foley)生成:创建语义一致的音景;基于对象的交互式精细调整:通过精准的用户交互提升音频细节;基于自然语言指令的定向编辑。在每个阶段,多模态大语言模型会生成与上下文对齐的 CoT 推理,进而引导一个统一的音频基础模型进行合成。
ThinkSound 架构概览:左侧为多模态大语言模型(Multimodal LLM)框架,其中经过微调的 VideoLLaMA 2 模型负责生成用于音频生成与编辑的Chain-of-Thought(CoT)推理。
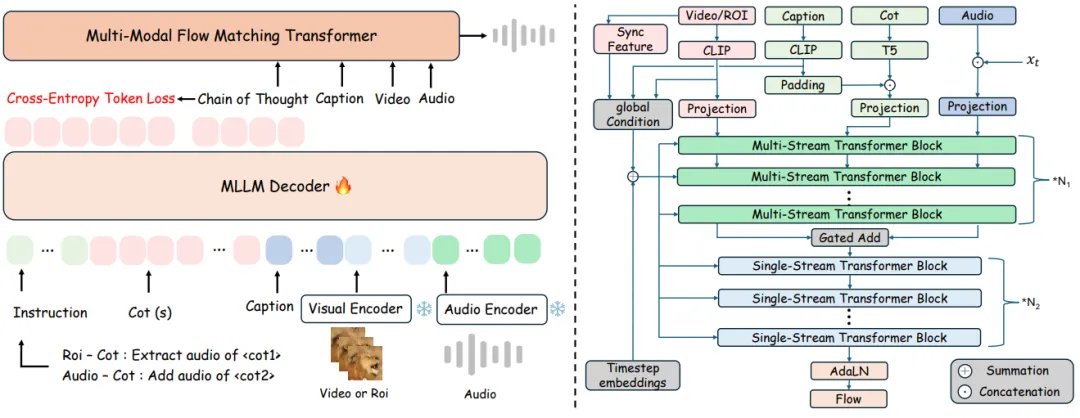
右侧为增强版的多模态 Transformer 架构,其核心为MM-DiT 主干网络,具备专门用于处理多模态输入的路径,并结合 CoT 推理进行条件控制,从而实现高保真、语境契合的音频生成。
模型测评
官方测评显示,ThinkSound在业界知名的音视频数据集VGGSound上,对比6种主流方法(Seeing&Hearing、V-AURA、FoleyCrafter、Frieren、V2A-Mapper和MMAudio),在核心指标上均实现了显著提升。
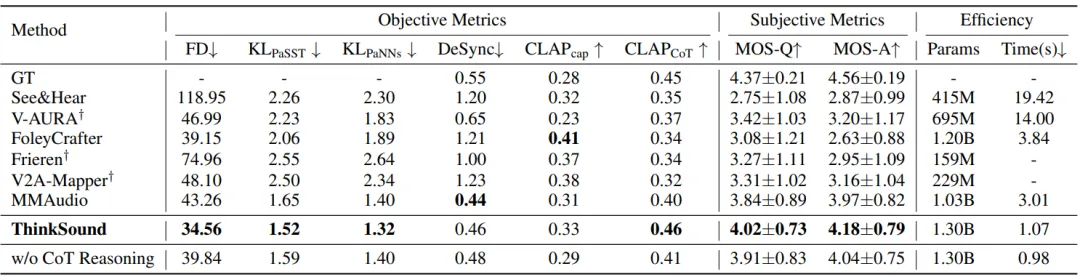
p.s. ↓ 表示越低越好,↑ 表示越高越好
目前ThinkSound一共有三种型号(1.3B、724M、533M)可选,开发者可在GitHub、HuggingFace、魔搭社区下载体验。
与此同时,团队还专门为ThinkSound构建了一个链式音频推理数据集——AudioCoT。数据集主要包括两大类,时长总计2531.8小时:
第一类:源自VGGSound (453.6小时) 和AudioSet (287.5小时),经9.1秒固定长度分段、剔除静音片段、并特别排除了含人声片段后精选而来的视频—音频对,涵盖动物鸣叫、机械运转、环境音效等真实场景。
第二类:源自AudioSet-SL (262.6小时)、AudioCaps (112.6小时)、Freesound (1286.6小时) 与BBC Sound Effects (128.9小时),利用多样化的字幕/标签描述加深模型对听觉语义的理解。
有了以上数据后,团队继续通过一套精细的处理流程,来确保模型真正实现音画同步。这个流程分为三个主要阶段:
音频-文本对齐过滤:首先检查音频和文本描述是否匹配,如果其匹配度低(CLAP分数小于0.2),就会重新生成匹配,直到达到较好的质量,并且持续低分音频样本将被剔除。
目标跟踪一致性:然后确保视频中的物体与音频对应,如果视频中的目标在整个片段中都能保持可见,才会保留下来。那些视频目标不清晰或者无法稳定跟踪的片段会被去掉。
音频组件的语义配对:最后通过GPT-4.1-nano来分析音频的标签,基于语义区分性(避免音频提取和移除任务混淆)和上下文合理性(确保配对声音在同一声学场景中共现合理)两个标准,确保音频对语义明确且实用。
总之,借助以上架构和数据集,ThinkSound能同时完成音频生成和编辑任务。
