语音小管家
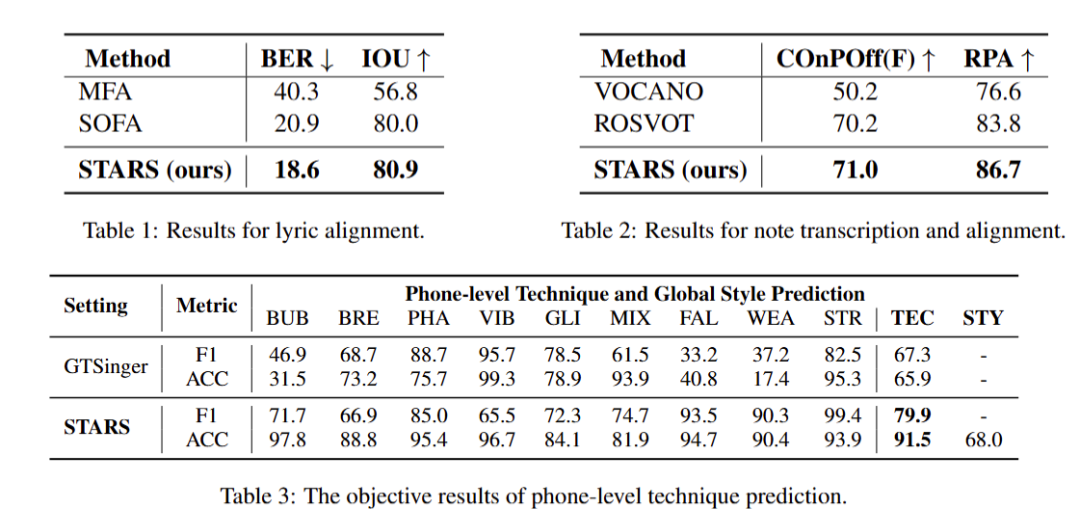
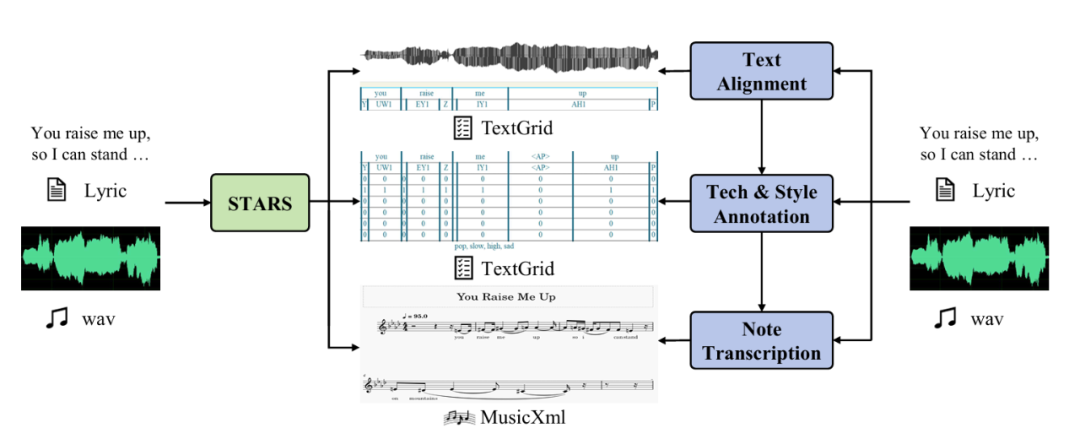
歌唱语音合成(SVS)的快速发展亟需高质量标注数据集,但传统人工标注成本高昂且效率低下。现有自动歌唱标注(ASA)方法通常仅解决标注流程中的孤立任务。为此,我们提出STARS,首个统一框架,同时解决歌唱转录、歌词对齐与精细化风格标注三大任务,提供以下多层级标注:
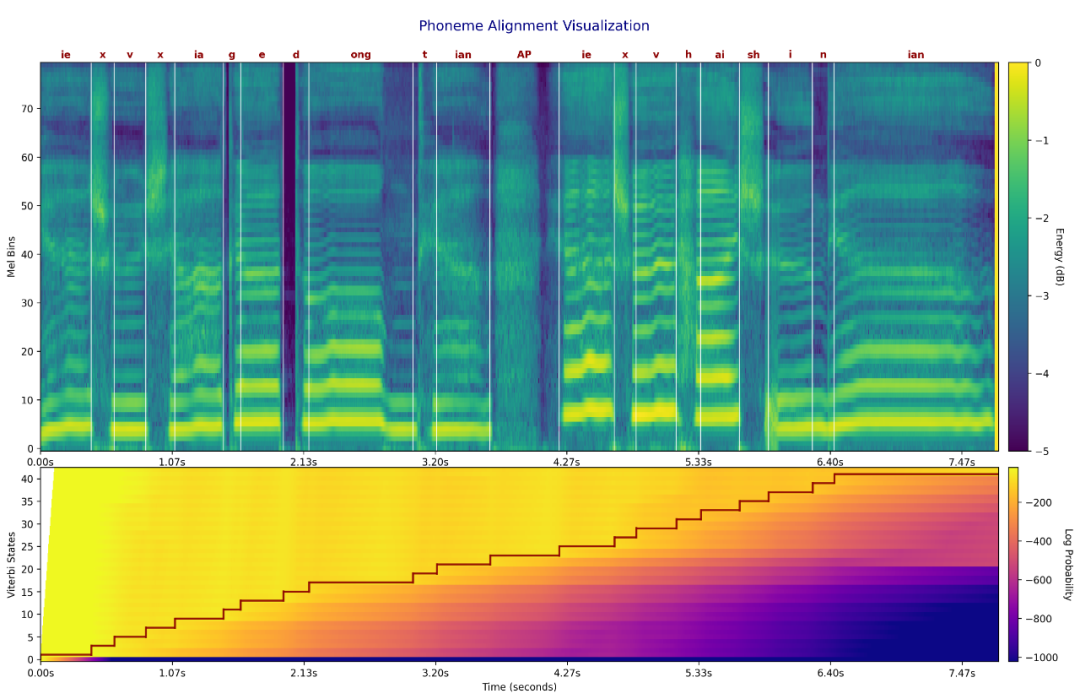
精确音素-音频对齐
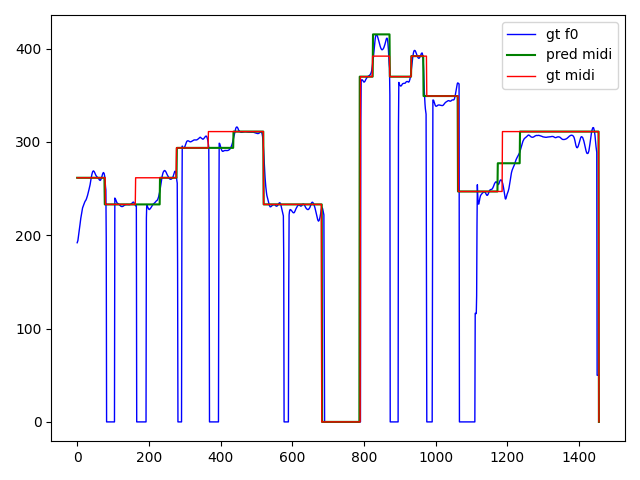
音符转录与对齐
音素级演唱技巧识别(如颤音、假声)
全局风格表征(情感、节奏等)
论文链接:https://arxiv.org/abs/2507.06670
Demo链接:https://gwx314.github.io/stars-demo
代码链接:https://github.com/gwx314/STARS
统一多任务框架:首次集成歌唱转录、歌词对齐、技巧标注与风格分析于单一模型。 五级层次化架构:设计帧/词/音素/音符/句子五级特征编码器,分别进行对应标注任务。 端到端联合优化:多任务学习,避免繁琐的级联方式的多任务标注。
总体架构
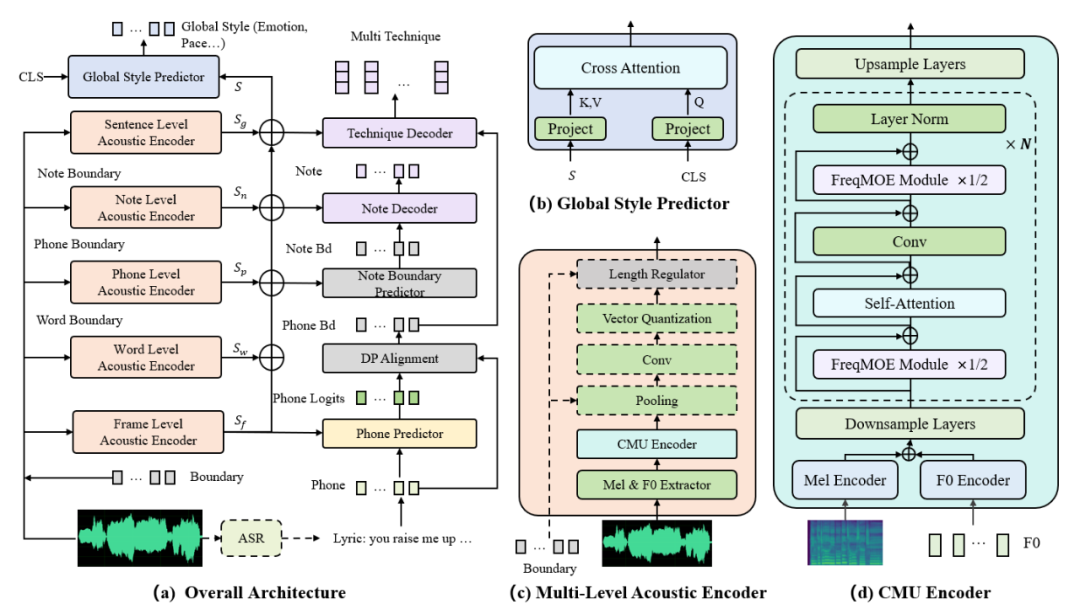
图2:STARS 总体模型架构
图中展示了本文提出的 STARS 的整体框架。模型输入音频和对应的歌词序列。首先,模型通过五种不同层次的声学编码器提取帧/词/音素/音符/句子对应层次的声学特征,然后基于这些提取的特征,实现歌词对齐,音符对齐和转录,音素级别技巧和整体风格的预测。
多级特征提取
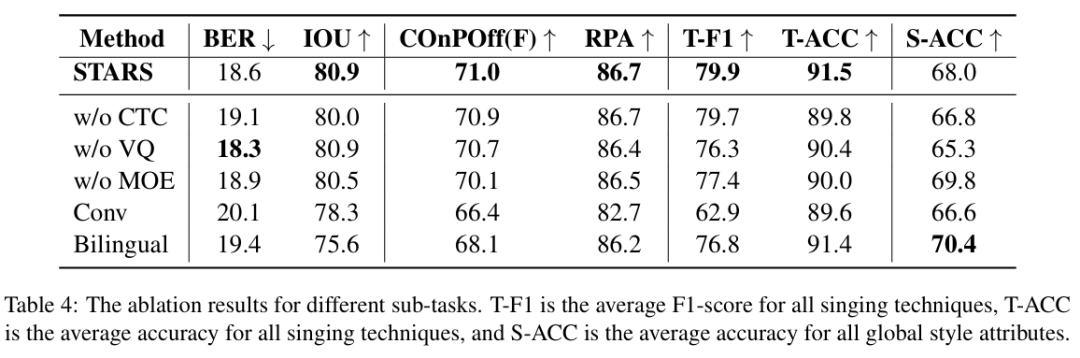
基于U-Net架构,融入Conformer模块捕捉长短期时序依赖,并创新性引入FreqMOE (Frequency Mixture of Experts)对频谱带进行专家建模,通过向量量化(VQ)与长度调节器,动态聚合不同粒度的声学特征(帧→句子)。歌词对齐
进行训练的过程中,融合帧级交叉熵(CE)损失和CTC损失优化音素预测;利用二元交叉熵(BCE)损失优化边界检测。
在推理过程中,结合音素预测概率与歌词序列,采用Viterbi强制对齐算法确定音素/词边界。
音符转录
融合帧/词/音素特征,通过BCE损失训练边界预测器。推理时结合预测的词边界约束生成最终音符边界。基于预测的音符边界,在音符级别特征上,采用加权平均聚合特征并预测音高(CE损失优化)。
风格标注
基于五种层次的声学特征,我们对技巧风格进行了预测
音素级技巧预测:视为多任务多标签二分类(9类技巧:混合音、假声、强音、弱音、滑音、气声、气泡音、颤音、喉音)。利用五级特征及音素边界,采用注意力加权预测各技巧存在性(BCE损失)。
全局风格预测:视为多类别分类任务(情感、节奏、音域、语言、性别)。引入5个[CLS]标记作为查询,五级特征总和作为键/值,通过交叉注意力机制预测各属性(CE损失)。