
 语音小管家
Github:https://github.com/stepfun-ai/Step-Audio2
技术特点
真端到端多模态架构:Step-Audio 2 的架构“真”端到端,直接处理原始音频,保证对副语言信息和非人声信息的有效理解。一改传统的 ASR + LLM + TTS 三级结构,实现原始音频输入→语音响应输出的直接转换;这样架构更简单,能够有效减少时延。此外,技术上采用了连续输入+离散输出范式,能直接处理原始音频波形,避免特征提取造成的信息损失,还能通过离散音频 token 保证声音合成稳定性。最后,在语言建模层,Step-Audio 2 实现了文本与语音 token的 固定比例交错排列,确保文本-语音模态高度对齐,显著提升模型的智商上限。
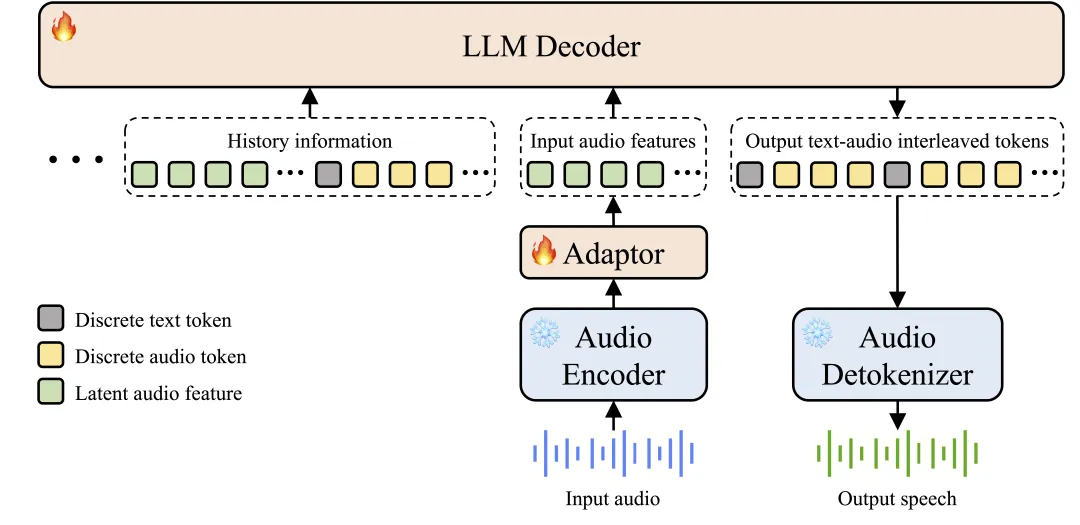
图:Step-Audio 2模型架构图
CoT 推理结合强化学习:团队首创了端到端语音模型中的深度推理能力,能对情绪、副语言、音乐等非文字信号进行精细理解、推理,实现高情商回复。
多模态知识检索增强:模型支持调用 web 搜索,有助于模型解决幻觉问题,同时支持音频检索,让模型可以通过任意自然语言描述来无缝切换音色风格,实现百变音色。
模型性能评测
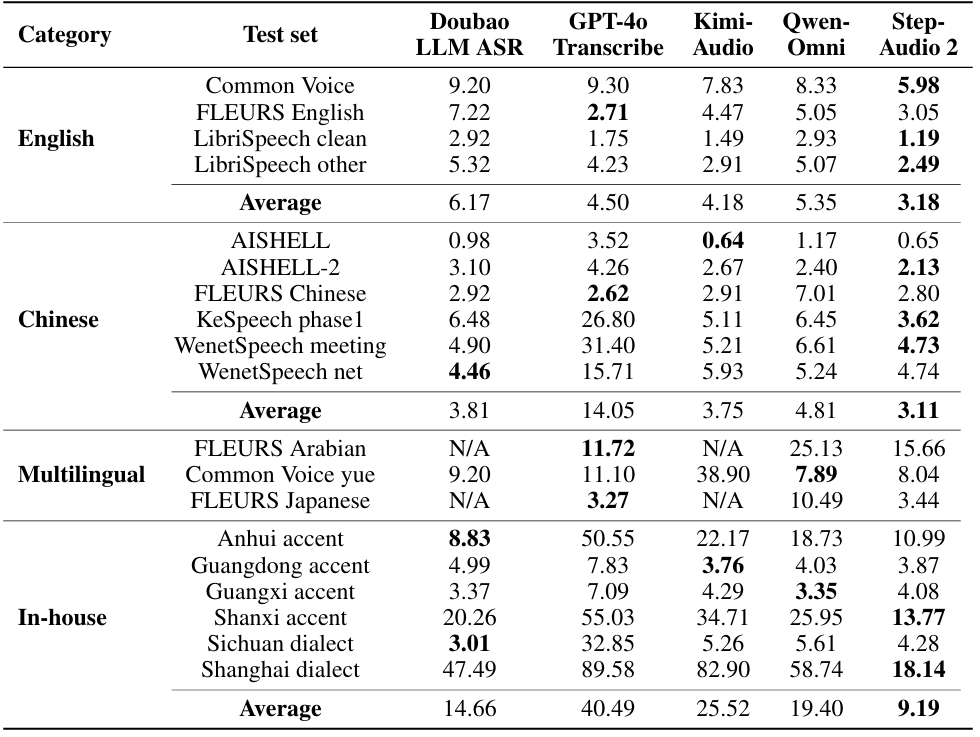
分别评测了音频模型里主流的综合能力评测榜单。发现Step-Audio 2 在AISHELL-2(中文语音识别)、URO-Bench Basic-zh(中文综合语音对话)、LibriSpeech(英文语音识别) 等多个语音任务中均取得 SOTA 成绩,相应表现超越了 GPT-4o Audio、Gemimi-2.5-Pro、Qwen2.5-Omni 等国内外主流模型。
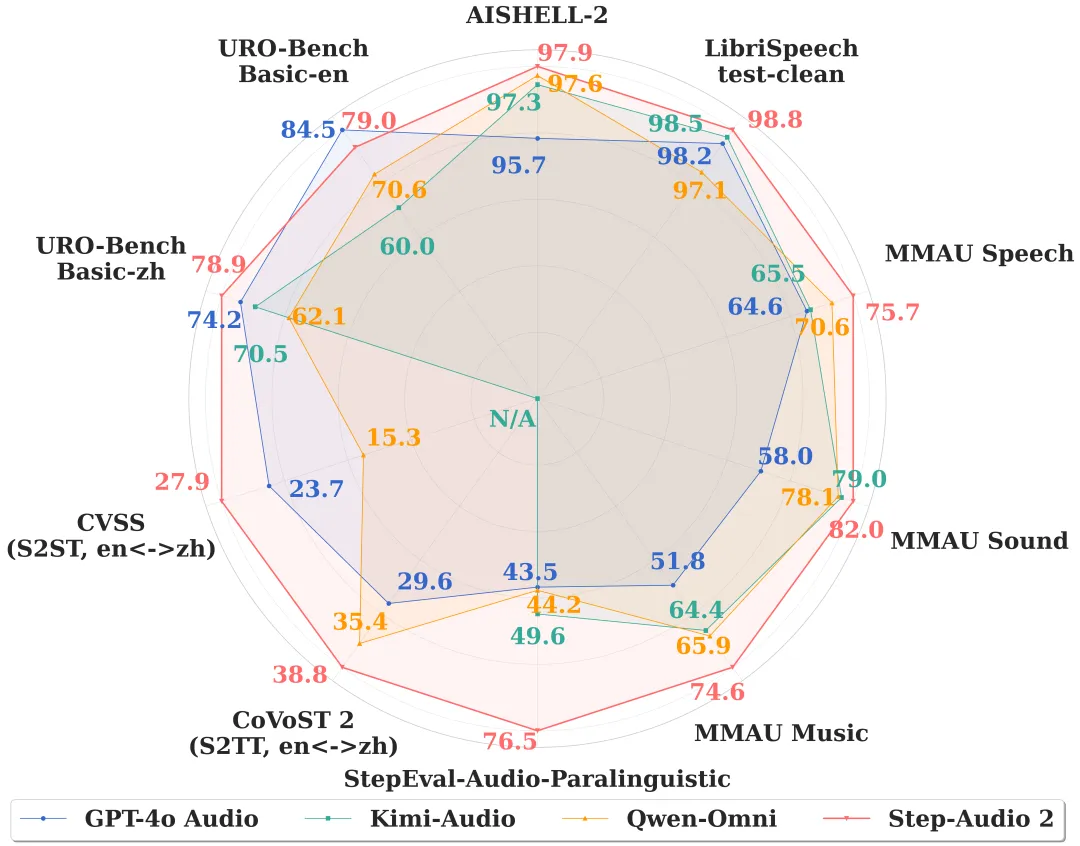
图:Step-Audio 2 榜单成绩
在包含11类副语言信息的测试中,准确率达到了76.55%,远超其他模型。
具体来说,它能精准识别:
说话人的性别和年龄特征
声音的音色和音高
表达时的情感状态
说话的节奏和速度
独特的说话风格
背景场景和事件声音
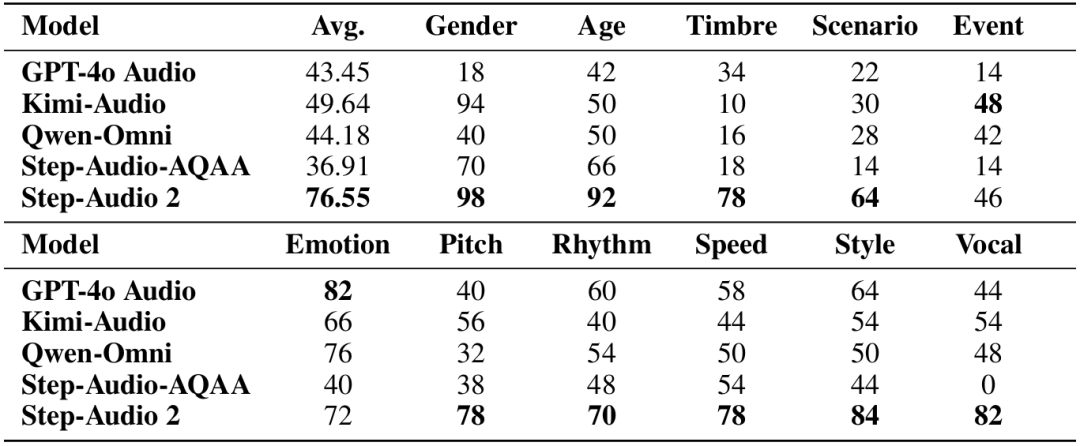
这张表特别值得关注的是,Step-Audio 2在"情感"和"风格"两个维度表现尤为突出,说明它能真正理解并生成带有情感色彩的语音。
在测评的过程中,发现了现有主流的榜单中缺乏对副语言(性别、年龄、情感、语速)理解能力、语音 toolcall 综合能力评测;因此该团队公开了建立的StepEval-Audio-Paralinguistic、StepEval-Audio-Toolcall 评测基准,分别首次系统衡量语音模型在副语言理解与工具调用两大能力维度的表现,构建起了衡量语音“非文字信息理解能力”的评测标准。
通过自然语言指令,Step-Audio 2可以实时切换多种说话风格:
调整情感:输入"悲伤地朗读这段话",它就会用悲伤的语调表达; 切换方言:支持粤语(8.04%错误率)、上海话(18.14%错误率)等多种方言; 改变韵律:可以生成RAP、干声哼唱等特殊说话风格。
总 结
Step-Audio 2的这项技术或许标志着语音交互从"机械应答"向"情感智能"的重要转变。未来,我们可能会看到:
虚拟偶像直播时可以实时切换多种音色和情感状态
方言保护与文化传承借助AI技术得以实现
AI助手能够感知用户情绪并相应调整回复风格
当然,如何在生成语音的自然度与可控性之间找到最佳平衡,仍是未来需要探索的方向。
