
 语音小管家
来源丨中国电信人工智能研究院
同样的文字,在不同语境下,根据说话人的语速、语气、语调的差异,会表达完全不同的意思,代表不同的情绪、态度和意图。
这项应用的背后,是中国电信人工智能研究院(TeleAI)研究的一项新的技术路径——超语义语音学(Beyond-Semantic Speech,简称 BoSS),由中国电信集团 CTO、首席科学家、中国电信人工智能研究院(TeleAI)院长李学龙教授带领团队创新提出。
BoSS 是语音交流中包含但超越显性语义的信息集合。这些信息除了通过显性语义的内容,还通过情感线索、动态语境和隐性语义等多维特性来传递更丰富、更细腻的交流意图。简单来说,就是让 AI 能够听懂“话中有话”和“弦外之音”。
在李学龙教授的带领下,TeleAI 还提出语音对话大模型评测基准TELEVAL 和基于 BOSS 的超拟人对话大模型 GOAT-SLM。
BoSS-超语义语音学
回望历史,我们发现人类对自身语言的探索从未停止。早在 1958 年,就有语言学家提出了“副语言”的概念,揭示语音中存在着语调、停顿、语速等非文字的交流成分。
进入计算时代,“情感计算”的概念于 1995 年被提出,开启了副语言的建模研究。到 2010 年,出现了“计算副语言学”,开始使用机器学习方法建模语音中的情绪、社会属性和交流风格,标志着副语言研究进入数据驱动阶段。
近年来,随着语音大模型的发展,人工智能在语音识别、语义理解等方面取得了显著进展。然而,当前主流模型普遍将建模重心放在字面语义和情绪维度上,往往依赖监督式分类标签或粗粒度的情感表示,难以捕捉语音交流中更复杂、更隐含的副语言信号。
例如,在处理个体化特征(如说话人性格、身份、表达风格)和非语信息时缺乏细致建模能力。在语境感知方面,往往只关注短期对话历史,无法建立稳定的长期语用建模机制。而在面对讽刺、暗示、模糊表意等言外之意时,模型的生成与理解的表现常常缺乏灵活性。
TeleAI 提出的超语义语音学(BoSS)是语音交流中包含但超越显性语义的信息集合。这些信息除了通过显性的语义内容,还通过情感线索、动态语境和隐性语义等多维特性来传递更丰富、更细腻的交流意图。
BoSS由显性语义、情感线索、语境动态和隐性语义组成。
显性语义:包含词汇、句法、逻辑结构等;
情感线索:包含语音特性、非语音声音、情感表达等;
语境动态:包括背景声音、交流节奏、场景线索、历史交互信息等;
隐性语义:包括语义修饰、间接意图、身份推断等;
TeleAI 还提出了 BoSS 的数学建模框架,用于推理语音的最可能含义。
在语音交流中,接收者尝试寻找一个最能解释当前观测的“意义假设”。这个寻找过程遵循关联理论,即最大化认知效果与处理成本的比率。
在给定观测数据和外部语境的情况下,把想要找出的最佳答案定义为最佳意义假设 (Optimal Meaning Hypothesis) 。这个假设是所有可能假设中,能带来最大认知效果与处理成本比率的那一个。在时间步 t 的最佳意义假设是通过最大化关联度来确定:
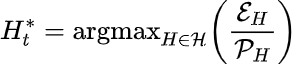
这个公式表示某一时刻最可能的“言外之意”假设;公式中分子表示该假设带来的认知收益,分母表示理解这个假设所需的努力或成本。这个比值越高,机器越倾向接受该假设为当前语音的真实含义。
为了系统衡量人机语音交互系统的发展水平,TeleAI提出了一个从 L1 到 L5 的五级能力分级体系,从最基础的语音命令识别到具有类人对话智慧的系统,每一级代表了对语言理解、语境感知和超语义处理能力的逐步提升。
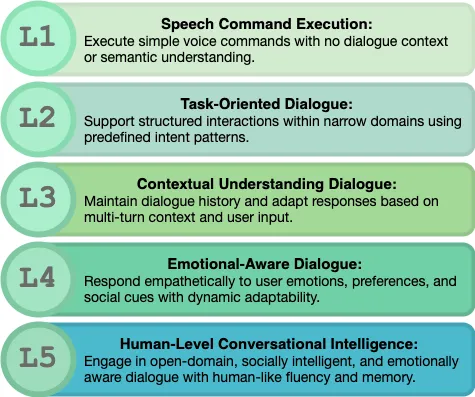
Level 1:语音指令执行
系统只能识别特定关键词或短语,用于执行简单的单轮语音命令,类似于“语音遥控器”。不具备上下文理解或意图推理能力,主要依靠规则驱动的响应机制。
Level 2:任务型对话
系统可在特定场景下(如订票、查天气等)进行结构化的任务对话,具备基本意图识别与槽位填充能力,但无法跨轮保持上下文,也无法感知用户的情绪或交流风格。
Level 3:上下文感知对话
系统开始具备一定的多轮对话能力,能够追踪对话状态、进行指代消解与语义承接,适应更复杂的上下文需求。然而,理解仍以任务驱动为主,尚未具备深入的情绪理解或社交意识。
Level 4:情绪感知对话
系统能够识别用户的情绪状态、说话风格与偏好,并相应调整语言风格、语气与表达方式,展现出一定程度的“共情”能力。具备个性化建模能力,能更灵活地适应不同用户与场景。
Level 5:类人社交智慧对话
系统达到了类人的交互智能水平,具备开放域对话能力和丰富的超语义理解能力,包括情绪感知、语境建模、间接意图推理等。同时具备“社交情商”:能理性应对批评、理解言外之意、表达边界与立场,支持多用户、多轮长对话,并通过长期记忆、情绪调节、自我修正等机制实现可信、共情、人性化的交互体验。
这个分级框架为分析和衡量语音交互系统的能力提供了一个参考标准。每个级别都反映了在语言理解、语境整合和交互策略方面不断提高的能力。特别是较高级别(L3-L5),强调的是系统处理和响应语义以外信号的能力,如情感语气、说话者意图和情境语境,这些对于建立更自然、更符合人性化的对话系统至关重要。
论文地址:https://arxiv.org/pdf/2507.17563
TELEVAL-语音对话大模型评测基准
过去两年,各类语音对话大模型(SLMs)在各大公开榜单上你追我赶,成绩斐然,不断刷新人们对“语音理解力”的期待。然而,当这些模型真正走入真实生活场景,却往往面临另一番考验:它们能背古诗、做逻辑推理,却听不懂老人家的方言,也感受不到孩子委屈的哭腔——这些细腻的语音信号,正是通往真正“智能交互”所需跨越的门槛。用户真正需要的不仅仅是“百科全书”,更是“会聊天的伙伴”。
为此,TeleAI 还发布了一个专为中文真实交互场景设计的语音对话大模型评测基准:TELEVAL。它不是传统意义上做做听写、答答选择题的“听说考试”,而是一次对“语音交互能力”的全面考察。它不再问“模型知道什么”,而是拷问“模型能否像人一样对话”。
大多数现有基准集中于评估 SLMs 是否能完成特定任务,却忽略了人与人之间最本质的东西——自然交谈。而 TELEVAL 则从用户出发,打造了一个“三维立体考场”:
1.显性语义(Explicit Semantics):能听懂你说了什么,并给出正确回复。
2.隐性语义与副语言(Paralinguistic & Implicit Semantics):能懂你的情绪、方言、咳嗽、年龄背后的“潜台词”,并给出拟人化的回应。
3.系统能力(System Abilities):在噪声、回音、失真、丢包等真实环境下,依然能回应得体。
这不仅是对 SLMs “理解能力”的检验,更是对其回复是否具有“共情力”、“人味儿”、“实用性”的考验。
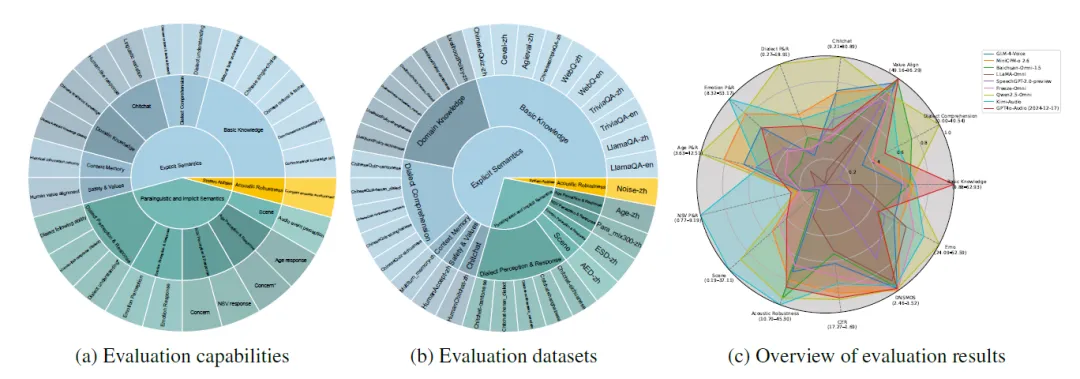
TELEVAL 是一个动态更新的评测基准,目前已推出超过 40,000 条高质量测试数据,涵盖 5 大方言、3 种年龄层、11 种声学失真场景、情绪/非语音表达/环境声等真实用户交互因素,还贴合中国本土生活,包括方言的听与说、民生政策问答、中国文化常识。
TELEVAL 远不止是一个只能跑分的数据集,它是一套“推理-评测-打分”一体化的完整框架(支持文本/语音输入与输出、支持 SLMs/LLMs 双模评估),不仅提供丰富多元的任务数据,还内置了从语音/文本输入,到模型响应,再到自动化评分与分析的全流程工具链。只需接入模型,就能“一键跑通”评估任务。
技术报告:https://arxiv.org/pdf/2507.18061
开源地址:https://github.com/Tele-AI/TELEVAL
https://huggingface.co/datasets/Tele-AI/TELEVAL
GOAT-SLM-基于 BOSS 的超拟人对话大模型
近年来,端到端语音大模型(SLMs)取得了快速进步。然而,大多数现有模型仍主要将语音看作是传递语言内容的载体,忽视了音频信号中包含的丰富的副语言和说话人特征线索。包括方言、年龄、情绪以及咳嗽等非言语发声等,对于实现更加自然、适应性强和富有同情心的人机交互至关重要。
为弥补这一差距,TeleAI提出了一个能够感知并对这类非语言发声信息做出反应的超拟人对话大模型:GOAT-SLM,通过副语言和说话人特征感知来提高交互质量。
在模型构建方面,SLMs通常遵循两种主要范式。
第一种是直接应用大型语言模型(LLM)训练范式的语音原生方法,例如 Moshi、SpeechGPT、Viola等。
第二种是利用强LLM核心并通过跨模态对齐整合语音输入/输出模块的模态对齐方法,例如Freeze-Omni、Salmonn-Omni等。
在GOAT-SLM中,由于其计算效率及重用预训练语音和文本模型的能力,TeleAI采用了模态对齐框架作为基础。
GOAT-SLM 围绕四个核心原则设计的超拟人语音对话大模型,即面向生成的双模态设计、有序的模块化训练、副语言和说话人特征感知、保留文本智能。
架构
GOAT-SLM采用了一种双模态头架构,其中预训练LLM的共享下层充当语义核心。这个核心分支成两个特定模态的头:一个用于文本生成,另一个用于语音令牌生成。
这种分支架构带来了三个关键优势。
首先,通过将语言建模与声学实现解耦,它保留了LLM的核心推理和理解能力。
其次,它通过利用丰富的语义表示实现了高保真度和表现力强的语音合成。
第三,该架构支持灵活的任务特定训练。
例如,在大规模自动语音识别或文本到语音转换数据集上训练可以获得高表现的TTS效果。或者,在配对的语音问答数据上训练则可实现口头问答。
实际上,TeleAI扩展此框架实施了GOAT-TTS,用于生成合成的语音对话数据以训练 GOAT-SLM。
如图1所示,模型包括五个功能模块,听、思考、写、说、流匹配,旨在支持统一的语音和语言理解和生成。这些模块共同作用,以实现带有副语言和说话人特征感知的无缝口语对话交互。
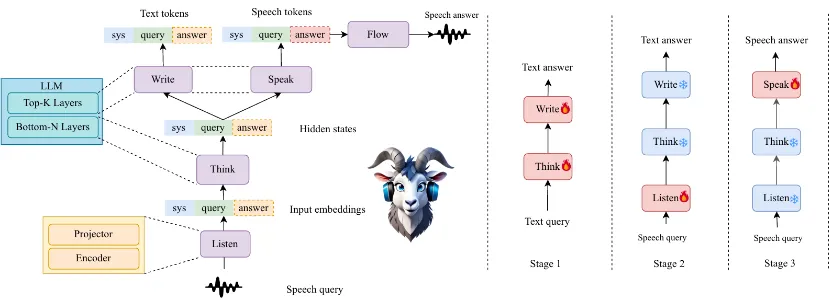
“听”模块由一个语音编码器和一个投影器组成,它们共同将输入语音转换为与大语言模型(LLM)嵌入空间对齐的潜在表示。这使得语音输入可以在与文本相同的Token空间中处理,从而促进跨模态的语义融合。
“思考”模块由LLM的底部N层组成,用作共享的语义推理核心。
“写”模块利用LLM的顶部K层生成文本响应,构建了一个“听-写”路径,用于标准的文本交互。
“说”模块复用相同的顶部K层,但对输出层进行了适配,以预测语音Token,从而构建出一个“思考-说”路径,实现语音生成。
“流匹配”模块作为语音解码器,将预测得到的语音Token序列转换为声学特征(例如声谱图),这些特征随后通过声谱图到波形的Vocoder合成出音频波形。
在实现中,“听”模块采用了Whisper-small作为语音编码器,其后接一个由两层卷积神经网络和两层Transformer组成的投影器。作为语言主干网络,TeleAI使用了 TeleChat2-7B,其中底部15层构成“思考”模块,顶部15层则被“写”和“说”模块共享,分别用于生成文本和语音Token。
训练方法
对于训练,TeleAI引入了一种由三个阶段组成的有序模块化训练策略:
第一,指令调优:将诸如方言、年龄和情绪等属性注入用户指令中,使LLM能够识别并响应细微的发声线索。这使得LLM能够生成更加富有同情心和上下文适当的响应。
第二,模态对齐训练:使用重复和延续策略,在冻结LLM主干的同时对齐语音和文本模态。这使得能够在不降低LLM预训练能力的情况下进行语音-文本对接。
第三,高保真语音生成优化:细化语音头部以增强自然度、清晰度和表现力。在整个过程中,LLM的文本智能得到了保留,确保了强大的通用推理和指令跟随能力。
效果评估
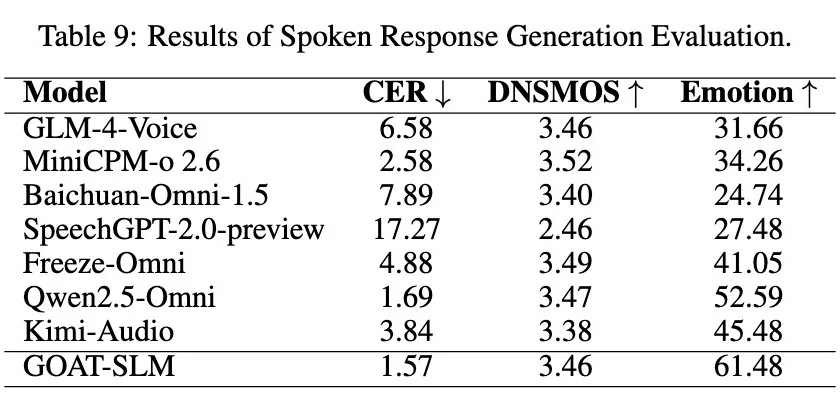
为了系统评估GOAT-SLM的能力,TeleAI使用 TELEVAL对其进行评估,旨在测量两个关键领域:语义智能,具有副语言和说话人特征感知的交互。
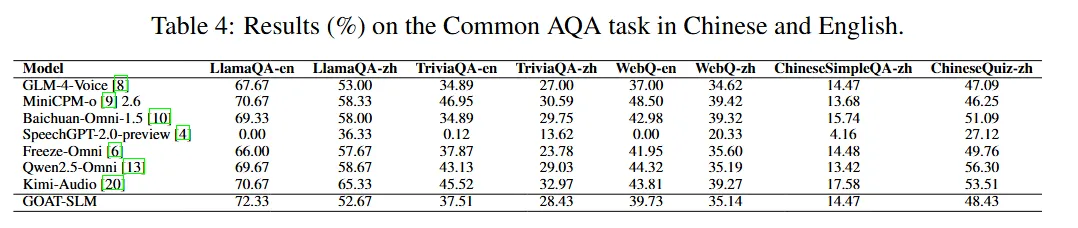
语义智能评估包括多语言问题回答、方言问答和多轮对话,目标是测试模型在语音交互中准确理解、推理和回应的能力。
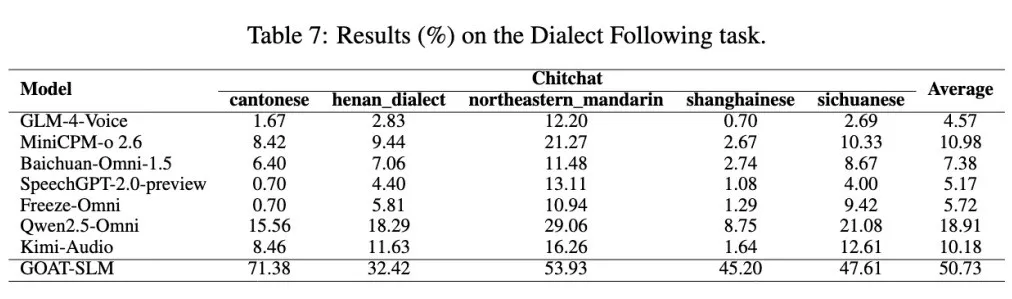
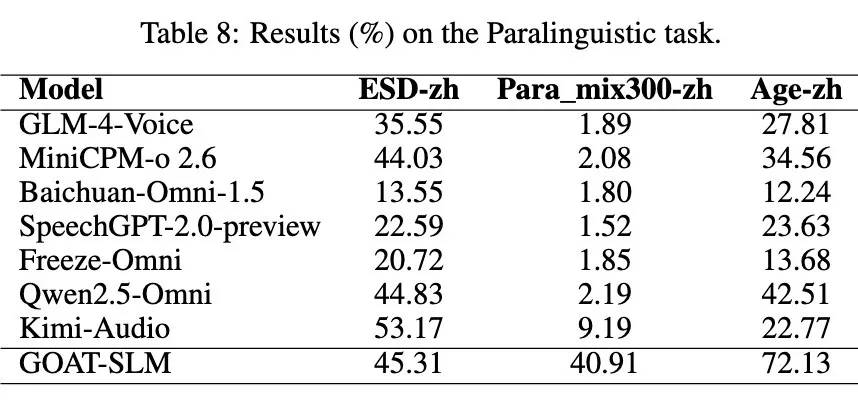
副语言和说话人特征感知评估涵盖基于情绪的响应生成、方言适应、年龄感知交互以及非言语发声响应,重点在于模型感知声音特质并产生适应性口语回应的能力。
以下是在这两个大维度的测试得分情况。
通用语义智能
方言跟随
情绪、年龄、非语响应
技术报告:https://arxiv.org/pdf/2507.18119
