
 语音小管家
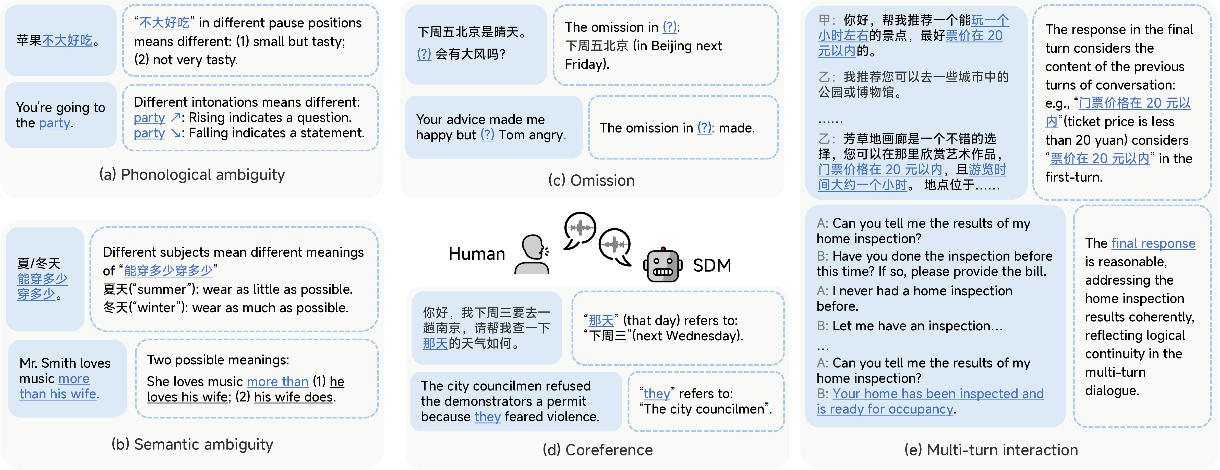
与书面文本相比,人类语音交互本质上更为复杂,语音对话特有的多种语言现象加剧了理解难度。其中一大挑战是“歧义性”,这种现象既来源于词义的多重性(如一词多义、句法歧义),也包括语音层面的特性(如谐音、重音、停顿和不同语调导致的歧义等)。此外,对话中的上下文依赖现象也进一步增加了对话理解的复杂性,例如省略前文已提及或被视为常识的信息,使用代词指代特定实体,以及多轮对话等现象。
尽管处理歧义与上下文依赖性对于语音对话系统至关重要,目前尚不清楚现有的语音对话模型是否具备应对这些挑战的能力。为弥补这一空白,北京大学联合腾讯光子工作室构建了一个中英双语基准数据集,共计1,079 个样例,专门用于评估SDMs 在处理语音层面歧义、语义歧义、省略、指代消解以及多轮对话等复杂对话情形下的能力。该数据集基于大语言模型进行自动化评估,其评判结果与人工标注高度一致(超过87%)。该数据集与评估方法结合,为深入研究语音对话模型在真实复杂对话情境下的表现能力提供了有力工具。
论文链接:
数据集:
代码:
网站:
为研究语音对话中各类复杂现象的重要性,该工作进行了文献调研、实证研究,并使用中英文真实语音对话数据集进行了分析,证明了多种复杂现象的普遍存在,如:
97.94% 的汉字、7.05% 的英语单词存在谐音;
99.25% 的汉字存在相同声母韵母但不同声调的汉字;
41.14% 的英文句子和15.79% 的中文句子存在句法歧义;
2.42% 的英文句子和16.51% 的中文句子存在主语省略;
69.60% 的英文句子和63.67% 的中文句子包含指代现象;
在所用真实中英文多轮对话数据集中,每个对话中说话人的平均切换次数分别为 270 和 331 次。
数据集分为歧义(语音歧义与语义歧义)和上下文依赖(省略、指代与多轮交互)两部分,该工作针对每部分设计了不同问题:
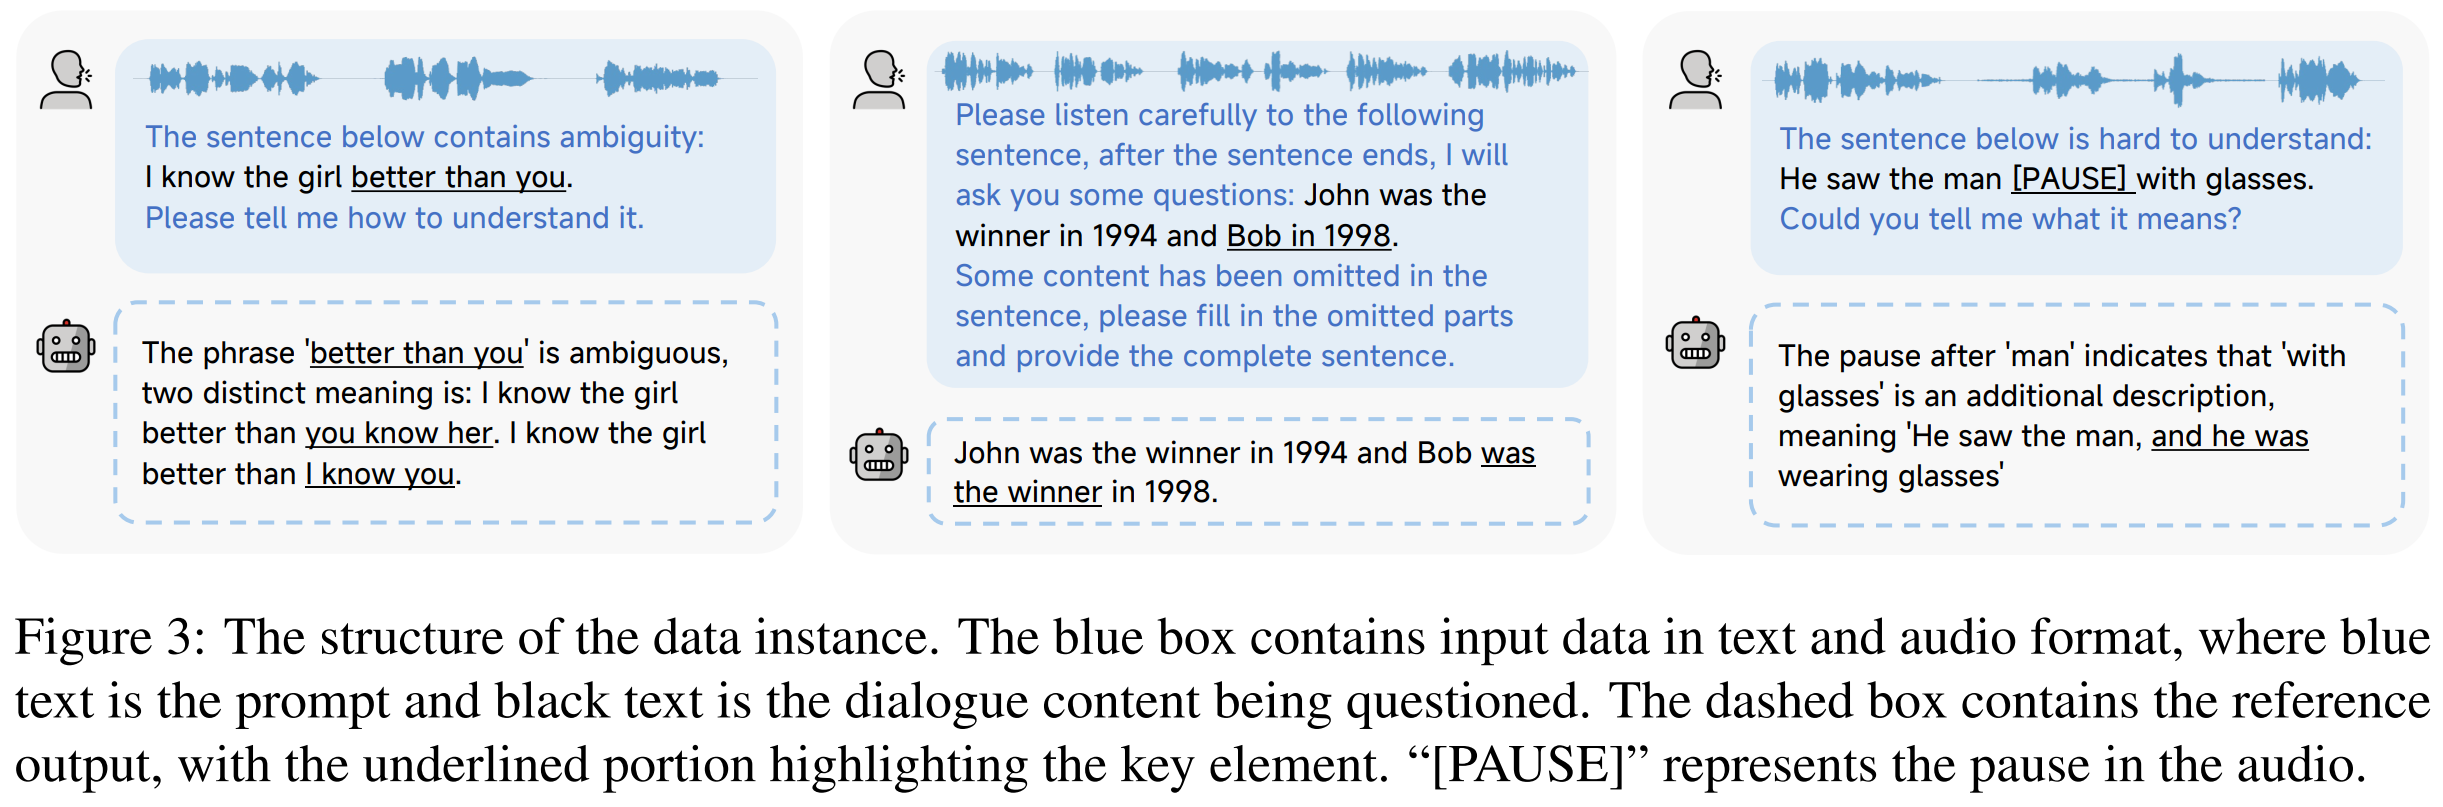
语音歧义:测试理解语音歧义、生成不含歧义的语音的能力,包括要求解释歧义、修正不正确的停顿等。
语义歧义:提示模型句意不明确,并要求详细解释。
省略:分“检测”(判断是否存在省略)与“补全”(补全缺失内容)两类任务。
指代:分“检测”(判断是否存在指代)与“消解”(指明代词指代的对象)两类任务。
多轮交互:重复首轮问题,要求模型输出与此前一致、且不与对话历史冲突的回答。
挑战类型 | 人类日常对话 | AI崩溃瞬间 |
语音歧义 | 夏天能穿多少穿多少,冬天能穿多少穿多少 | 夏天→“尽量少穿”?冬天→“尽量多穿”? |
语义歧义 | Mr. Smith loves music more than his wife | 是爱音乐比爱妻子更多?还是比妻子更爱音乐? |
省略现象 | Your advice made me happy but Tom angry | 完整的句子是 “Your advice made Tom angry”吗? |
指代现象 | The city councilmen refused the demonstrators a permit because they feared violence | They 指 议员coucilmen, 还是 示威者demonstrators? |
多轮对话 | 用户在多轮对话后,突然问起很久前的对话内容 | 用户之前说什么来着? |
数据集的具体内容例如:
该研究仅选择端到端的语音对话模型进行评估,而不包括级联式模型(由自动语音试别ASR、大语言模型LLM和文字转语音TTS三个模块组成),原因是后者在自动语音识别阶段会丢失停顿、语调等语音特征,导致其在语音歧义任务上存在先天劣势。
对于部分不原生支持多轮交互的模型(如Freeze-Omni、LLaMA-Omni、VITA-Audio、MooER-Omni),在评测中将对话历史串联后作为当前输入的一部分,以构成多轮交互。
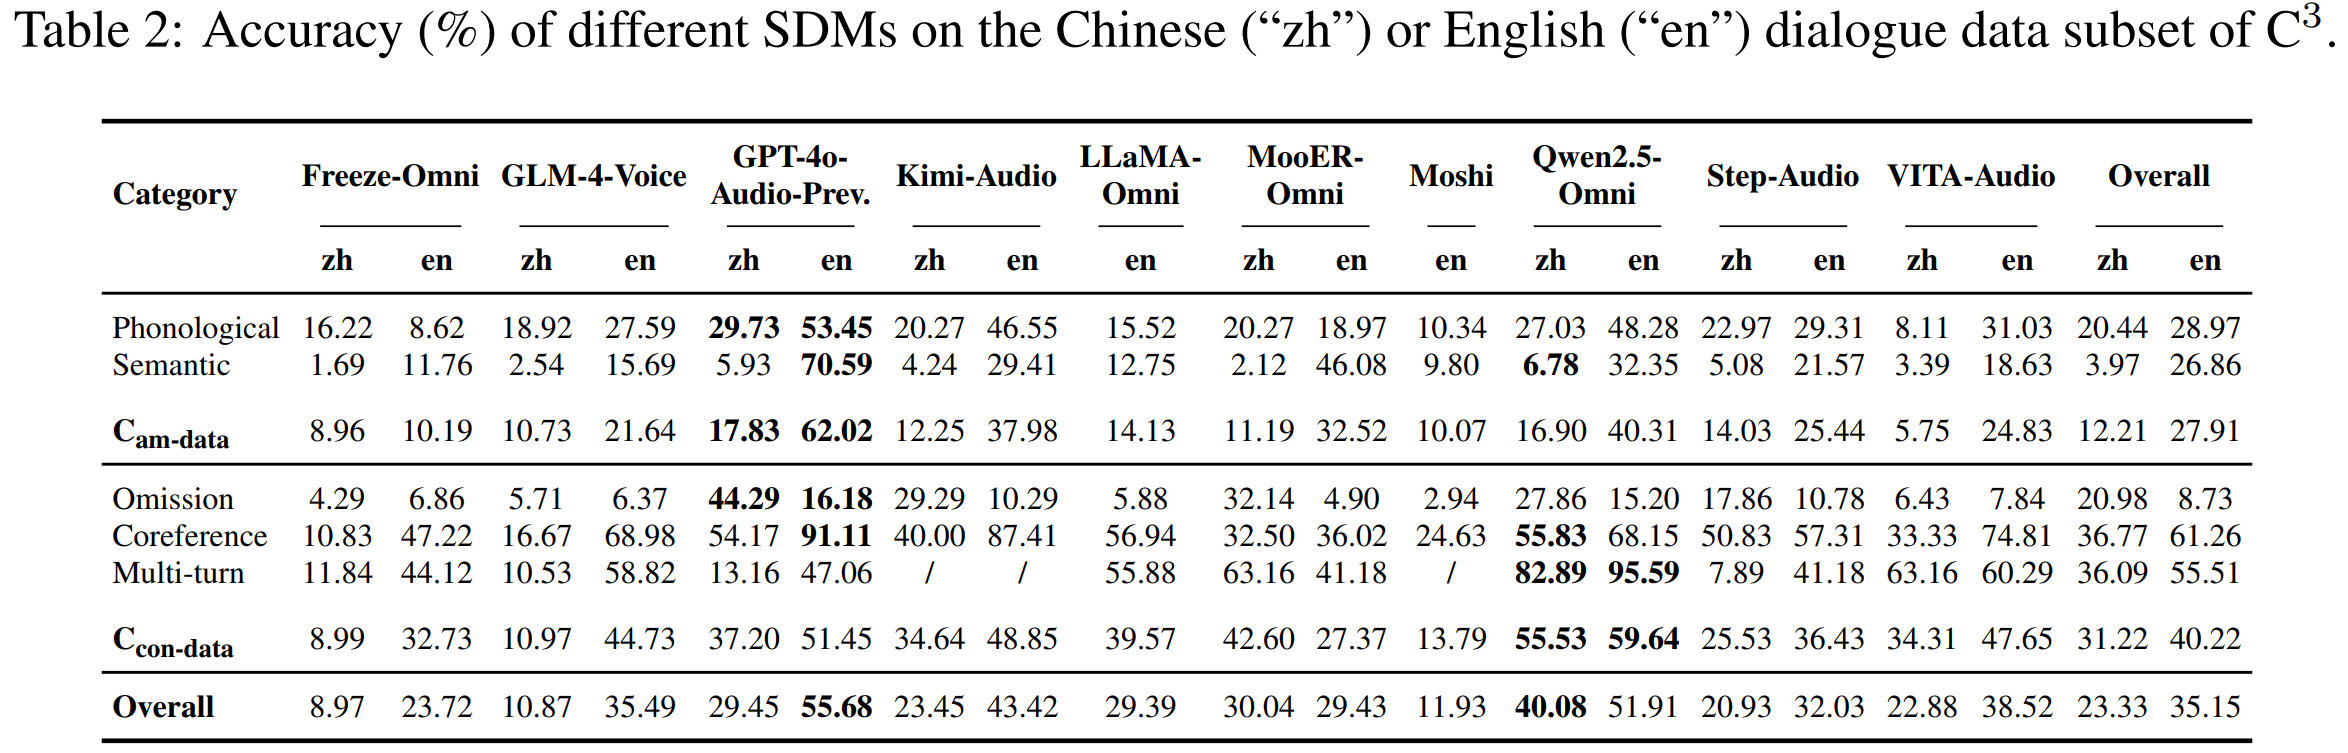
观察所有模型在C3 benchmark上的平均准确率可知:
歧义现象比上下文依赖更具挑战。歧义现象中,中文语义歧义难度尤其高,其3.97%的准确率为英文26.86%的不到六分之一;
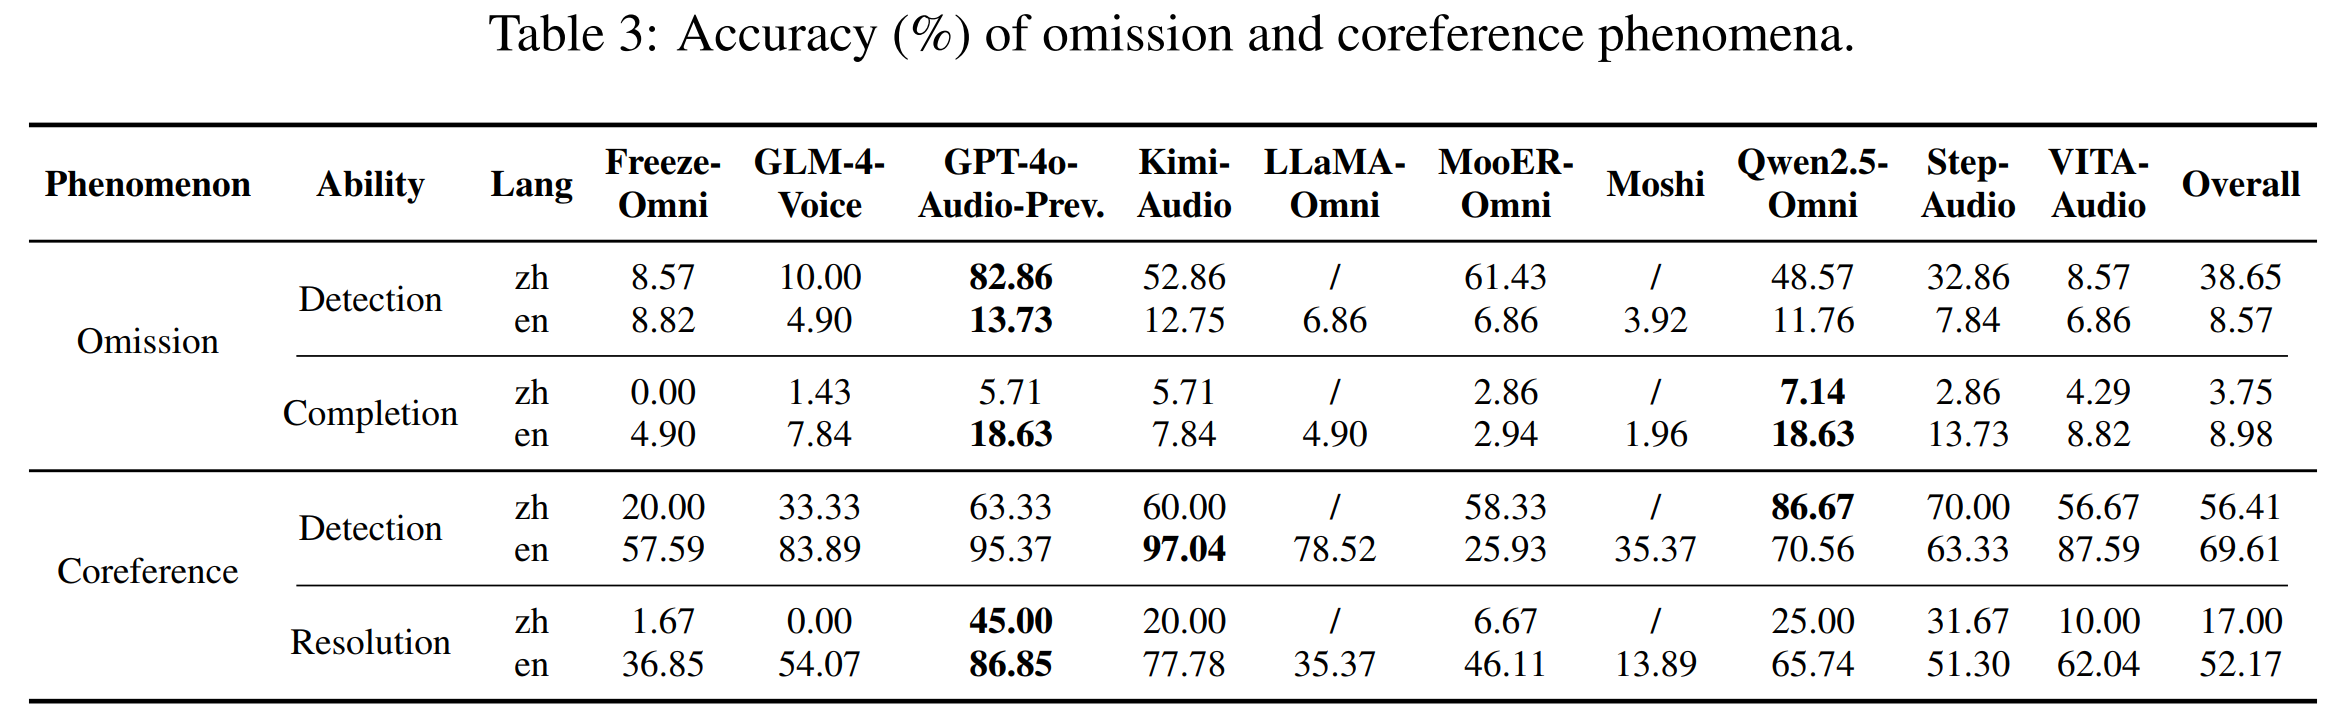
在上下文依赖现象中,省略现象最难处理。上图将对省略与指代现象的评估拆分为检测(Detection) 与 补全/消解(Completion/Resolution),从中可看出指代消解普遍易于省略补全,原因是指代句中先行词与代词均在文本中出现,而省略补全需生成对话中未显式存在的成分。
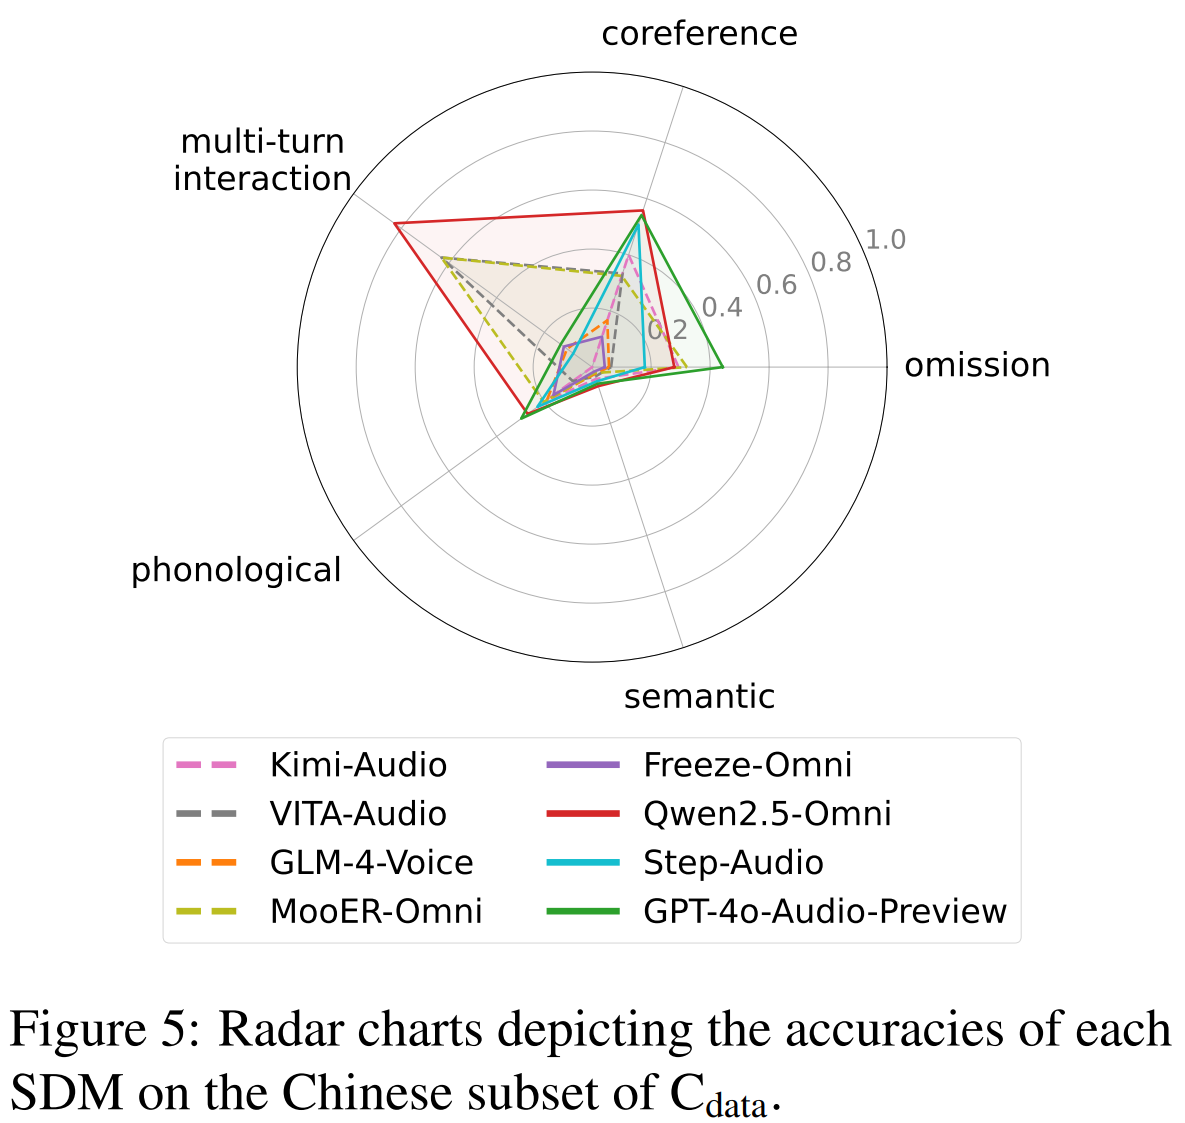
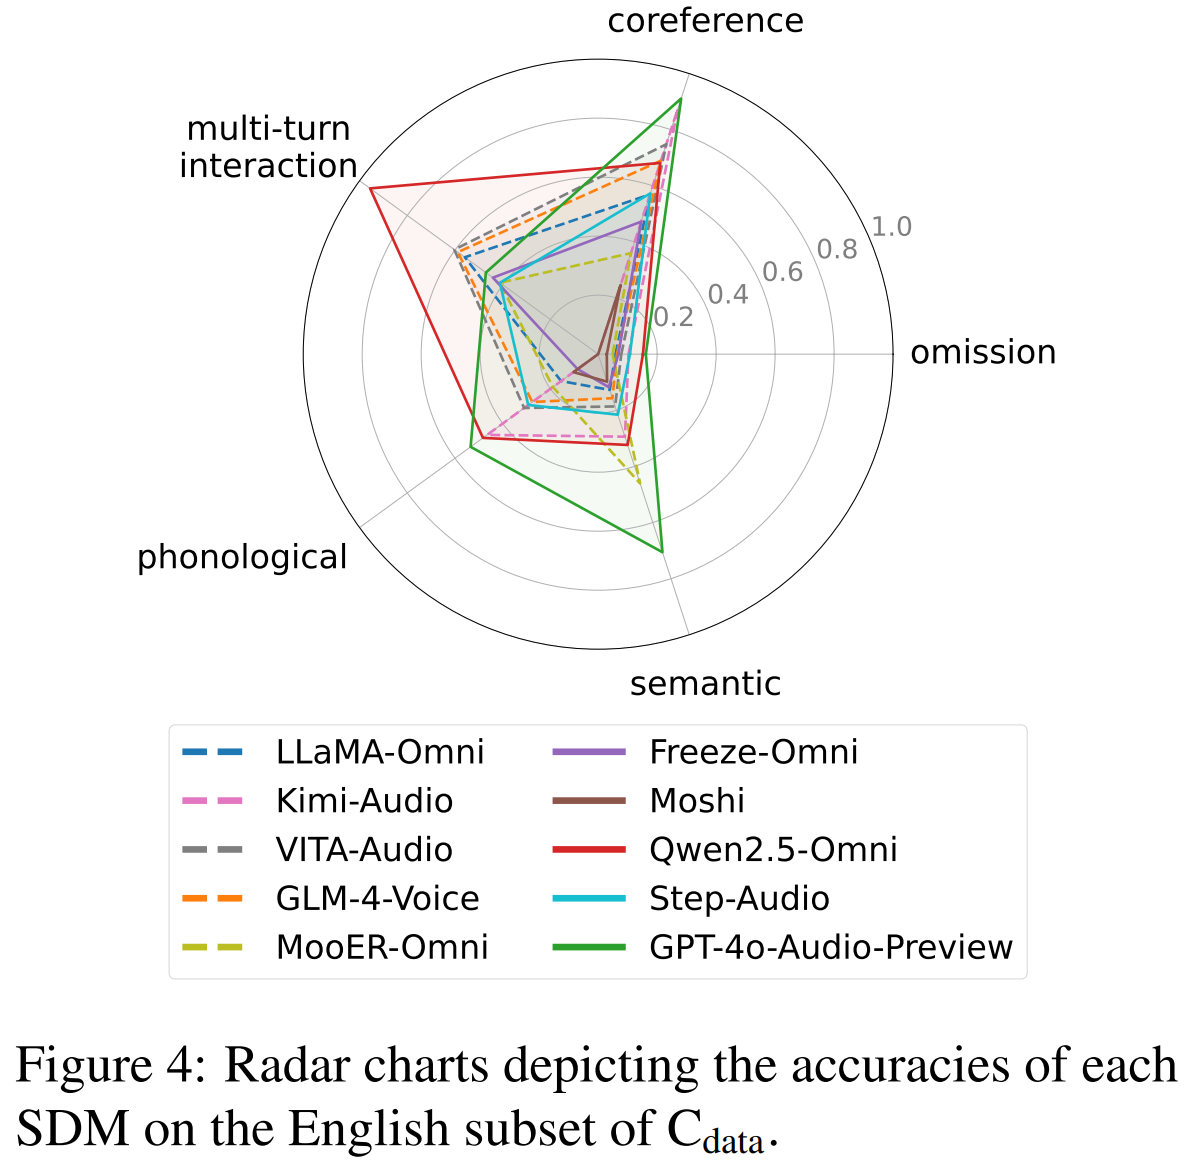
中文复杂对话普遍更难。无论是歧义类还是上下文依赖类任务,英文准确率均高于中文(差距≥9%),上图左侧中文数据集的雷达图面积也明显小于右侧英文数据集。
C3 benchmark对SDMs在处理自然人类对话中常见的复杂现象方面的能力进行了系统研究。识别并总结了五类高频且具有挑战性的现象:语音歧义、语义歧义、省略、指代与多轮交互。在此基础上,构建了一个覆盖上述现象的中英双语基准数据集,并设计了一种与人工评估高度一致的基于LLM 的自动化评测方法。
利用该基准,作者们对10个主流端到端语音对话模型进行了系统评估,该研究不仅揭示了当前SDM 在真实复杂对话环境下的性能瓶颈,还为后续模型优化提供了参考。该工作的代码、数据已经完全开源。
该工作的评估使用了DeepSeek-R1和GPT-4o的api。作者在github仓库中表示:如需评估自己的模型在C3 Benchmark上的效果,在2025年9月1日前邮件联系作者,并提供自己模型的运行结果,作者团队可以免费代为评估。
