
 语音小管家
来源丨本原智数、HyperAI超神经
近日,谷歌DeepMind正式发布并开源了全新的生物声学模型Perch 2.0。相较于前代,Perch 2.0 以物种分类为核心训练任务,不仅纳入了更多非鸟类类群的训练数据,还采用了全新的数据增强策略与训练目标,在 BirdSET 和 BEANS 两项权威生物声学基准测试中均刷新当前 SOTA。
生物声学(Bioacoustics)是生态学和保护生物学中的重要研究手段。通过分析动物的发声,科研人员可以监测物种分布、种群数量、繁殖状况以及栖息地健康。
然而,面对动辄数千甚至数百万小时的被动声学监测(PAM)录音,要从中快速准确地识别特定物种,尤其是稀有或未标注的物种,仍是一大挑战。
Perch 2.0正是为这一需求而生的多用途工具,它能做到:
直接分类:能够为数千种鸟类及其他动物的发声提供即用型分类分数。
特征提取:生成高质量嵌入(embeddings),便于下游的聚类、相似度检索、少样本分类以及行为模式分析。
敏捷建模:与Google Research提出的“Agile Modeling”流程结合,可通过少量样本和高效向量检索,在数十分钟到一小时内构建出新物种或新行为的识别器。
低门槛部署:模型体积小、推理高效,可在消费级硬件运行,降低生态机构与保护组织的技术成本。
与上一代仅使用鸟类录音不同,Perch 2.0的训练集涵盖了来自四大数据源的154万条录音,总共14,795个类别,包含以下数据集:
Xeno-Canto:全球最大鸟类录音公社,包含 86 万余条鸟类音频。
iNaturalist:研究级别的多物种录音,覆盖鸟类、两栖类、昆虫、哺乳动物等。
Tierstimmenarchiv(柏林自然博物馆动物声库):提供高质量、多物种声学记录。
FSD50K:包含多类非鸟类环境声与动物声事件。
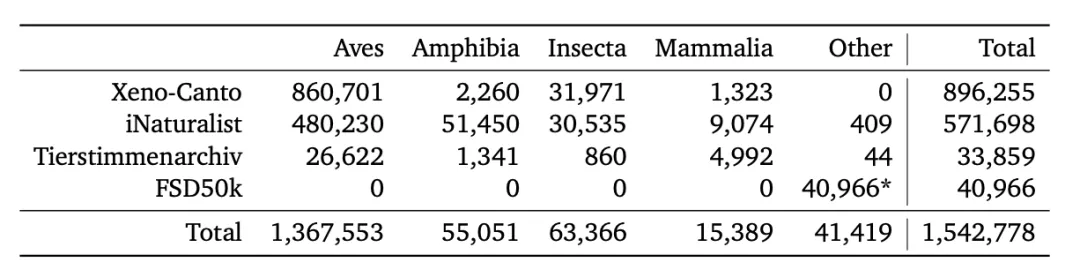
在数据处理阶段,研究团队统一了不同数据集的物种命名体系,剔除了无法用所选频谱参数表示的蝙蝠录音,并针对长短不一的原始录音进行了固定5秒窗的切分与筛选,以确保训练过程的稳定性和覆盖面。
Perch 2.0 的模型架构由前端(frontend)、嵌入网络(embedding model)和一组输出头(output heads)共同构成,各部分协同实现从音频信号到物种识别的完整流程。
其中,前端负责将原始音频转换为模型可处理的特征形式,其接收 32kHz 采样的单声道音频,针对 5 秒长的片段(含 160,000 个采样点),通过 20ms 窗长、10ms 跳长的处理,生成包含 500 帧、每帧 128 个 mel 频带的 log-mel 频谱图,覆盖 60Hz 到 16kHz 的频率范围,为后续分析提供基础特征。
嵌入网络采用 EfficientNet-B3 架构——这是一款包含 1.2 亿参数的卷积残差网络,凭借深度可分离卷积设计最大化参数效率。相比上一版本 Perch 使用的 7,800 万参数 EfficientNet-B1,它的规模更大,以匹配训练数据量的增长。
通过嵌入网络处理后,会得到形状为(5, 3, 1536)的空间嵌入(维度分别对应时间、频率和特征通道),对空间维度取均值后,可获得 1536 维的全局嵌入,作为后续分类的核心特征。
输出头则承担着具体的预测与学习任务,包含 3 个部分:线性分类器将全局嵌入投影到 14,795 维的类别空间,通过训练促使不同物种的嵌入线性可分,提升后续适配新任务时的线性探测效果;原型学习分类器以空间嵌入为输入,为每个类别学习 4 个原型,取原型最大激活进行预测,这一设计源自生物声学领域的 AudioProtoPNet;来源预测头是一个线性分类器,基于全局嵌入预测音频片段的原始录音来源,由于训练集包含 150 余万条来源录音,它通过秩为 512 的低秩投影实现高效计算,服务于自监督来源预测损失的学习。
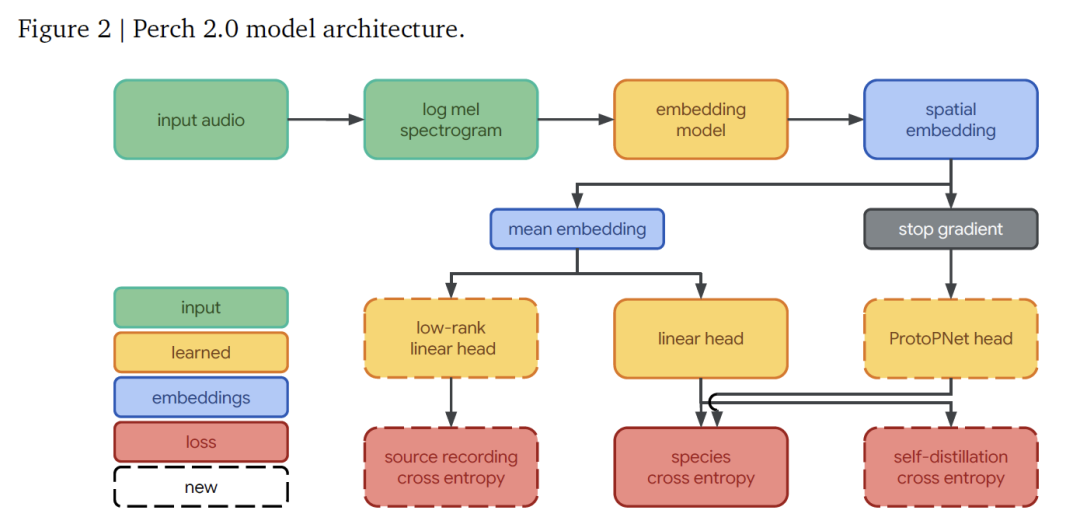
Perch 2.0 模型体系结构
模型训练通过 3 个独立目标实现端到端优化:
物种分类交叉熵针对线性分类器,采用 softmax 激活和交叉熵损失,对目标类别赋予均匀权重;
自蒸馏机制中,原型学习分类器作为「teacher」,其预测结果指导「student」线性分类器,同时通过正交损失最大化原型差异,且梯度不回传至嵌入网络;
来源预测作为自监督目标,将原始录音视为独立类别训练,推动模型捕捉显著特征。
训练分两阶段:第一阶段专注训练原型学习分类器(不启动自蒸馏,最多 300,000 步);第二阶段启动自蒸馏(最多 400,000 步),均使用 Adam 优化器。
超参数选择(Hyperparameter selection)依托 Vizier 算法,第一阶段搜索学习率、dropout 率等,经两轮筛选确定最优模型;第二阶段增加自蒸馏损失权重继续搜索,两种窗口采样方式贯穿始终。
结果显示,第一阶段偏好混合 2-5 条信号,来源预测损失权重 0.1-0.9;自蒸馏阶段倾向小学习率、少用 mixup,赋予自蒸馏损失 1.5-4.5 的高权重,这些参数支撑了模型性能。
在BirdSet和BEANS两大基准测试中,Perch 2.0均取得了 当前最佳成绩——
BirdSet(多地鸟类声学识别):无微调情况下的AUROC、cmAP、Top-1准确率全面领先;BEANS(跨类群动物声学):在迁移学习任务中优于专门的海洋模型(如SurfPerch),尽管几乎没有使用海洋训练数据。
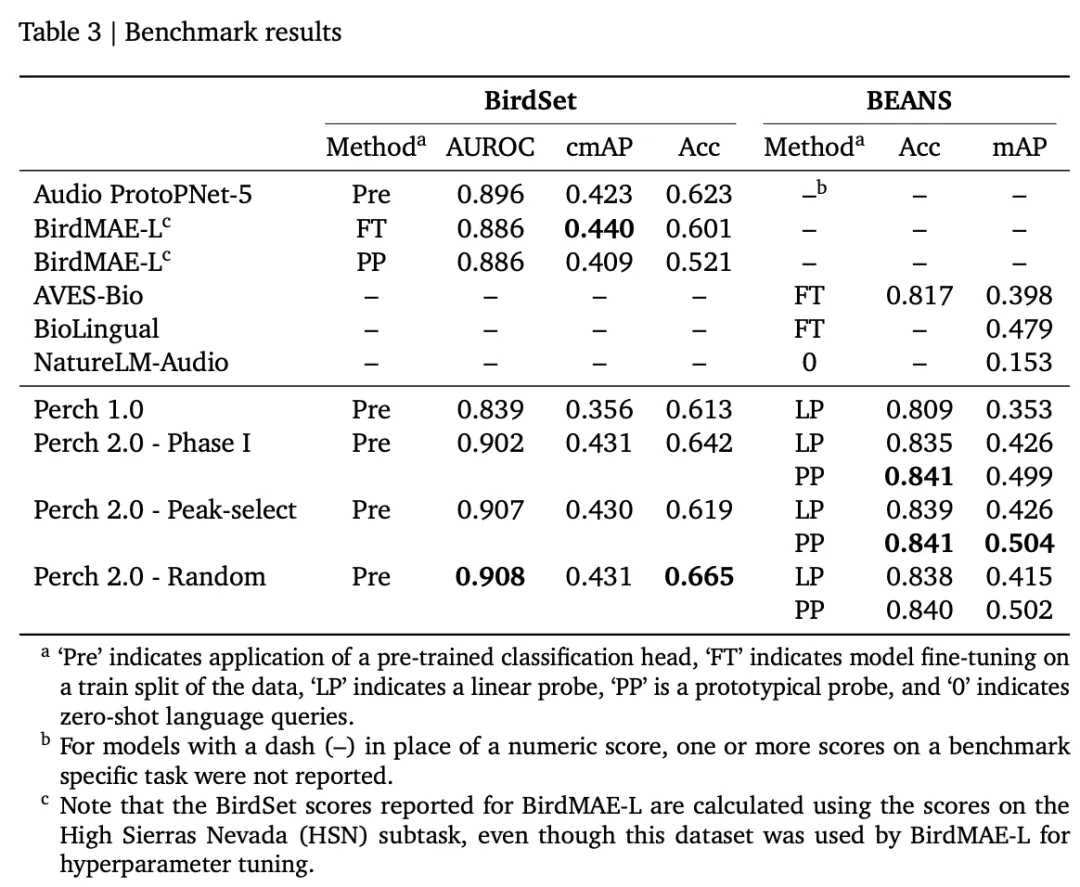
尤其在BEANS的检测任务中,Perch 2.0的原型探针(Prototypical Probe)表现显著优于单纯线性探针,表明其在复杂声景下的类别分离能力更强。
