
 语音小管家
来源丨AI音频时代
NVIDIA 在多语种语音 AI 领域迈出重要一步,正式发布了Granary 数据集和两款最新模型Canary-1b-v2与Parakeet-tdt-0.6b-v3,为欧洲语言的自动语音识别与语音翻译设立了全新基准。
在世界上大约7000种语言中,只有极小一部分得到了人工智能语言模型的支持。NVIDIA发布的Granary 数据集和两款最新模型 Canary-1b-v2 与 Parakeet-tdt-0.6b-v3或将解决这一问题。
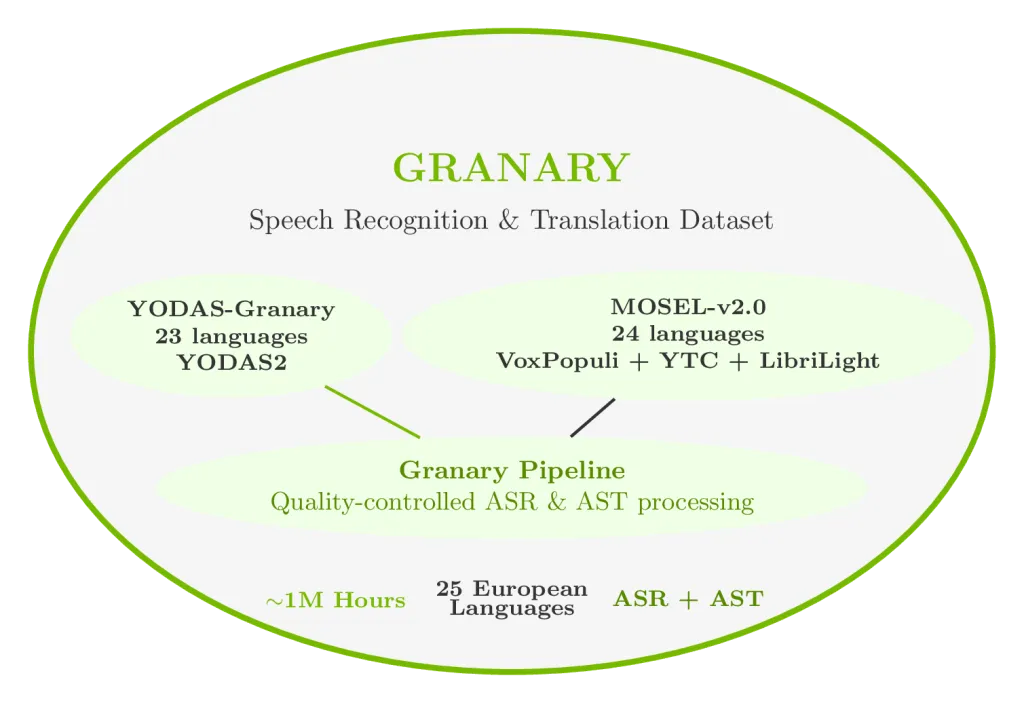
Granary 数据集由 NVIDIA 联合卡内基梅隆大学与 Bruno Kessler 基金会开发,规模达100 万小时音频(65 万用于识别,35 万用于翻译),覆盖25 种欧洲语言,包括大多数欧盟官方语言以及俄语、乌克兰语,特别强化了克罗地亚语、爱沙尼亚语、马耳他语等低资源语言。其核心优势在于:
最大规模:迄今最完整的多语种开源语音数据集; 高效处理:利用 NeMo 工具链对公共音频进行伪标注,减少人工成本; 广泛适配:同时支持 ASR 与 AST,适用于生产级模型训练; 快速收敛:同等精度仅需竞争数据集一半的训练量。
在模型层面,Canary-1b-v2具备10 亿参数,可在英语与 24 种语言间双向转录与翻译,在准确率、推理速度及多任务表现上均达到业界领先水平;而Parakeet-tdt-0.6b-v3则面向实时大规模转录,支持自动语言识别与长时音频处理,适合低延迟与高并发场景。
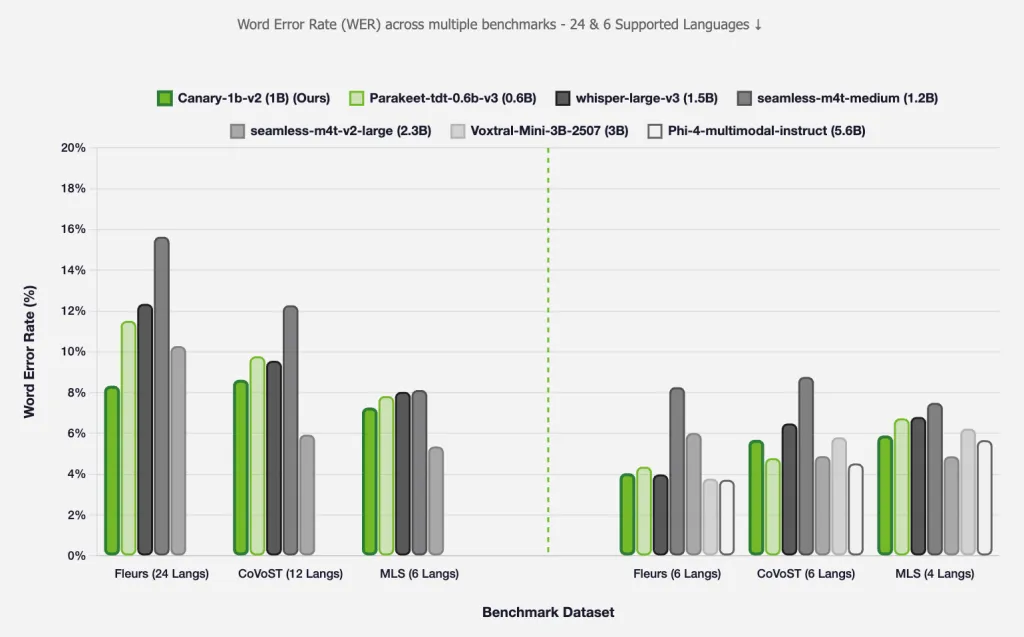
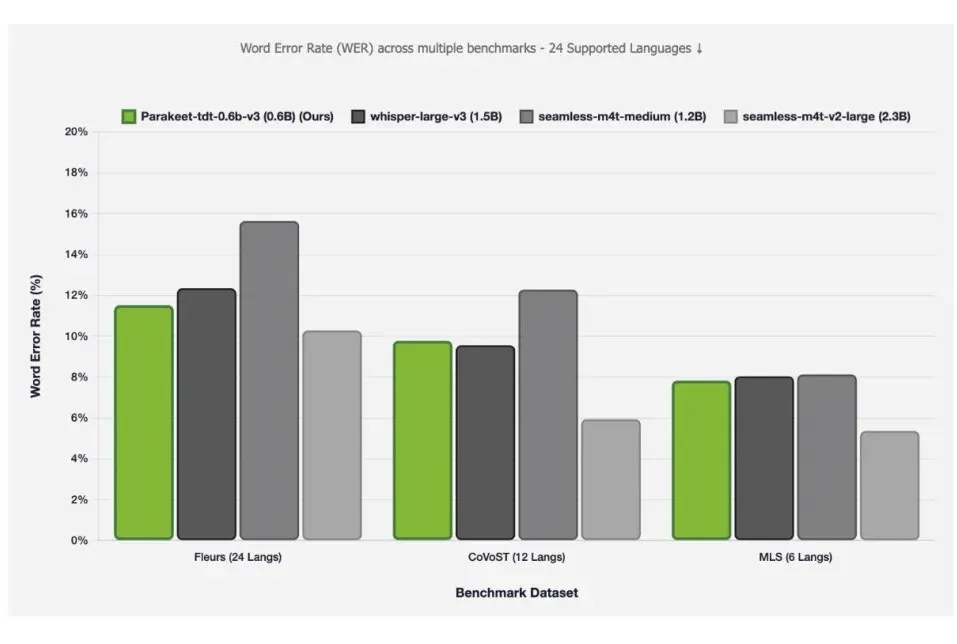
这些开源资源为开发者与企业带来显著价值:无论是多语言客服、实时翻译,还是智能语音助手,都能借助 Granary 与 Canary/Parakeet 快速构建更普惠、更精准的语音应用,推动欧洲语音 AI 的大规模落地与多样化发展。
Granary如何解决数据短缺问题
为了开发Granary数据集,NVIDIA语音人工智能团队与卡内基梅隆大学和布鲁诺凯斯勒基金会的研究人员合作。该团队通过NVIDIA NeMo Speech Data Processor工具包驱动的创新处理流程,将未标记的音频转化为结构化、高质量的数据。
这一流程使研究人员能够在无需耗费大量资源进行人工标注的情况下,将公共语音数据增强为可用于人工智能训练的格式。它已在GitHub上开源。
凭借Granary干净、即用的数据,开发人员可以提前着手构建模型,以解决欧盟24种官方语言以及俄语和乌克兰语的转录和翻译任务。
对于在人工标注数据集中代表性不足的欧洲语言,Granary提供了一个关键资源,以开发更具包容性的语音技术,更好地反映该大陆的语言多样性,同时使用更少的训练数据。
该团队在他们的Interspeech论文中证明,与其他流行数据集相比,使用Granary训练数据达到自动语音识别(ASR)和自动语音翻译(AST)的目标准确率水平,所需的训练数据量大约减少了一半。
利用NVIDIA NeMo进行加速转录
新的Canary和Parakeet模型提供了开发人员可以使用Granary构建的模型的示例,这些模型可以根据他们的目标应用程序进行定制。Canary-1b-v2针对复杂任务的准确性进行了优化,而Parakeet-tdt-0.6b-v3则针对高速、低延迟的任务进行了设计。
通过共享Granary数据集和这两个模型背后的方法,NVIDIA使全球语音AI开发人员社区能够将此数据处理工作流程适应其他ASR或AST模型或其他语言,从而加速语音AI创新。
Canary-1b-v2在许可证下可用,将Canary家族支持的语言从4种扩展到25种。它提供了与3倍大的模型相当的转录和翻译质量,同时运行推理的速度提高了10倍。
NVIDIA NeMo是一个用于管理AI代理生命周期的模块化软件套件,加速了语音AI模型的开发。NeMo Curator是软件套件的一部分,它使团队能够从源数据中过滤出合成样本,从而只使用高质量的样本进行模型训练。该团队还利用NeMo语音数据处理器工具包完成了将成绩单与音频文件对齐以及将数据转换为所需格式等任务。
Parakeet-tdt-0.6b-v3优先考虑高吞吐量,能够在一次推理过程中转录24分钟的音频片段。该模型自动检测输入的音频语言并转录,而无需额外的提示步骤。
Canary和Parakeet模型在输出中都提供了准确的标点符号、大写字母和单词级时间戳。
参考:
https://huggingface.co/datasets/nvidia/Granary
https://huggingface.co/nvidia/canary-1b-v2
