
 语音小管家
来源丨AI理想同学
近日,理想同学发布了基座模型 MindGPT 3.1 ,是具备极速推理能力的智能体语言模型。
MindGPT 3.1 具备如下能力:
极速响应:每秒出字速度最高可达 200 Tokens,相比上一代模型 MindGPT 3.0 提升近 5 倍;
深度推理:基于自研的强化学习算法 ASPO(Adaptive Sampling Policy Optimization),MindGPT 3.1 在推理能力上实现了显著跃升,在数学、代码以及通用能力等多项基准测试中;
智能体语言模型:MindGPT 3.1 从推理大模型升级为智能体语言模型,具备自主思考并调用工具的能力,在工具调用准确率、复杂任务完成率、深度搜索、回复丰富度等评估指标上显著增强;
App:https://www.lixiang.com/download/livis?chjchannelcode=102066
一、模型能力
1.1 通用能力评估
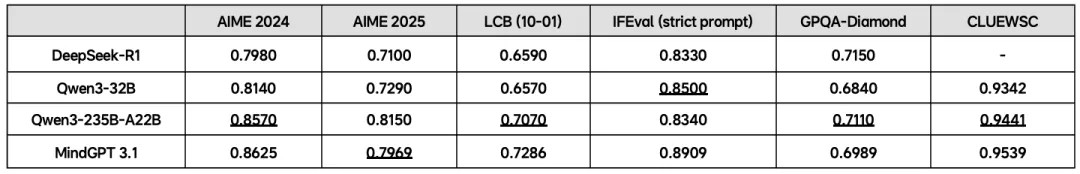
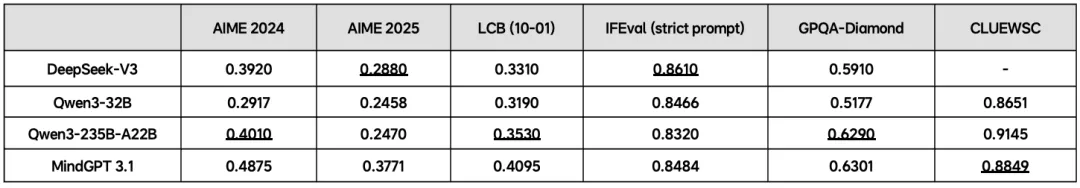
我们对 MindGPT 3.1 深度思考/非深度思考模式的通用能力进行了全面的评估,涵盖数学、编码、科学问答、指令遵循等多个基准测试,主要对标 Qwen3 系列模型,具体评估结果如下:
深度思考模式:
非深度思考模式:
注:
1) AIME 2024 评估模型在高中奥数级别数学题的解题能力,强调数学推理,属于复杂数学问题;
2) AIME 2025 是基于2025美国数学邀请赛真题构建的AI数学推理能力评测基准;
3) LCB(10-01) 评估大模型在代码处理方面的能力,时间段设置在2024年10月到2025年1月;
4) IFEval 是一个专门用于评估大模型指令跟随能力的基准数据集,我们选用strict prompt来评估;
5) GPQA-Diamond 评估模型解决高级物理问题的能力,考查科学推理和事实准确性;
6) CLUEWSC 评估模型对中文语义的深度理解能力,尤其是处理代词指代歧义的逻辑推理能力;
7) 对所有指标均进行 64 次评估,并取其平均值作为最终结果。
1.2 智能体业务评估
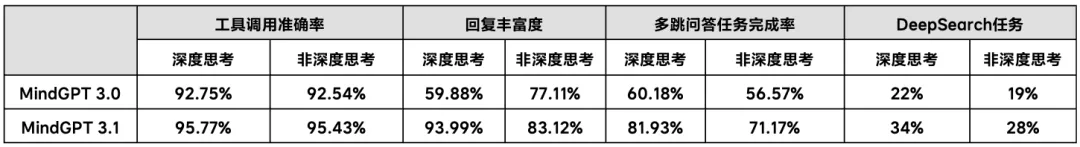
我们对 MindGPT 3.1 在业务测试集上的表现做了系统评估,包括工具调用准确率、回复内容丰富度、多跳问答任务完成率以及 DeepSearch 任务完成率维,评估结果显示 MindGPT 3.1 在上述指标上均表现出更优性能。
二、算法方案
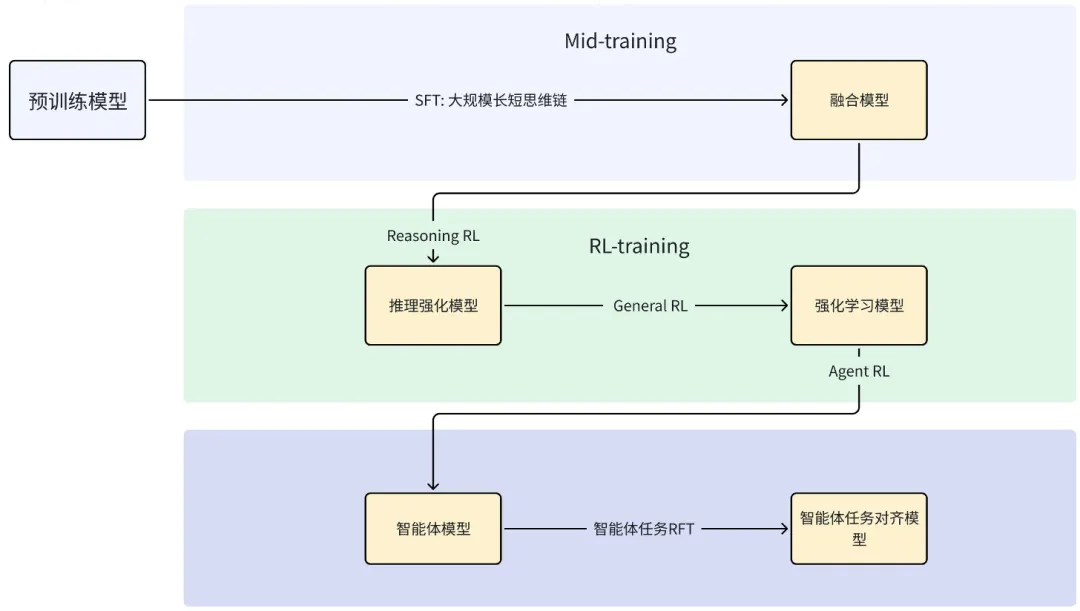
基于 MindGPT 预训练模型,MindGPT 3.1 重点聚焦基于强化学习的后训练技术,共分为三个阶段:
中期训练(Mid-training):大规模长短(多轮)轨迹数据进行行为模式注入,使模型具备初步的推理能力与智能体能力;
强化学习(RL,Reinforcement Learning):多阶段的强化学习训练,包括推理RL、通用RL、智能体RL,进一步提升模型能力;
强化微调(RFT,Reinforcement Fine-Tuning):搜索问答等场景的智能体 RFT,提升模型在智能体任务中的表现。
2.1 中期训练
在基座模型中使用大规模的长短(多轮)轨迹数据来注入大量的行为模式。然而在训练过程中,观察到大多数token的预测概率较高,而少部分token的预测概率极低。这些低概率token通常代表与模型当前分布显著偏离的特征。在传统训练过程中,所有token通常被赋予相同的梯度权重,这容易带来以下问题:
核心知识巩固受干扰:低概率token在反向传播时产生过大的梯度波动;
训练不稳定:极端离群样本导致梯度震荡,影响收敛;
样本利用率低:模型在当前阶段难以有效学习的样本上浪费更新机会。
针对上述问题,提出了自适应权重估计算法(AWE,Adaptive Weighting Estimation)。该方法在训练过程中,根据模型当前的预测概率,动态调整每个token在损失计算中的权重:
对于极低预测概率、当前阶段难以有效学习的token,降低其损失权重,以减少其对梯度更新的干扰;
将训练重心放在预测概率适中、可稳定提升的token上;
随训练进程逐步扩大关注范围,使模型在稳定收敛的同时增强对难样本的适应能力。权重的计算基于当前批次(batch)中模型对每个token的预测概率分布。权重分布会随训练阶段自动调整,实现从“先学易样本”到“逐步攻克难样本”的过程。
最后,在多领域长短(多轮)行为轨迹数据集的中期训练实验中,引入自适应权重估计算法后,模型表现出:
更少的数据量:在训练数据使用量减少的情况下,性能可达到或超过全量训练;
更高的稳定性:训练曲线更平滑,梯度方差显著降低;
更高的样本利用率:高质量样本在训练中的有效利用比例显著提升。
这些结果表明,在存在长尾预测分布的场景下,自适应权重估计可以显著提升中期训练的优化效率和泛化能力。
2.2 强化学习
按照三个递进阶段进行强化学习:推理能力强化 → 通用能力强化 → 智能体能力强化,逐步提升模型的深度推理能力、跨领域泛化能力和多轮任务交互能力。强化学习整个过程,使用了自适应采样策略优化算法:(ASPO,Adaptive Sampling Policy Optimization),用于提升强化训练效率的同时提升训练稳定性。
自适应采样策略优化算法
传统强化学习在大模型训练中存在以下三个问题:
数据难度与模型能力不匹配 :在不同规模和训练阶段,模型对任务难度的感知不同,如果训练样本难度过高或过低,都会降低训练效率;
数据采样不够精准:当模型对部分样本已经完全掌握(全对)或无法学习(全错)时,继续训练将浪费计算资源;
探索与利用的窗口长度固定:无法随着训练状态动态调整,导致收敛效率与性能受限。
我们提出自适应采样策略优化算法ASPO,其主要包括如下方法:
自适应训练数据舒适度:考虑模型在不同后训练阶段的能力差异,我们通过多次推理对样本难度进行预估(推理 10 次中答对 ≥ 3 次的样本作为初始训练集),并在强化学习过程中持续筛选与当前模型能力水平匹配的样本;
自适应采样策略:随着训练进入平稳期,模型在部分样本上会出现“全对”或“全错”模式。为了提升训练速率,我们将“全对”样本从训练池中移除,只保留预测准确率 20% ~ 80% 的样本进行梯度更新,以集中资源提升模型在中等难度样本上的学习效率;
学习阶段感知的探索窗口:为了在探索与利用之间取得最优平衡,我们将原有的自适应窗口长度升级为动态窗口空间优化。该机制将模型的学习状态(如奖励的增长率、策略熵的变化)与窗口长度进行耦合,在模型遭遇性能瓶颈时,系统会倾向于采用较长的窗口,当模型进入稳定收敛阶段时,则自动切换至较短的窗口:
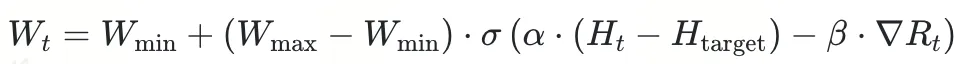
三阶段强化训练
阶段一:推理能力强化
数据与奖励模型:使用覆盖多个领域和多阶段难度的推理类数据集,包括数学、代码、逻辑推理及科学问答,总量约 3 万条查询-验证对,其中所用的奖励机制均为规则奖励模型(Rule-based Reward),人工质检一致性大于等于95%。
训练设置:策略展开次数(rollout 数)设为 32,训练总步数 2000 步;训练过程中应用自适应采样策略优化算法(ASPO),动态调整数据与探索策略,以匹配模型当前能力状态,并提升中难度任务的学习效率。
在 AIME 2024 推理基准测试 中,使用 ASPO 的模型达到了 85.83 分,相比GRPO有显著提升。
阶段二:通用能力强化
在该阶段为了全面对齐各领域能力,我们设计了多维度、自适应的通用能力强化训练范式
数据与奖励模型:覆盖指令遵循、通用问答、事实性问答、多语言能力等域,每领域约1万条数据,奖励包括奖励模型涉及三类,分别为大语言模型评判的奖励模型(LLM-as-a-Judge)、奖励模型(Reward)、规则奖励模型(Rule-based Reward)。
训练设置:我们设置了不同领域数据按比例混合训练,共训练1000个训练步,有效避免了顺序训练造成的领域遗忘问题,如下表所示,混合训练相比顺序训练在各域均有提升。
阶段三:智能体能力强化
在复杂应用场景中,智能体需要具备在长对话、多上下文环境中多轮调用外部工具的能力。尽管在中期训练中我们已经注入了大量的行为数据,但是面对真实的环境,以及在超长多轮上,模型仍然受到限制,因此我们在该阶段引入了智能体强化。
数据与奖励模型:覆盖常见的四种类型任务,包括车辆控制、自动交易、旅行预定和文件操作,涉及到 8 类 API(工具)系统,共计129 种工具,为了提升多轮性能,我们构建了基于环境反馈的奖励机制。
训练设置:为了更好地引导复杂多轮的能力,该阶段我们引入了课程学习训练策略,从单轮调用(短上下文,任务独立)到多轮调用(长上下文,含历史记录与环境反馈,语义前后关联)。
最后我们的工具调用能力的准确率从 92.75% 提升到 95.77%,多轮任务完成率显著提高。
2.3 强化微调
我们基于智能体模型的工具调用能力,针对理想同学的业务场景进行了智能体任务强化微调训练,兼具了任务型工具和问答型工具的自主调用能力。在产品形态上,将模型的深度思考能力进行了升级,将推理思维链和工具调用深入融合,模型在推理过程中边想边调用工具。整体训练过程分为三个阶段,具体为:
SFT 阶段:
我们使用业务领域高质量训练集对模型进行了大规模监督微调(SFT,Supervised Fine-Tuning),训练过程中采用 32k Token 的长上下文窗口配置,以最大化保留和利用跨文档、跨会话的长程依赖信息。
得益于这一策略,模型在工具调用的推理链路、上下文管理及多步骤任务编排等能力上获得了显著增强,能够高精度适配业务场景的复杂需求。同时,长序列优化不仅提升了模型在大规模知识检索、信息聚合与推理方面的表现,还显著强化了其在复杂任务下的工具调用的泛化能力。
思维链混合训练阶段:
在 MindGPT 3.0 版本中,我们首创性地引入了基于 Markdown 格式的结构化思维链(SCoT,Structured Chain-of-Thought) 技术,实现了推理过程的高可读性与逻辑可追溯性,为用户带来了更清晰的逻辑呈现、更凝练的内容表达与更可信的交互体验。
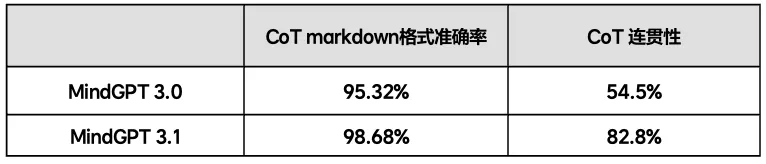
然而,在 3.0 版本中仍存在思维链不够连贯、表达冗余,以及结构化格式准确率不足等问题。因此,在 MindGPT 3.1 版本中继续保留且升级了结构化思维链的特性,通过引入推理节点精确标注、层级化语义抽象与冗余链路自适应裁剪等技术,结构化思维链的整体表达更加简洁流畅、语义层次分明,逻辑跳转更加顺滑自然,CoT 结构化准确率相较于 MindGPT 3.0 提升 3.36 个百分点,CoT 连贯性相较于 MindGPT 3.0 提升 28.3 个百分点。
DPO 强化阶段:
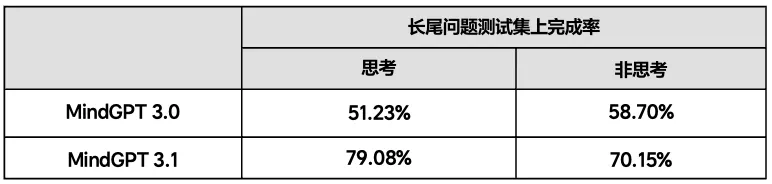
在该阶段,我们聚焦于业务指标的精准优化与鲁棒性增强,对模型输出进行针对性的优化,使模型的输出更符合人类偏好和价值观对齐。我们采用拒绝采样(Rejection Sampling)结合直接偏好优化(DPO,Direct Preference Optimization)的强化学习策略,我们累计生成并严格筛选构建了约 2 万条高质量 DPO 样本,覆盖了核心业务场景与长尾问题域。实验结果表明,经过 DPO 训练阶段后,长尾问题测试集上完成率在思考和非思考模式下均有显著提升。
2.4 数据能力
中期训练 & 强化学习
数据管线
我们构建了两套数据管线,分别用于:
中期训练和多阶段强化学习(推理能力强化及通用能力强化共两个阶段);
多阶段强化学习(智能体强化阶段);
在中期训练和多阶段强化学习(推理能力强化及通用能力强化共两个阶段)中,模型性能高度依赖高质量、覆盖全面且多样化的数据。为此我们搭建了一套高效率、可扩展且难度可控的数据体系,结合多源异构数据的采集与精细化处理,确保在各训练阶段为模型持续提供数量充足、质量可靠和丰富多样的数据支撑,从而形成从数据到能力的闭环提升。
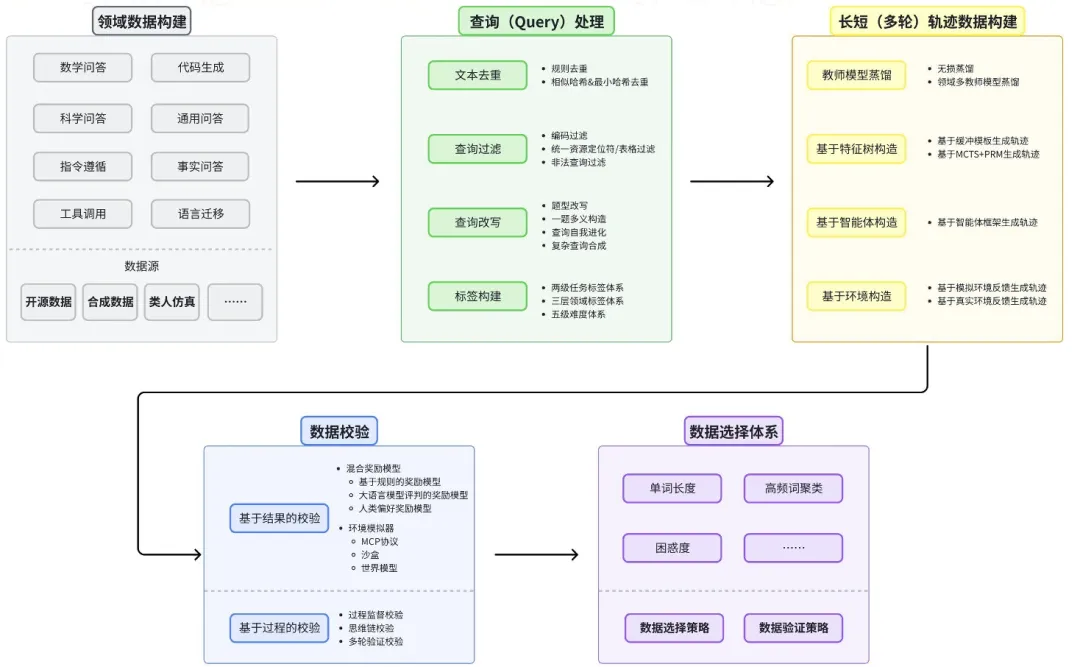
如上图所示,构建了一条服务于中期训练和强化学习的大规模、体系化数据管线,分为以下五个核心步骤:
领域数据构建:从开源数据、合成数据、类人仿真等多个异构数据源广泛获取多领域数据集构造数据池,并将其规范化、格式化处理入库;
查询(Query)处理:针对不同领域的查询进行清洗与处理,包括文本去重、查询过滤、查询改写以及查询的标签体系构建;
长短(多轮)轨迹数据构建:我们使用多种方式构造长短思维链数据,包括基于教师模型蒸馏、基于特征树构造的方式。尤其是在针对智能体(Agent)任务,我们采取多智能体交互、基于环境反馈等方式,构建智能体多轮交互轨迹数据;
数据校验:我们从两个维度对生成数据进行校验,一个是基于结果的校验,通过检验回复结果判断数据的正确性;另一个是基于过程的校验,通过过滤错误中间路径来保证数据的有效性;
数据选择体系:为了获取利于模型训练的高效数据配比,我们提供了丰富的数据选择体系,例如根据基于单词(token)长度、困惑度(Perplexity)、高频词聚类,以及自研数据选择策略算法等。
在多阶段强化学习的智能体强化阶段,我们基于模拟环境完成智能体数据管线建设,以模拟环境的多轮工具调用数据建设为例:
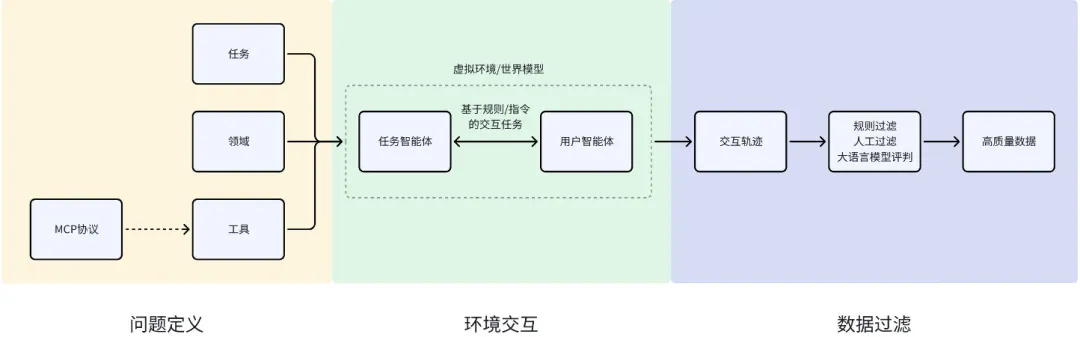
整体流程如上图所示,整体流程分为以下五步:
任务设计:设计了四种常见的智能体的任务,包括车辆控制、自动交易、旅行预定和文件操作,涉及到 8 类API系统,共129 种工具;
环境搭建:使用 Python 类设计了四种仿真模拟环境,在模型进入时初始化实例,通过类的属性模拟实例的状态,在执行函数调用时,通过修改类的属性以更新实例的状态,以实现函数的模拟调用与虚拟环境的交互;
交互设计:基于任务特性设计了基于规则/指令的交互模式,在模型进入时提供环境信息、任务规则、工具列表及各项工具细节,包括函数名、函数描述、参数类别、参数信息等,供模型参考调用;
数据生产:使用多种模型作为任务智能体进入模拟环境与用户智能体进行交互,获得具有多样性的交互轨迹;
数据过滤:获得交互轨迹后,采取基于结果监督 (ORM) 和过程监督 (PRM) 的方式,结合规则过滤、人工过滤、大语言模型评判(LLM-as-Judge)的方式,获得高质量交互数据。
该数据管线体系经过多源采集、精细化构建与多维度验证,充分保证了训练样本的有效性与多样性,为模型在中期训练和强化学习中性能的持续提升提供了坚实的数据基础。依托难度可控、覆盖领域广的数据特性,模型在推理能力、跨领域泛化能力以及多轮交互能力方面均表现出显著增强。特别地,在智能体强化阶段,基于模拟环境构建的多轮工具调用数据有效提升了模型在多工具协同调用和长上下文任务处理中的准确率与稳定性,为面向真实应用的高阶智能体系统奠定了坚实基础。
智能体强化微调
在智能体强化微调阶段,我们构建并完善了一条高质量的数据管线,以保障训练样本的完整性与有效性。整体数据合成流程如下:
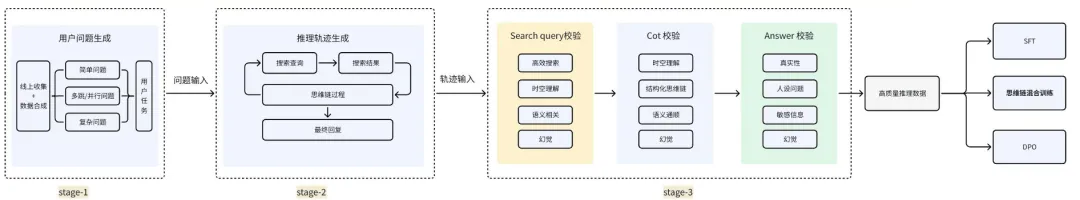
第一阶段为用户问题合成。为增强智能体模型在复杂问题上的推理能力,我们引入课程学习策略,将用户问题按难度划分为三个层级:
Level-1:简单直接的用户问题,通常可以通过模型内部知识或调用单一工具即可回答的问题,比如“2024年诺贝尔文学奖获得者有哪些作品?”
Level-2:主要为多跳和并行问题,问题通常可以拆解为多个子问题,并具有明确的解答路径。比如“尼米兹级航母第一艘下水到最后一艘下水期间,在任的美国总统有海军服役经历的平均服役时间是多少?”;
Level-3:拆解路径高度不确定、复杂度极高的用户问题,此类问题缺乏既定推理范式与标准化解决框架,需要模型自主构建思路与策略。比如“某 90 后女演员,不是独生子女,在山西长大,其毕业大学的校友是余秋雨,从 12 岁就开始演戏并被大众熟知。曾获得电影节新人奖,戏剧表演艺术家新人主角奖提名。她所属的经纪公司是哪里?”
第二阶段为推理轨迹生成。完整的推理轨迹由多轮思维链(CoT)过程、搜索查询(query)以及最终回复结果构成。我们基于专家模型采用数据合成的方法,构建了完整的用户问题 CoT 推理流程。然而,直接依赖数据合成生成推理轨迹仍存在一定局限性,例如搜索查询的效率与准确性不足,以及推理轨迹与最终回复质量存在偏差等问题。
第三阶段为数据校验。为获取高质量的推理轨迹,我们构建了严格的多维度校验机制,对完整推理轨迹进行逐层筛选与验证。该机制涵盖搜索查询校验、思维链(CoT)过程校验以及回复质量校验,从多维度保障生成轨迹的可靠性与高质量:
Search query 校验:聚焦搜索查询语句的准确性与合理性,具体包含:
搜索查询与历史步骤消息是否存在脱节、逻辑模糊的情况;
搜索查询的描述是否清晰、信息是否明确;
搜索查询是否简洁高效、无冗余内容;
搜索查询中涉及的时间和位置信息是否合理。
CoT 检验:围绕思考过程的规范性与逻辑性展开,具体包括:
CoT 过程的语义是否通顺、逻辑是否清晰;
CoT 过程是否存在重复(重复对历史步骤问题进行思考);
CoT 过程中是否出现前后矛盾的情况;
CoT 过程是否存在幻觉式思考(即无依据的虚构内容);
CoT 过程规则化校验(不能出现“放弃查询”、“我需要假设”等表述)。
Answer 检验:从多维度验证回复内容的质量,具体包括:
模型回复的内容与检索资料中已知、可靠的数据或信息源相符;
模型回复需逻辑连贯,无逻辑谬误或不合理推断;
模型回复内容需为最新信息,且符合用户对时效性的需求;
模型回复需通过规则校验,包括人设校验(模型是否存在不当的自我认知)、n-gram 重复校验、序号错乱校验、markdown 表格结构校验。
三、工程能力
3.1 强化学习训练
MindGPT 3.1 强化学习训练链路涉及传统训练、推理采样、奖励计算和外部工具调用等多个模块,其复杂流程使得强化学习训练任务通常存在诸多效率挑战。为此,我们在自研强化学习训练框架 LiPTM-RL 中,对 Rollout 模块、训练后端模块、Reward 模块分别进行了针对性优化提效,以高效、稳定的支持 MindGPT-3.1 强化学习训练任务。
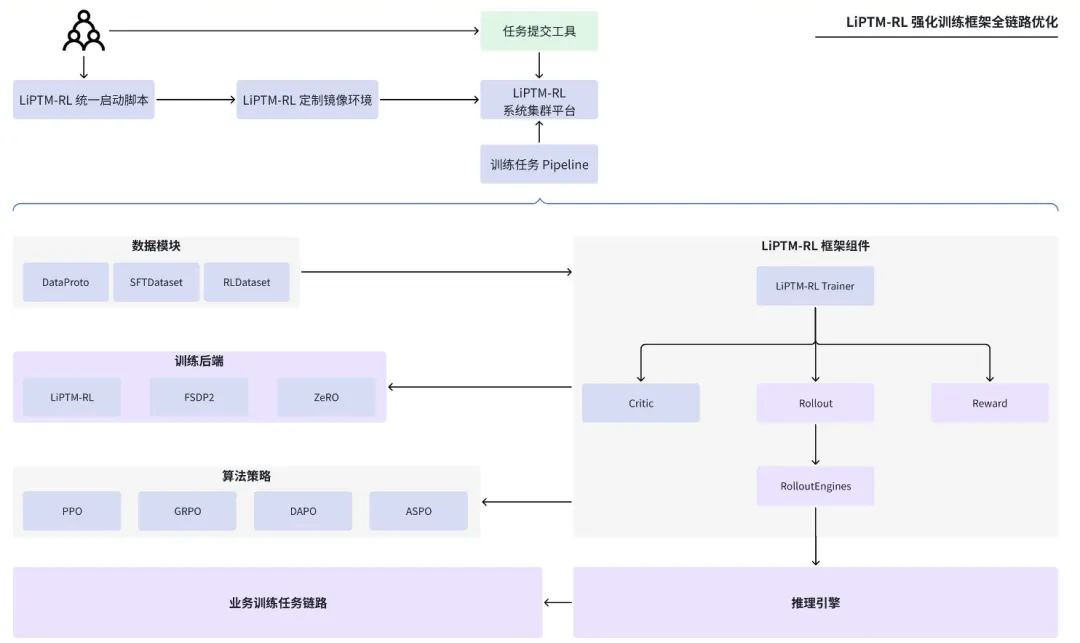
Rollout 和训练后端模块优化:
我们引入并实施了 FP8 混合精度强化学习训练推理加速方案,以及研发了基于 Rollout 结果的冗余检测与截断机制。其中,FP8 混合精度技术在 Research 类任务上实现了 23% 的显著加速。另一方面,冗余检测及截断机制有效提升了逻辑推理任务的生成效率,单 token 生成速度加快 21.7%,推理阶段整体速度提升 14.2%,训练整体 TFLOPs 提高 17.1%。该机制同时缓解了因 repetition_penalty 参数设置过高导致的异常输出问题,进一步增强了模型的训练稳定性和有效性。
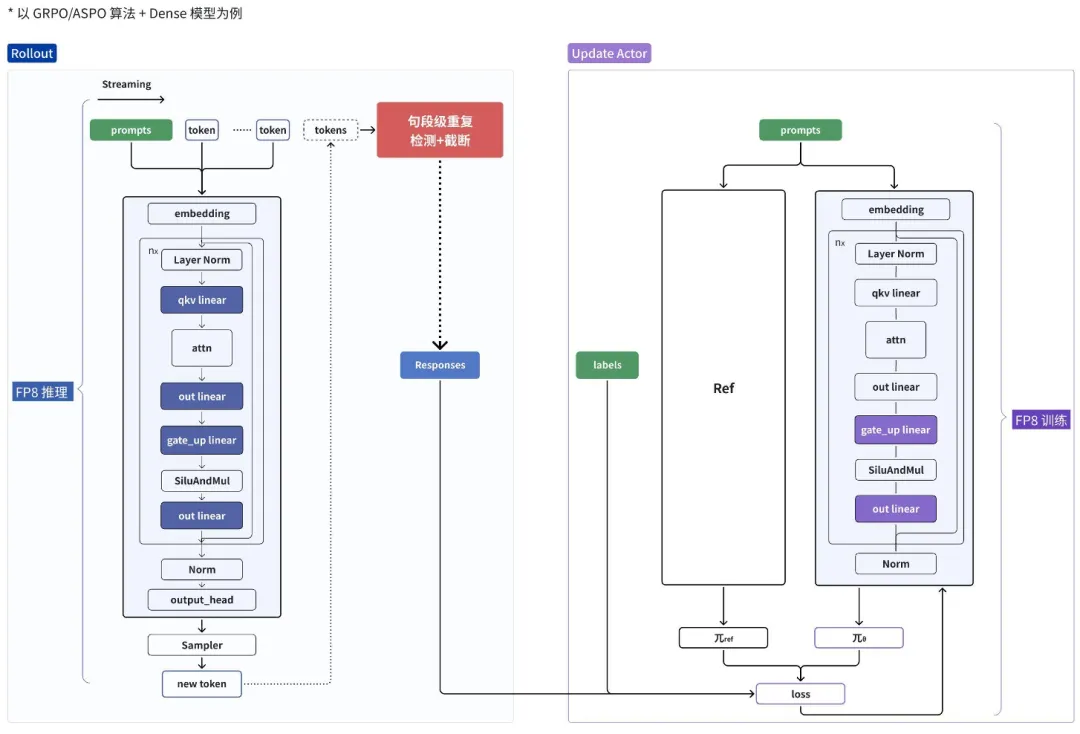
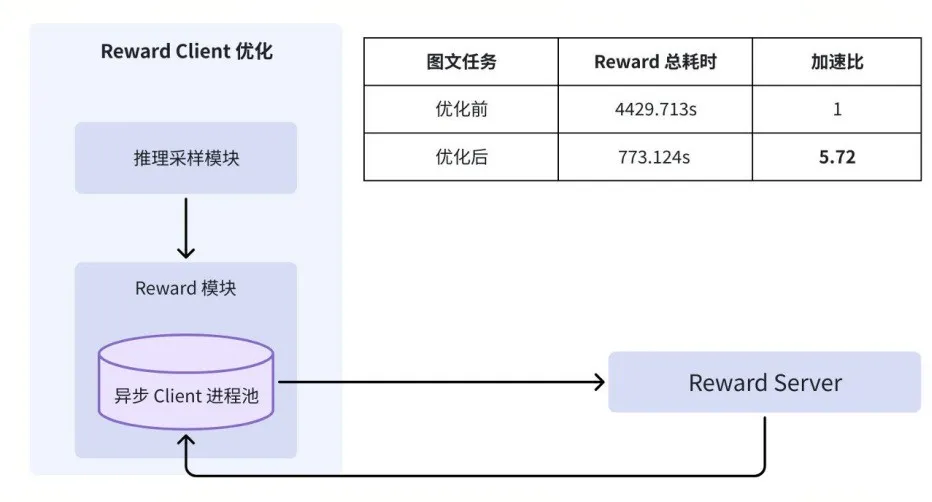
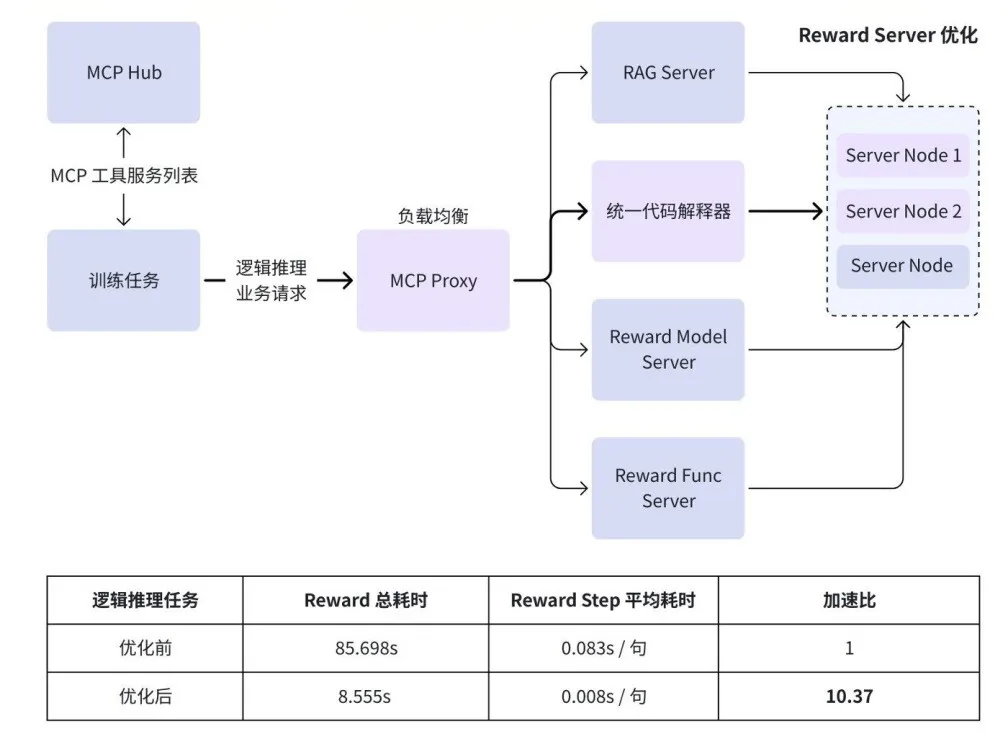
Reward 模块优化:Reward Step 定向细粒度优化
Client:通过实施客户端异步及并发优化,我们成功实现了 Reward 模块的全方位加速。其中,图文任务效能提升尤为显著,加速比达到5.72。
Server:通过对 RL 训练链路中的 Reward Server 实施模块化解耦、针对性优化与集群化部署,我们充分发挥了分布式架构的效率优势,显著提升了奖励值计算的整体效能。此项改进成效显著,尤其在逻辑推理任务中,统一代码 Reward 模块的加速比达到了 10.37。
3.2 推理能力
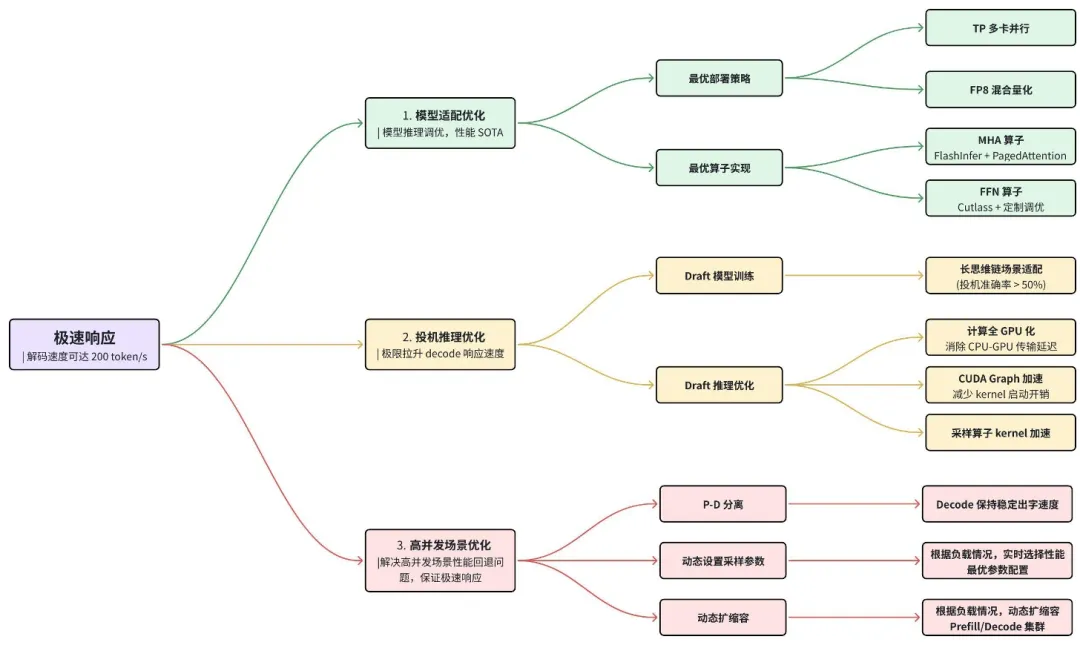
为了让用户享受快速高效获取答案的极速体验,我们在模型适配、投机推理、高并发场景适配等层面对 MindGPT 3.1 的推理引擎进行了深度优化。推理服务出字速度最高可达 200 Tokens/s,相比 MindGPT 3.0 提升近 5 倍,响应速度显著领先行业,整体分层优化架构如下图:
模型适配优化
部署方案:采用 FP8 + TP 并行的方案进行推理,来充分释放多卡的计算能力,最大化地提升响应速度;
模型量化:实现了 tensor-wise、block-wise、token-wise 等多种量化方法,按算子级别选择量化策略,通过混合量化方案达到性能和效果的最优;
算子优化:采用业界先进的 FlashInfer + PagedAttention 方案实现 MHA 算子,采用 Cutlass + 定制调优方案实现 FFN 算子,结合 FP8 + TP 并行,性能可达到 SOTA 水平。
投机推理优化
Draft 模型训练:面向长思维链场景进行模型训练的适配,投机接收率可以稳定保持在 50% 以上,解码步数降低 70%,大大节省了生成时间;
Draft 推理加速:通过下列优化操作,可以将 Decode 单步解码的延迟优化到 20 ms,较原始版本降低 50%
计算过程全 GPU 化,消除 CPU-GPU 的传输延迟;
CUDA Graph 加速,减少 CUDA kernel 启动开销;
投机采样 kernel 加速。
高并发场景优化
P-D 分离:针对长输入/输出的场景,我们沿用了 MindGPT 3.0 P-D 分离的部署方案,保证 Prefill 和 Decode 延迟互不影响,高并发场景 Decode 阶段可以保持稳定的出字速度;
动态配置采样参数:在高并发的生产场景,投机推理性能回退明显;我们实现了动态调整投机采样参数的机制,根据服务负载压力动态设置投机长度、候选个数等采样参数,实时选择性能最优的配置策略;
动态扩缩容:推理服务可根据流量特征弹性扩缩容,动态调整 Prefill 和 Decode 集群的数量,使得线上服务可以保持最优的 P-D 配比,用最低的部署成本保证用户的极速体验。
四、模型安全
MindGPT致力于实现契合通用价值观、中国普适价值观及理想同学自身价值观的大语言模型,为此设计了完备的大模型安全体系与安全对齐技术框架。我们根据基座模型的风险浓度,将外层防御能力(MindGuard)和大模型内生安全能力深度融合,在保障 MindGPT 高可用性同时,确保生成内容的安全可控。
MindGuard 识别输入问题的风险领域和风险浓度。针对涉政敏感和低俗内容等高危问题,会采用拒绝响应有害内容;在低风险场景中,则更多采用经过安全对齐的 MindGPT 3.1 的生成结果;在保证安全可控的前提下,较 MindGPT 3.0 对话打扰率降低 60%,多轮对话的回复的相关性和有用性提升 50%。
为挖掘MindGPT3.1的潜在风险,提升安全体系完备性,我们与公司内部专业红队(Red Team)合作,收集更多未知风险和长尾风险。同时开展自动化、持续性攻击,助力完善安全体系的风险覆盖。收集到风险 query 进入安全数据管线:数据清洗去重、业务专家打标等,为安全对齐提供数据支撑。
MindGPT 3.1 安全对齐分为中期训练和强化学习训练。在强化学习训练中,针对安全场景训练安全奖励模型,由于正负样本极不均衡,我们更关注奖励模型对不安全回复的识别能力;经过实验,我们发现设置不同的回复长度和KL散度系数对于通用指标影响差异较大。我们构建了风险 query 生成器-MindGPT 3.1-风险判别器链路,自动识别模型风险回复,并将 query 和回复收集用于安全强化训练,有利于降低人工标注数据依赖,提升对齐效率。
