
 语音小管家
歌曲生成的核心是基于各种提示生成可控的高质量歌曲。然而,现有方法难以生成具有提示控制的人声和伴奏,且不能实现两者间很好的对齐。此外,它们在支持多种歌曲相关的任务方面,如歌声风格迁移,人声配伴奏,也存在不足。
为解决这些挑战,来自浙江大学的学者提出了VersBand,这是一个多任务歌曲生成框架,用于生成具有提示控制的高质量、对齐的歌曲。可以对歌词、乐谱、人声、伴奏解耦生成,利用各自的特性实现更高质量和更高控制性的生成,并实现良好的对齐。
尽管在歌声生成和音乐生成都取得了显著进展,但生成高质量、可控制且对齐的歌曲仍然面临挑战。歌曲生成旨在实现可控制的音乐体验,其应用范围广泛,从娱乐视频到专业创作均可涵盖。如图1所示,歌曲生成模型可以利用不同的提示来完成多种任务。文本提示能够实现对任务、歌词、旋律、演唱风格(如演唱方式、情感和技巧)以及音乐风格(如流派、基调与乐器编排)的控制,而音频提示则允许用户输入自己的声音或喜爱的音乐进行个性化定制。然而,现有的少数歌曲生成模型缺乏使人声与伴奏恰当对齐的机制,也无法实现有效的控制。
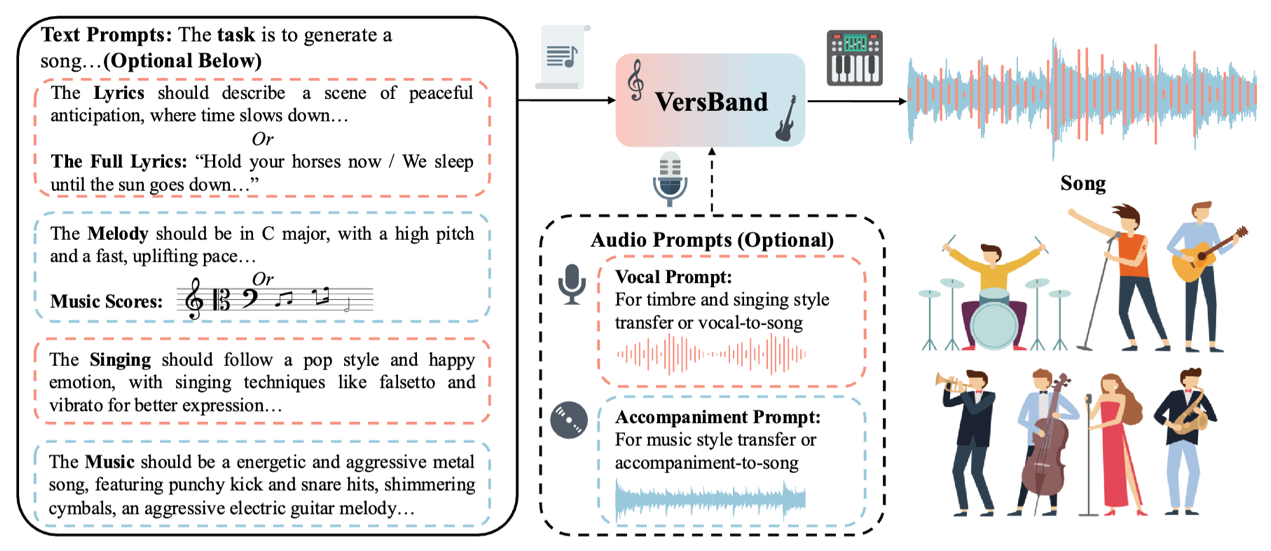
图1:VersBand 概述,它能像一个多才多艺的乐队一样生成完整的歌曲。虚线表示可选输入。用户至少可以只输入 “任务是生成一首歌曲。”
目前,歌曲生成面临三大挑战:1)具有风格控制的高质量人声生成存在局限性。现有模型尚未能通过文本提示生成具有高级风格控制(如演唱方法、情感和技巧)的悦耳人声,也无法通过音频提示进行定制。2)可控且对齐的伴奏生成存在困难。现有的音乐生成模型和文本到歌曲模型缺乏风格控制机制,以及使人声与伴奏在节奏、旋律和节拍上对齐的机制。生成可控(如流派、音调、乐器)且对齐的伴奏仍然具有挑战性。3) 基于各种提示的多任务歌曲生成面临挑战。现有的有限歌曲生成方法不支持多样化的相关任务。这种对受限输入的依赖导致用户体验欠佳,并限制了模型定制歌曲的能力。
为了应对这些挑战,我们提出了VersBand,这是一个多任务歌曲生成框架,用于生成高质量、对齐的歌曲,并具备基于提示的控制能力。基于伴奏通过复杂的和声与节奏结构来补充人声旋律这一认知,我们对它们进行单独生成。为了实现具有可控性的快速且高质量的人声生成,我们设计了一个解耦模型VocalBand,它基于流匹配方法来预测演唱风格、音高和梅尔频谱图。鉴于音乐的复杂性,我们引入了一个基于流的 transformer 模型 AccompBand,用于生成高保真、可控且对齐的伴奏。我们设计了 Band-MOE,通过选择合适的专家来提升质量、对齐度和可控性。此外,我们还添加了两个生成模型,即用于歌词生成的 LyricBand 和用于旋律生成的 MelodyBand,它们共同构成了这个全面的多任务歌曲生成系统。我们的实验表明,VersBand 能够生成具有可控性的高质量歌曲,在多个相关的歌曲生成任务中表现优于其他基线模型。
我们设计如图2(a)所示,VersBand 基于文本和音频提示处理多任务歌曲生成。我们设计了两个不同的模型,分别是用于人声的 VocalBand 和用于伴奏的 AccompBand,它们均针对各自的独特特点进行了定制。首先,我们使用文本编码器生成文本标记。当未提供歌词或乐谱时,LyricBand 和 MelodyBand 会预测音素和音符(音高和时长)作为目标内容。接下来,在图2(b)中,为了实现具有精细控制的快速且高质量的人声生成,我们引入了 VocalBand,它将内容、音色和风格进行解耦。通过基于流的音高预测器、梅尔解码器和预训练声码器,生成目标人声。然后,在图2(c)中,针对伴奏的复杂性,我们设计了 AccompBand,以实现更高的质量、更好的对齐和更优的控制。在训练过程中,AccompBand 使用两个编码器提取真实伴奏和人声的编码。由带有Band-MOE 的 Band Transformer Blocks 进行处理,Band-MOE 通过选择合适的专家,以提高质量、对齐度和控制力。在推理过程中,常微分方程求解器、伴奏解码器和声码器生成目标伴奏。组合生成最终的目标歌曲。
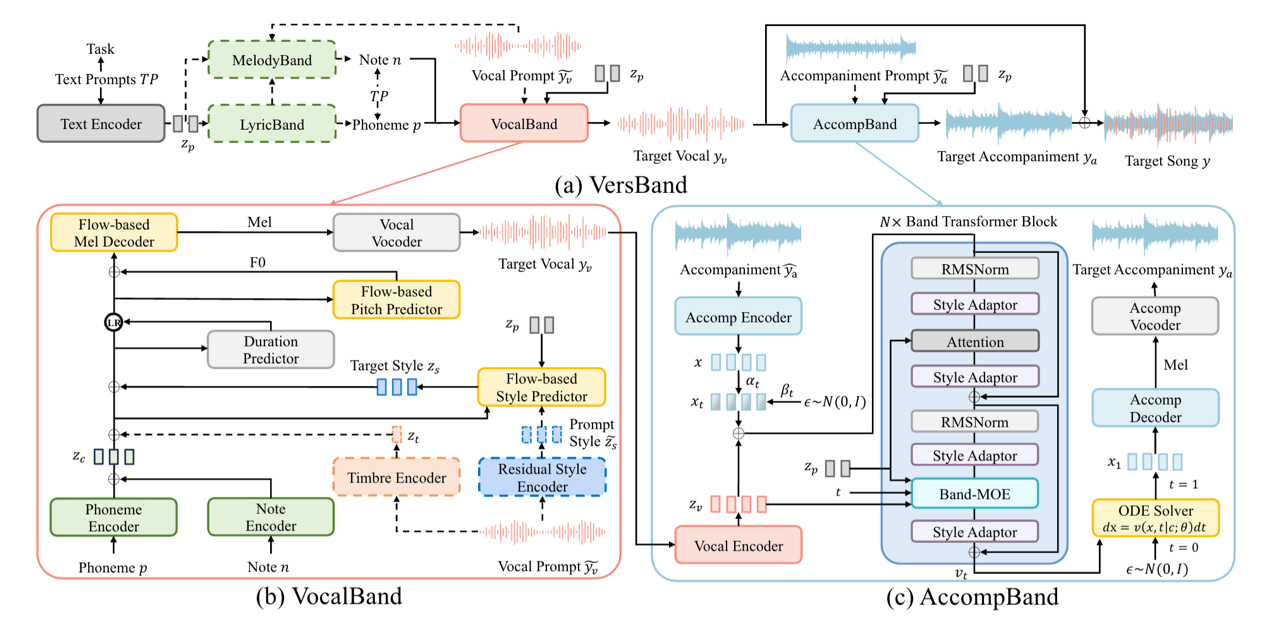
图2:VersBand 的整体架构。人声和伴奏分别由 VocalBand 和 AccompBand 生成。虚线表示可选流程,而 LR 代表长度调节器。
VocalBand
首先将目标人声拆分为内容、风格与音色三类表征。内容来自音素与音符(含音高与时值)的编码;给定一段参考人声作为提示,要求音色与个体化风格特征(如发音与吐字)保持一致,因此通过音色编码器获得提示的音色表示并直接用作目标音色;同时以残差风格编码器结合分层向量量化模型在音素级别提取提示风格,用作信息瓶颈以滤除与风格无关的要素。基于此设计流匹配的风格预测器,如图3(a)所示,联合内容、音色、提示风格以及来自文本的风格控制标记(如唱法、情绪、技巧等),先用注意力机制将控制信息与内容对齐得到融合条件,再用常微分方程求解器把随机初始样本沿平滑路径变换为目标风格。模型在时间轴上由向量场估计器学习真实变换方向,并将提示风格与中间表示拼接,使生成既继承个体化特征,又遵循文本提供的控制信号;提示风格与文本标记可单独输入,覆盖从纯参考驱动到纯文本控制的全谱风格操控。为刻画歌声中连续而复杂的动态,还提出同构的流式音高预测器与梅尔解码器,在内容、音色与风格的共同条件下快速稳定地产生音高轨迹与梅尔频谱,训练目标与风格分支保持一致,从而在保证个性与音色一致性的同时,实现高质量、自然连贯且可精细控制的风格、音高与声学特征生成。
AccompBand
伴奏生成需同时处理多乐器之间的复杂互动与与人声的精细对齐,且常见为超长序列;因此我们以流匹配提供平滑稳定的生成轨迹,以Transformer擅长的长程依赖建模捕获跨小节与跨段落的关联,并将二者结合为用于矢量场估计的Band Transformer Block:在结构上,将人声编码器的输出与带噪输入以残差方式融合,利用自注意力完成人声与伴奏的对齐;为保证训练稳定与风格一致,引入RMSNorm与带AdaLN的风格适配器;为刻画时间关系,采用RoPE位置编码;为稳健注入文本提示信息,使用零初始化注意力机制,使模型在流式迭代中既能快速收敛又能把控长时依赖与多声部协作。
如图3(b)所示,为进一步提升对齐性、可控性与音质,我们在每个Block内加入Band-MOE(专家混合),核心思想是“因歌而异、因风格而异、因频带而异”地选择专家:第一类是Aligned MOE,依据人声侧的统计(如响度包络、主要音区、节拍重音等)挑选最能匹配当前人声条件的专家,确保伴奏在能量、音区与节奏上先对齐不跑偏;第二类是Controlled MOE,依据文本中的风格与编配指示(例如鼓的侵略性、吉他的金属音色、和声织体稠密度与切分型)挑选细节控制能力更强的专家,使伴奏在后期快速贴合目标流派与编配手法;第三类是Acoustic MOE,考虑到梅尔谱在不同频带呈现差异模式且潜在表征保留频率结构,我们按低中高等频段划分专家,分别聚焦低频的贝司与底鼓律动与厚度、中频的和弦与主干织体、高频的泛音与打击细节,从而在分频协同中提升清晰度与质感。上述三类专家由分层路由器动态调度:其一,我们设计全局路由器感知噪声水平(时间步)并在不同阶段平衡对齐与控制——在早期隐状态仍然嘈杂时,更偏向Aligned MOE以先保证与人声的黏合和骨架重建;在后期主体已成型时,逐步提高Controlled MOE权重以强化风格与音色细节;其二,各专家组内部还各自配有局部路由器,Aligned侧重人声与节拍语义,Controlled侧重文本风格标记,Acoustic侧重频带能量与调制特征。所有路由采用“稠密到稀疏”的Gumbel-Softmax策略:训练前期以较高温度进行软混合有利探索,中后期退火至稀疏激活仅保留少数最合适专家,并通过top-k融合与残差主干汇合以兼顾效率与表达力。
为增强基于文本提示的可控性,我们进一步使用无分类器引导(CFG):训练时以固定概率将文本标记置空,让模型同时学习有条件与无条件两种矢量场;推理时将两者按引导强度参数加权组合,引导强度越大越强调文本驱动、控制更强但多样性可能下降,引导强度越小越保守更接近无条件生成;当引导强度取一时,退化为纯条件生成。综上,Band Transformer Block提供稳健高效的流式建模,Band-MOE在对齐、控制与频带三个维度实现精细专家化协作,并配合无分类器引导在推理阶段实现从创意到可控的连续调节,从而在长序列、多乐器场景下生成与人声高度贴合、风格明确且声学质量上乘的伴奏。
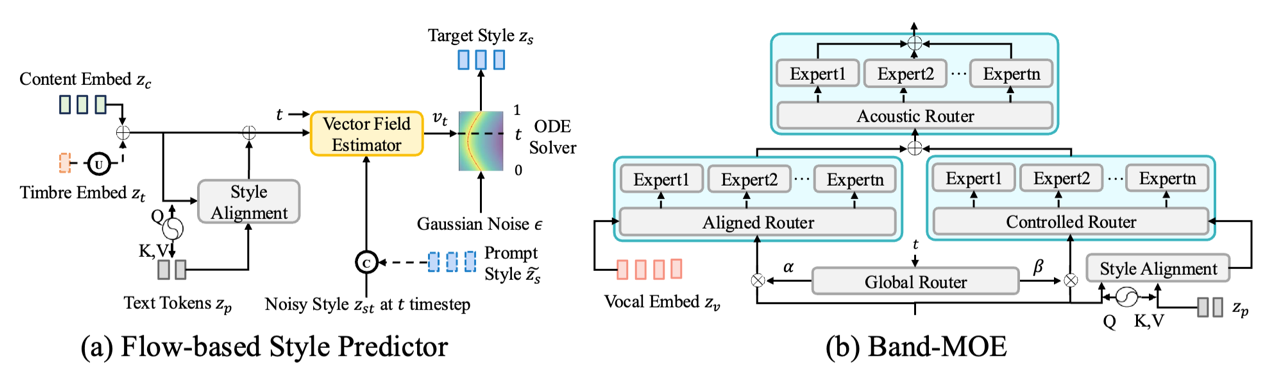
图3:VersBand 的整体架构。人声和伴奏分别由 VocalBand 和 AccompBand 生成。虚线表示可选流程,而 LR 代表长度调节器。
LyricBand & MelodyBand
为支持更个性化的创作流程,我们提出由两部分组成的文本到音乐上游模块:LyricBand 与 MelodyBand。LyricBand 面向完整歌词生成,用户仅需给出文本提示即可定制主题、情绪及其他偏好参数,我们基于开源的中英双语大模型 Qwen-7B,采用 QLoRA 进行高效微调,将通用语言能力迁移到歌词写作场景,既保持流畅度与连贯性,又提升可定制性与创造力。在旋律层面,以往歌声与歌曲生成方法常依赖外部乐谱才能保证旋律稳定,缺乏对旋律本身的可定制控制;为此我们提出 MelodyBand,直接依据文本提示、歌词与人声提示生成符号级音符序列,采用非自回归的 Transformer 结构以并行方式生成,提高长序列推断效率并减少累积误差;在对音素与音色进行编码后,通过交叉注意力注入文本 token,使旋律在音高走向、节奏型与乐句结构上能细粒度地响应文本与人声条件。通过“先词后曲”的解耦与条件对齐,LyricBand 提供可控的语义与情感基底,MelodyBand 在此之上快速生成与歌词与人声一致且可定制的旋律,为后续音高与声学解码模块奠定稳定、可控的音乐骨架。
我们对歌词、旋律、人声、歌曲都与baseline进行了对比实验,人声部分实验结果如下:
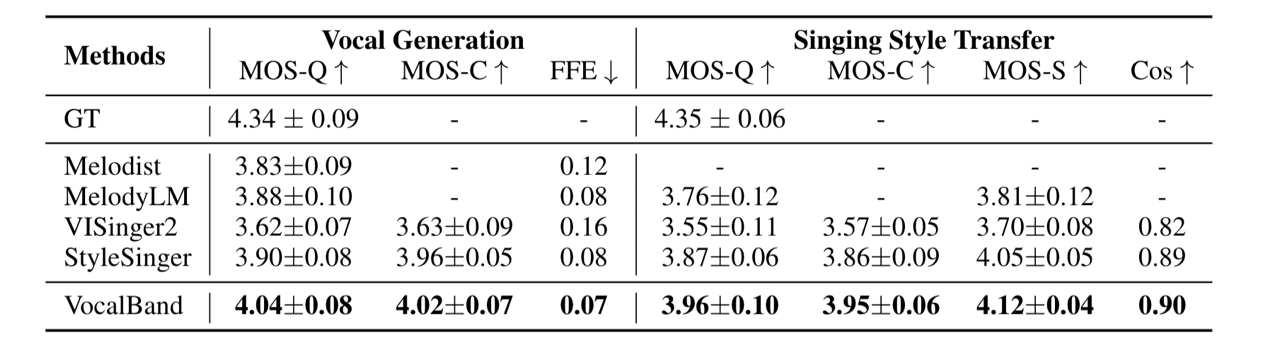
表1:人声生成和风格迁移的实验结果
接着,我们在表2展示了歌曲生成的结果。关于更多的相关任务实验,如伴奏风格转换、人声配伴奏、伴奏配人声的结果,详见论文。
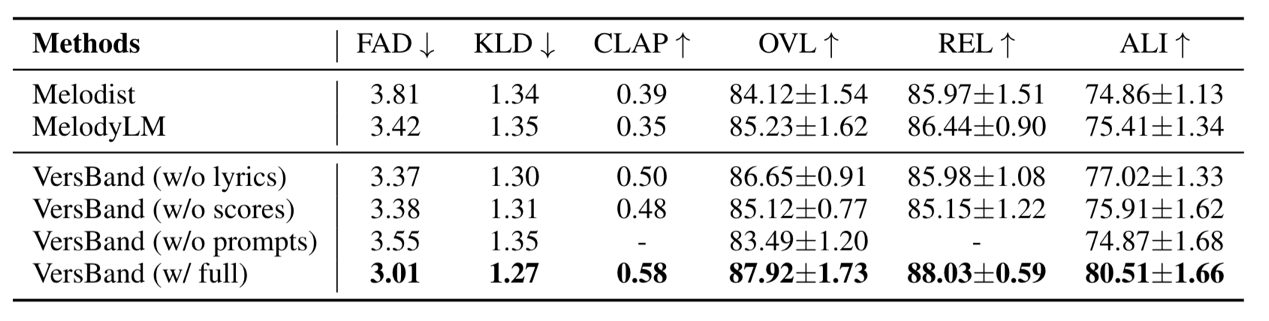
表2:歌曲生成的实验结果
在本文中,我们提出了VersBand,这是一个多任务歌曲生成框架,用于合成高质量、对齐的歌曲,并具备基于提示的控制能力。我们主要为这个多任务综合歌曲生成系统设计了VocalBand,AccompBand,LyricBand 和MelodyBand,为多功能歌曲生成系统做出了贡献。我们的实验结果表明,在多种歌曲生成任务中,无论是通过客观指标还是主观指标衡量,VersBand 的表现都优于基准模型。未来可以探索更具控制性和创造力的歌曲系统,且进行一阶段但能实现高控制力的生成。
