
 语音小管家
共情(Empathetic)能力是实现自然人机语音交互的核心要素,其核心在于使机器能够感知并理解用户输入语音中的各类副语言信息(如年龄特征、性别相关语音特质、情绪状态及声音事件等),进而作出贴合用户状态的共情回应。近年来,端到端语音语言模型(Speech LLM)通过统一语音理解与生成流程,为该领域提供了极具潜力的解决方案。具备共情能力的语音交互大模型的典型代表如 GPT-4o、豆包等商业产品,虽为用户带来了优质的共情对话体验,但此类商用系统均不开源且实现方案未公开,难以支撑学术领域的深入研究与二次开发。与此同时,现有技术体系仍面临三重关键挑战:一是过度依赖大规模对话数据集;二是对共情对话至关重要的副语言线索提取精度不足,难以支撑细腻、精准的共情交互;三是缺乏专门针对共情语音对话场景的数据集与标准化评估框架。
为解决上述问题,西北工业大学音频语音与语言处理研究组(ASLP@NPU)在前期语音理解大模型 OSUM 的研究基础上,提出基于语音理解的开源端到端共情语音对话系统 OSUM-EChat。该系统旨在增强语音交互中的共情能力,尤其适用于资源有限的环境,可为学术领域的共情语音对话研究提供可复用、可扩展的技术范式。此外,OSUM-EChat 集成语音理解、语音合成、语音到语音对话、语音到文本对话及文本到文本对话等功能,可作为通用语音基座模型,为社区开展下游任务开发提供便利。
相关技术报告 “OSUM-EChat: Enhancing End-to-End Empathetic Spoken Chatbot via Understanding-Driven Spoken Dialogue” 已发布在 arXiv 平台。代码、模型权重(ckpt)以及在线体验网页已全部开源,诚邀各位开发者、研究者体验使用,共探语音共情对话新可能!
论文题目:OSUM-EChat: Enhancing End-to-End Empathetic Spoken Chatbot via Understanding-Driven Spoken Dialogue
作者列表:耿雪龙、邵琪杰、薛鸿飞、王水源、解晗轲、郭昭、赵懿、李国健、田文杰、王成友、赵致闲、夏康翔、张子萸、林振楠、左天伦、邵明辰、曹雨昂、马国斌、李龙豪、戴宇航、高德辉、郭大可、谢磊
EChat-200K&EChat-eval地址(coming soon): https://huggingface.co/ASLP-lab/EChat-200K
背景动机
共情(Empathetic)作为语音对话系统实现自然交互的核心支撑,其核心作用在于使系统能够捕捉并解析用户语音中蕴含的各类副语言线索 —— 包括年龄特征、性别相关语音特质、情绪状态及声音事件等,进而生成与用户状态高度适配的共情化回应。在人类交流中,共情通过帮助个体识别情感等副语言信息的细微差别并作出适配回应,为建立有意义的社交联结奠定基础;对机器而言,要达到这种情感感知敏感度虽极具挑战,却是其生成真实自然、具备情感智能的交互回应的核心前提。
典型的级联对话系统需依次通过自动语音识别(ASR)、大语言模型(LLM)、文本转语音(TTS)处理语音输入,这种分阶段流程必然导致关键副语言信息丢失。为突破这一局限,端到端语音语言模型(Speech LLM)应运而生 —— 它通过统一语音理解与生成流程,将语音编码与解码整合到单一框架内,可更完整地保留副语言信息,为共情语音交互提供了极具潜力的解决方案。
现有端到端语音对话系统大致分为两类:模块化对齐的多模态模型与原生多模态模型 [1]。前者将音频建模交由模块化音频解码器,虽能较好保留 LLM 的通用能力,却难以捕捉和生成细粒度副语言线索;后者支持 LLM 直接对语音信号建模,更利于保留关键副语言信息,但在共情对话场景下仍面临三重关键挑战:一是过度依赖大规模标注对话数据集,数据获取与标注的时间及经济成本居高不下;二是副语言建模精度不足,难以支撑细腻、精准的共情交互;三是缺乏高质量共情对话专用数据及标准化评估框架,导致模型共情性能无法得到客观、统一的衡量。
针对上述挑战,在前期语音理解大模型OSUM[2]的研究基础上,我们提出开源端到端共情语音对话系统OSUM-EChat。该系统通过理解驱动的口语对话训练策略与语义-副语言双重思维机制,在数据受限环境下提升共情对话效果;同时配套构建 EChat-200K 数据集与 EChat-eval 评估基准,解决当前共情对话领域数据稀缺、评估缺乏统一标准的问题。此外,OSUM-EChat 同时集成语音理解、语音合成、语音到语音对话、语音到文本对话及文本到文本对话等功能,可作为通用语音基座模型,为学术领域的语音对话研究提供可复用、可扩展的技术范式,也为社区开展下游任务开发提供便利。
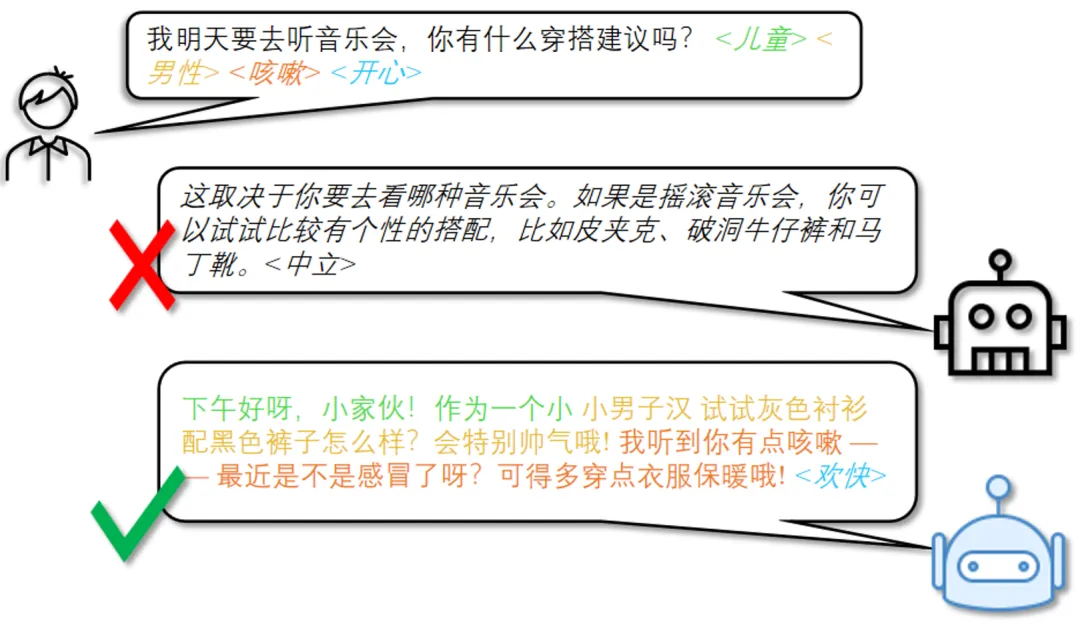
图1 共情语音对话模型与仅基于语义的语音对话模型的对比
模型架构
OSUM-EChat 的整体架构包含四个核心模块,分别为语音编码器(Speech Encoder)、适配器(Adapter)、大语言模型(LLM)及 Token2wav 模块;在训练进程的不同阶段,各模块参数分别处于可学习或冻结状态。
语音编码器:采用预训练模型 Whisper-Medium [3]。在输入处理阶段,该编码器可将 80 通道的对数幅度梅尔频谱图(log-magnitude mel-spectrogram)转换为高维特征向量。
适配器:由三层一维卷积(1D Convolution)模块、四层 Transformer 编码器层及一层线性层构成。其中,卷积层对输入特征进行 4 倍下采样;Transformer 编码器与线性层协同作用,将语音编码器输出的语音特征向量映射至 LLM 的嵌入空间(embedding space)。
大语言模型(LLM):以 Qwen2.5-3B-instruct [4] 为基础模型。为适配原生多模态范式,研究对该 LLM 的词汇表(vocabulary)进行扩展,新增 4097 个标记(token):其中 4096 个标记与 CosyVoice 语音码本(speech codebook)中的语音标记一一对应,剩余 1 个标记用于标识语音生成过程的起始与终止。该模块接收来自语音适配器的语音表征后,可交替生成文本标记与语音标记。
Token2wav 模块:基于 CosyVoice [5] 构建,包含两个关键组件 —— 用于梅尔频谱图估计的 Flow-Matching 模型,以及用于音频重建的 HiFi-GAN 声码器(Vocoder)。该模块能够将 LLM 生成的离散语音标记转换为连续音频波形,最终生成音质自然流畅、能精准传递副语言信息的语音响应。
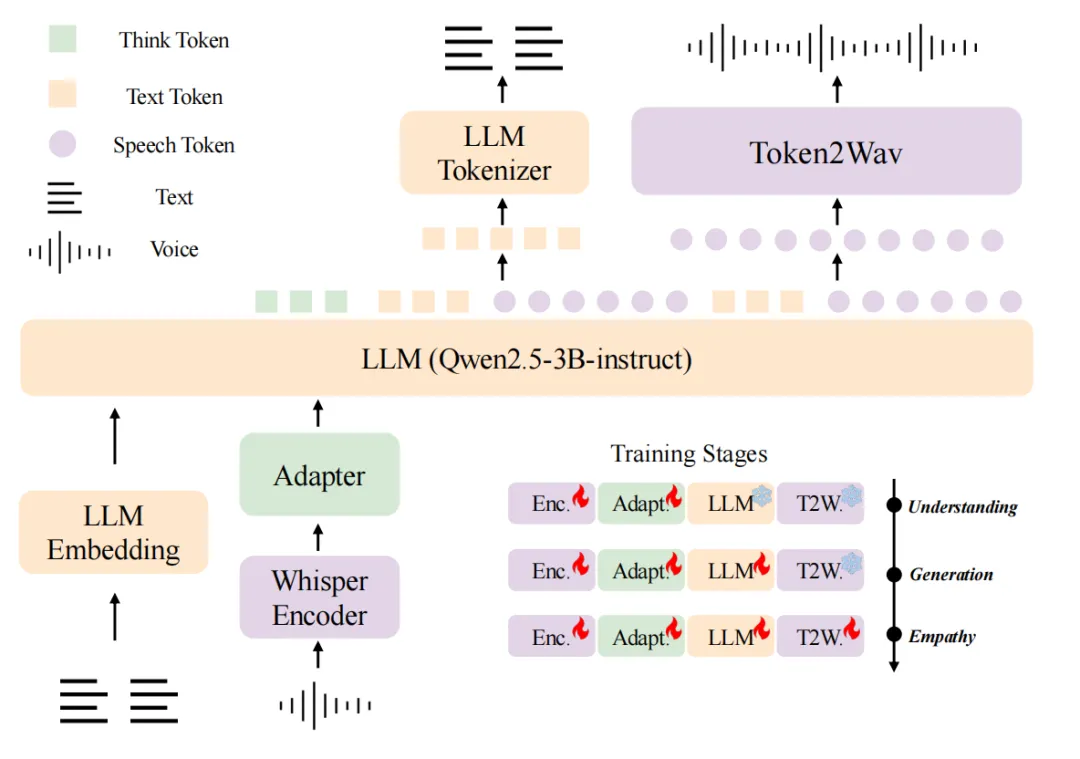
图2 OSUM-EChat的结构图
训练策略
为使 OSUM-EChat 在资源受限环境中实现共情对话,本研究提出 理解驱动的口语对话 三阶段训练策略,具体涵盖理解、生成与共情三个阶段。其中,在共情阶段,通过 语义-副语言双重思维机制 提取并分离副语言信息与语义信息,助力模型生成更具共情性的回应。
阶段 1:理解
本阶段的核心目标是使大语言模型(LLM)理解语音中的语义与副语言信息。研究采用 OSUM 框架下的 “ASR+P” 策略(其中 P 代表副语言标签,包括情绪、性别、年龄及声音事件等),对多个 “ASR+P” 任务开展联合训练;训练过程中,仅语音编码器与适配器的参数设为可学习状态,其余模块参数冻结。当模型掌握副语言标签 P 的识别能力后,通过生成包含所有 P 标签的伪标记数据扩展数据集,使模型具备同时识别全部 P 标签的能力,为后续集成至对话任务奠定基础。
阶段 2:生成
本阶段旨在为基于 OSUM 的语音理解模型赋予语音生成能力,采用 “文本转语音(TTS)生成 - 语音转语音(S2S)对话” 两步走训练流程,同时引入文本到文本(T2T)数据,以维持模型的通用语言智能。
TTS 训练:在 TTS 阶段,利用 TTS 任务数据对 LLM 进行微调,使模型具备生成语音标记的能力。该过程中,模型输入为文本,输出为语音标记,仅 LLM 的参数设为可学习状态。
S2S 训练:在 TTS 阶段训练基础上,进一步结合语音到语音对话数据开展联合训练。此阶段中,语音编码器、适配器及 LLM 的参数均设为可学习状态。训练时,LLM 接收来自适配器的语音表征,并生成文本标记与语音标记;S2S 任务分为非流式与流式两种模式:非流式模式下,模型先输出文本标记,再输出语音标记;流式模式下,模型交替输出文本标记与语音标记,以维持稳定的语音生成占比,本文中文字与语音的输出比例设定为 1:3。
阶段 3:共情
本阶段将语音理解阶段获取的语义与副语言信息整合至对话生成过程,显著提升模型生成上下文连贯且具备共情性回应的能力。具体而言,本研究通过语义-副语言双重思维机制,在模型生成文本与语音回应前引入专门的思维链(CoT)过程:先由模型识别用户语音中的语义信息,再推断其中的副语言细节,最终整合上述信息生成适配的文本与语音回应。
在思维链(CoT)的设计上,本研究设计两种不同形式的 CoT 方案,以探究不同的CoT形式对模型共情理解与回应生成效果的影响,具体如下:
基于标签的 CoT:采用固定模板结构生成内容。具体而言,模型先输出经自动语音识别(ASR)得到的转录文本,以此完成用户输入语义信息的提取;随后,按序输出预先定义的副语言信息标签,包括年龄、性别、声音事件及情感等。该方案的显著优势在于:CoT 阶段生成的内容格式相对固定、长度较短,整体过程易于控制,可高效完成核心副语言线索的提取与整合。但该方案存在局限:受限于预设标签的数量与范围,无法充分表达标签未覆盖的丰富细腻副语言状态(如语音中语气强弱的变化、情绪的微妙转折等)。
基于自然语言的 CoT:摒弃固定标签模板,采用自然流畅的语言描述完成思维链过程。模型以连贯的文本段落为载体,先对用户输入语音中的语义内容进行阐释(而非单纯的文本转录),再详细描述其中蕴含的副语言信息 —— 包括但不限于年龄特征的具体体现、与性别相关的语音特质、各类声音事件的发生场景及特征,以及情感的细腻层次与变化趋势等。该方案的优势在于:可突破标签的限制,更灵活、全面地捕捉并表达复杂的副语言状态,为后续生成更具共情性的回应提供更丰富的依据;但相对而言,其生成内容的长度与结构较难控制,可能增加模型的计算负担,且对模型的语言组织能力提出更高要求。
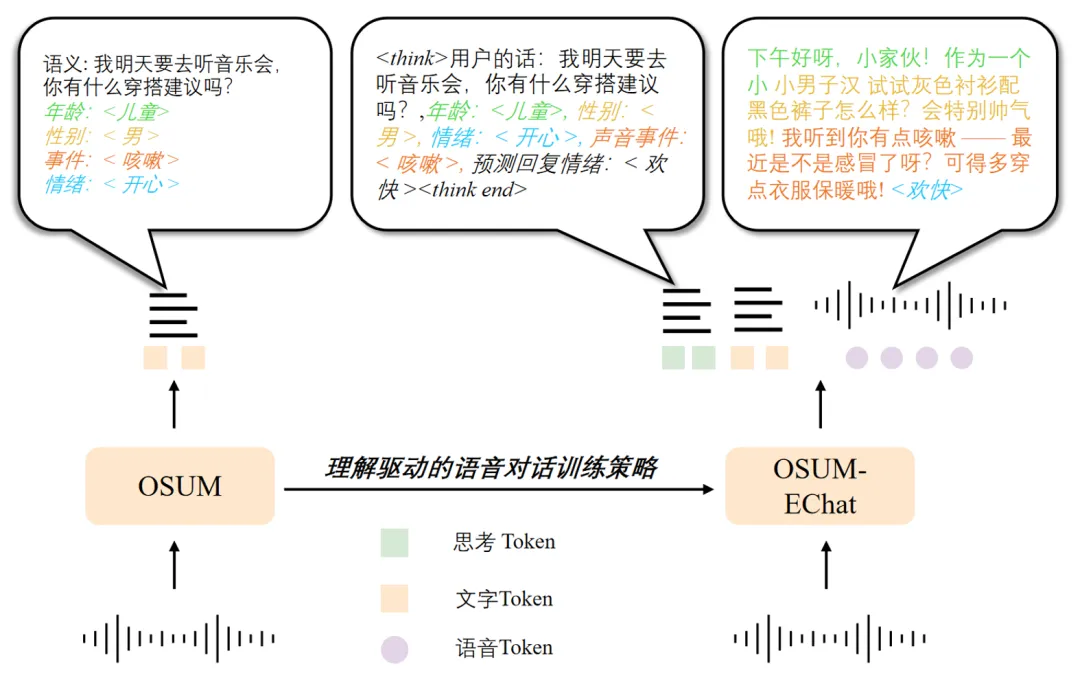
图 3 语音理解模型 OSUM 至共情语音对话模型 OSUM-EChat 的演进可视化
EChat-200K 数据集与 EChat-eval 基准
EChat-200K 数据集
为使 OSUM-EChat 能够处理对共情对话至关重要的副语言线索,本研究构建了包含约 200k 个对话的 EChat-200K 数据集。该数据集分为单标签共情数据和多标签共情数据,单标签数据每次交互聚焦于一个副语言线索,多标签数据则鼓励模型整合多个副语言线索。为降低对合成音频的过拟合风险,数据集中包含一定比例的真实音频输入查询。
EChat-eval 基准
为系统评估模型捕捉副语言线索的能力,提出了 EChat-eval 基准,与 EChat-200K 训练语料库的任务分类一致。每个任务包含 280 个条目,约三分之一来自真实录音,以减少合成数据与真实人类对话场景之间的差异。评估时,将查询对应的转录文本及其相关副语言标签、回应文本和从回应语音中提取的情感标签共同输入 ChatGPT-4o,由其从多个维度生成最终分数。
实 验
共情语音对话
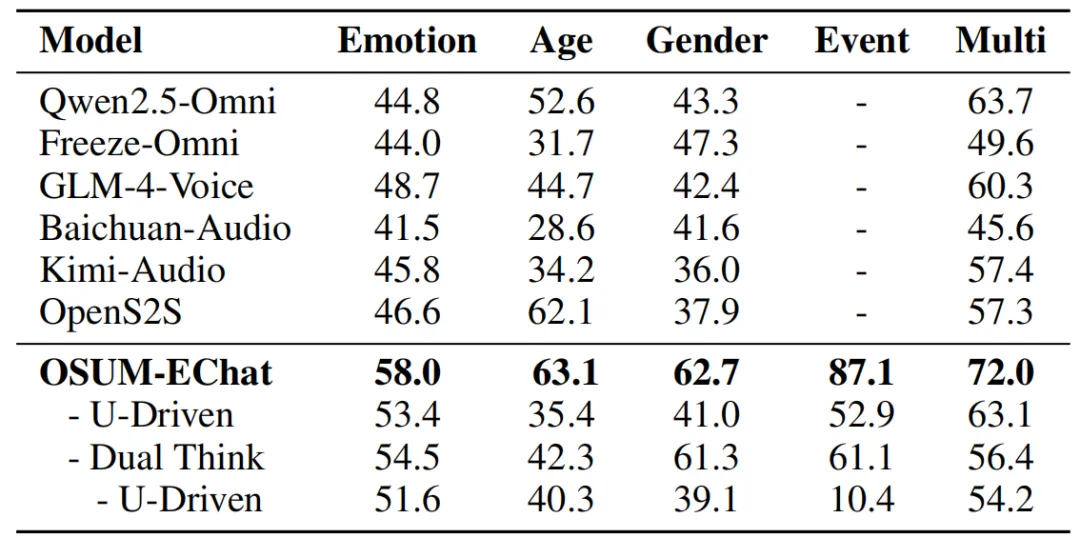
在 EChat-eval 基准的评估中,OSUM-EChat 在共情对话任务上表现优异:在各类共情对话场景中,其获得的 GPT-4o 自动评分均处于高水平,尤其在多标签场景下表现突出,且对输入语音中多样声学事件的处理能力较强,具体结果如表 1 所示。
表 1 EChat-eval 基准下的 GPT-4o自动评估结果(注:“-” 表示模型无相关能力)
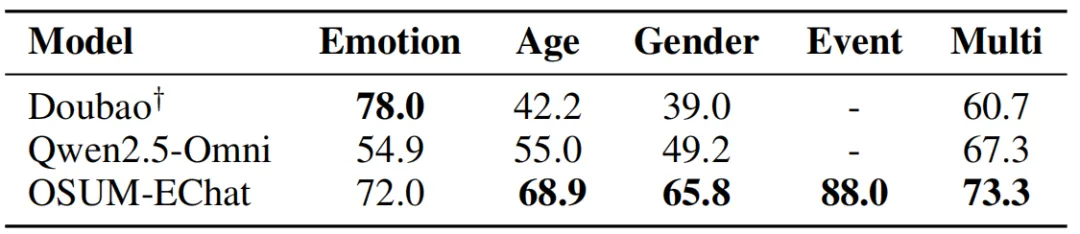
EChat-eval 的人工评估结果进一步显示,OSUM-EChat 的综合表现优于 Qwen2.5-Omni;在情感维度的共情对话测试案例中,其性能优异,但仍逊于商业系统。值得关注的是,在其他副语言维度(如年龄、性别、声音事件等)的共情对话任务中,商业系统暂无法有效捕捉相关线索,详细数据如表 2 所示。
表2 代表性模型在 EChat-eval 基准下的人工评估结果 †字节跳动的采用单一固定发言人的商业系统(注:“-” 表示模型无相关能力)
消融实验结果验证:将语音理解模型(OSUM)应用于口语对话任务,并结合 “语言 - 副语言双重思维机制”,可显著提升模型的共情对话能力,具体验证数据如表 1 所示。
语音基础能力
OSUM-EChat 在语言智能、语音理解、语音合成三大语音基础能力的评估中,均展现出优异且稳定的性能表现,具体分析如下:
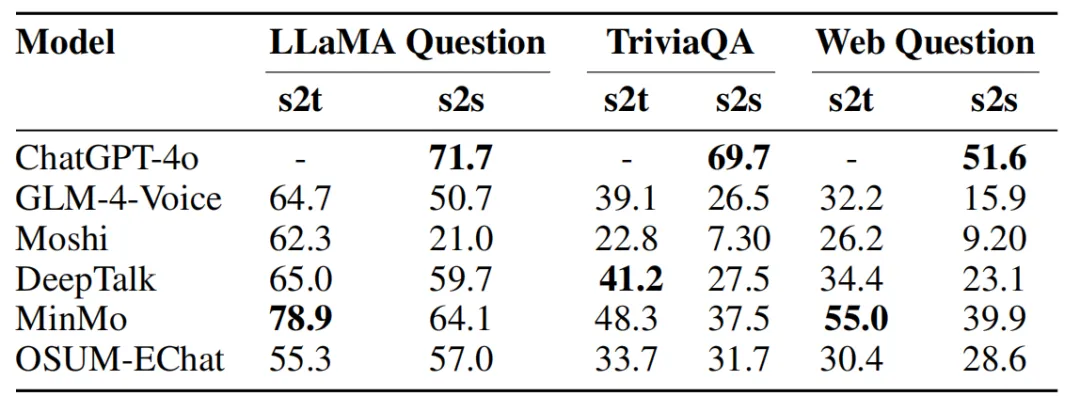
语言智能:依托大规模文本对话数据及研究团队内部构建的知识类语音问答数据集,OSUM-EChat 的语言智能水平与业界主流端到端语音对话模型相当,口语问答任务的具体评测结果如表 3 所示。
表3 口语问答任务评测结果
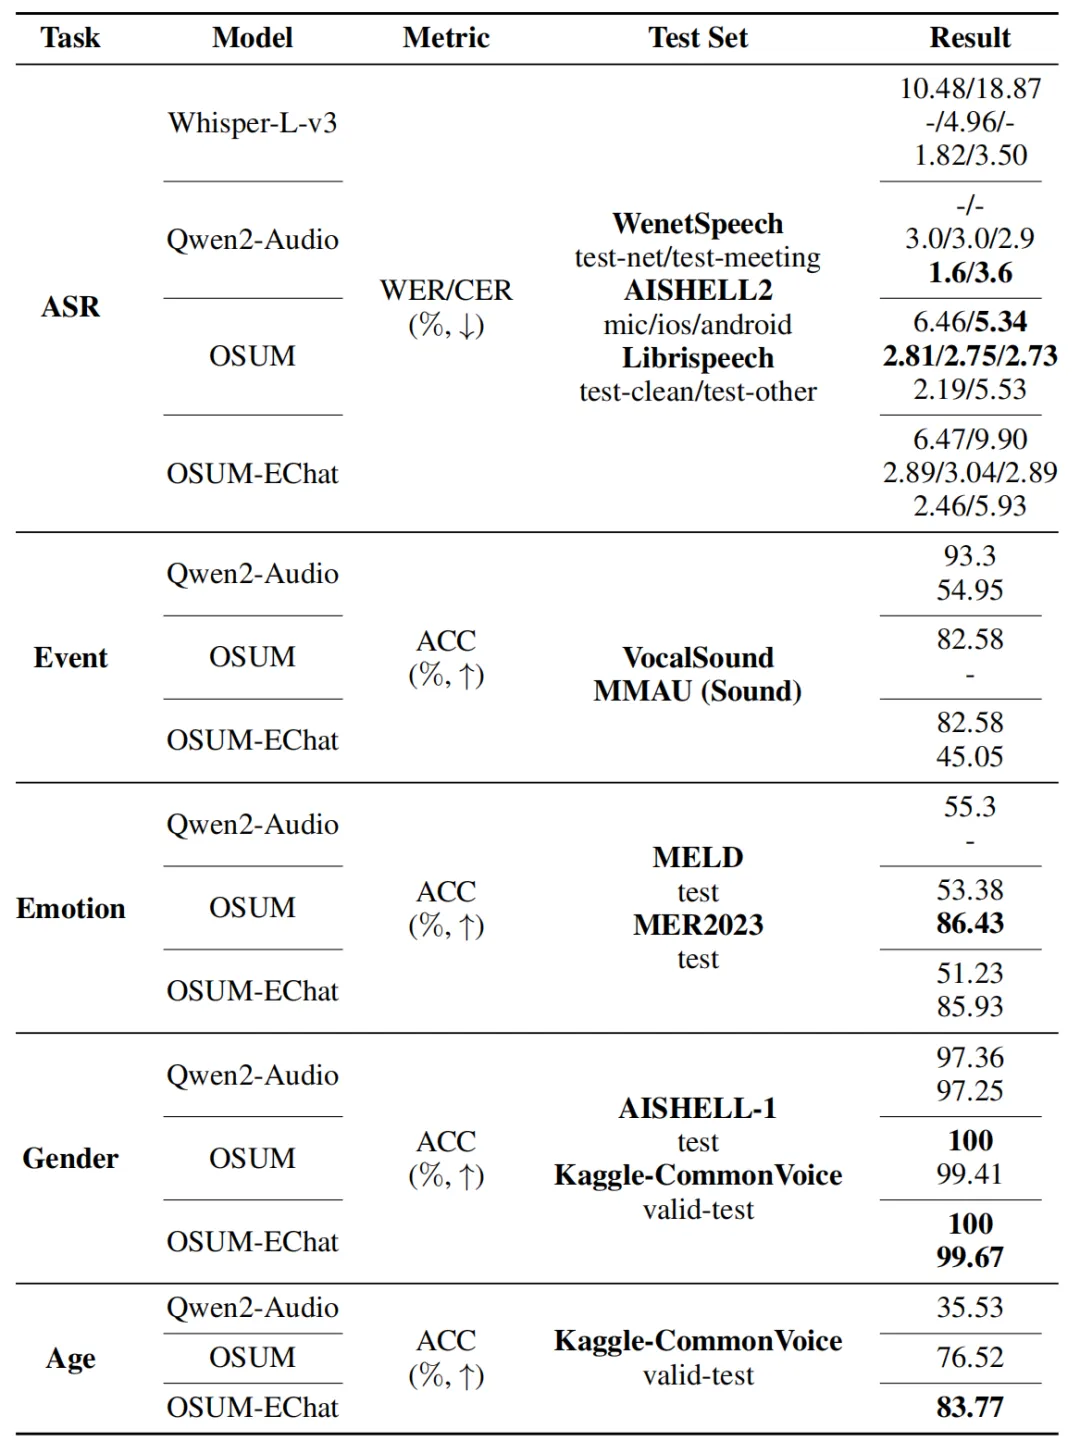
语音理解:本研究在语音识别(ASR)、声音事件识别、情感识别、年龄识别、性别识别五大任务的开源测试集上,对 OSUM-EChat 的语音理解能力进行验证。结果表明,其性能与语音理解大模型 OSUM 基本持平(该模型LLM基座为Qwen-7B),且已接近工业级语音理解模型 Qwen2-Audio 的水平。
表4 多种语音理解任务在公共测试集上的评估结果
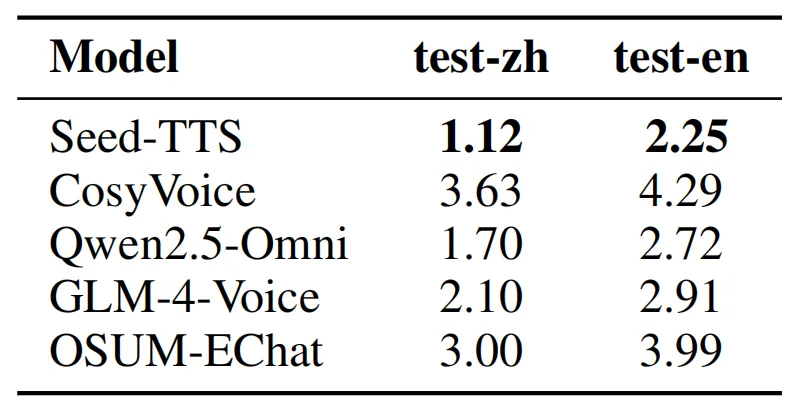
语音合成:本研究在 SEED [6] 测试集上对 OSUM-EChat 的文本转语音(TTS)能力进行评测,结果显示:其 TTS 性能优于 CosyVoice 模型,但与工业级语音对话模型及专业 TTS 模型相比仍存在差距,详细指标(词错误率、字错误率)如表 5 所示。
表5 SEED 测试集上 OSUM-EChat 与近期口语对话模型的性能对比(单位:%,↓表示指标越优)
参考文献
[1] Chen, Q.; Chen, Y.; Chen, Y.; Chen, M.; Chen, Y.; Deng, C.; Du, Z.; Gao, R.; Gao, C.; Gao, Z.; Li, Y.; Lv, X.; Liu, J.; Luo, H.; Ma, B.; Ni, C.; Shi, X.; Tang, J.; Wang, H.; Wang, H.; Wang, W.; Wang, Y.; Xu, Y.; Yu, F.; Yan, Z.; Yang, Y.; Yang, B.; Yang, X.; Yang, G.; Zhao, T.; Zhang, Q.; Zhang, S.; Zhao, N.; Zhang, P.; Zhang, C.; and Zhou, J. 2025b. MinMo: A Multimodal Large Language Model for Seamless Voice Interaction. CoRR, abs/2501.06282.
[2] Geng, X.; Wei, K.; Shao, Q.; Liu, S.; Lin, Z.; Zhao, Z.; Li,G.; Tian, W.; Chen, P.; Li, Y.; Guo, P.; Shao, M.; Wang, S.;Cao, Y.; Wang, C.; Xu, T.; Dai, Y.; Zhu, X.; Li, Y.; Zhang,L.; and Xie, L. 2025. OSUM: Advancing Open Speech Understanding Models with Limited Resources in Academia.CoRR,abs/2501.13306.
[3]Radford, A.; Kim, J. W.; Xu, T.; Brockman, G.; McLeavey, C.; and Sutskever, I. 2023. Robust Speech Recognition via Large-Scale Weak Supervision. In Krause, A.; Brunskill, E.; Cho, K.; Engelhardt, B.;Sabato,S.; and Scarlett, J., eds.,ICML 2023, volume 202 ofProceedings of Machine Learning Research, 28492–28518. PMLR.
[4]Yang, A.; Yang, B.; Zhang, B.; Hui, B.; Zheng, B.; Yu, B.; Li, C.; Liu, D.; Huang, F.; Wei, H.; and et al. 2024. Qwen2.5 Technical Report.CoRR, abs/2412.15115.
[5]Du, Z.; Chen, Q.; Zhang, S.; Hu, K.; Lu, H.; Yang, Y.; Hu, H.; Zheng, S.; Gu, Y.; Ma, Z.; Gao, Z.; and Yan, Z. 2024a. CosyVoice: A Scalable Multilingual Zero-shot Text-to-speech Synthesizer based on Supervised Semantic Tokens.CoRR, abs/2407.05407.
[6]Anastassiou, P.; Chen, J.; Chen, J.; Chen, Y.; Chen, Z.; Chen, Z.; and et al. 2024. Seed-TTS: A Family of High-Quality Versatile Speech Generation Models.CoRR, abs/2406.02430
