
 语音小管家
NEON 是 ARM Cortex A 系列处理器支持的数据并行技术,和 SSE/AVX 类似:一条指令以指令级 SIMD 的方式同时对多个数据进行操作,同时,操作的数据个数由向量寄存器的长度和数据类型共同决定。NEON SIMD 寄存器的长度为 128 位,如果操作 32 位浮点数,可同时操作 4 个;如果操作 16 位整数(short),可同时操作 8 个;而如果操作 8 位整数,则可同时操作 16 个。
ARMv7 NEON 指令集架构具有 16 个 128 位的向量寄存器,命名为 q0~q15。这 16 个寄存器又可以拆分成 32 个 64 位寄存器,命名为 d0~d31。其中 qn 和 d2n、d2n+1 是一样的,故使用汇编编写代码时要注意避免产生寄存器覆盖。NEON指令集的具体使用方法可以在网上进行查看,值得注意的是ARMv8和v7的寄存器和指令集有写差异,使用时应当注意。此外NEON支持汇编语言直接操控寄存器也可以使用封装好的C语言接口进行调用。
我们并不需要自己使用C或者汇编实现FFT,ARM官方release的DSP库Ne10里面就包含了FFT的实现。Ne10 是由 ARM 公司开发并维护的一个开源 DSP 和数学函数库,旨在充分利用现代 ARM 架构,特别是ARM NEON向量化指令集。与传统的通用 DSP 库不同,Ne10 的代码经过了高度优化,能够直接利用 Neon 硬件加速,从而在 CPU 密集型任务中实现显著的性能提升。
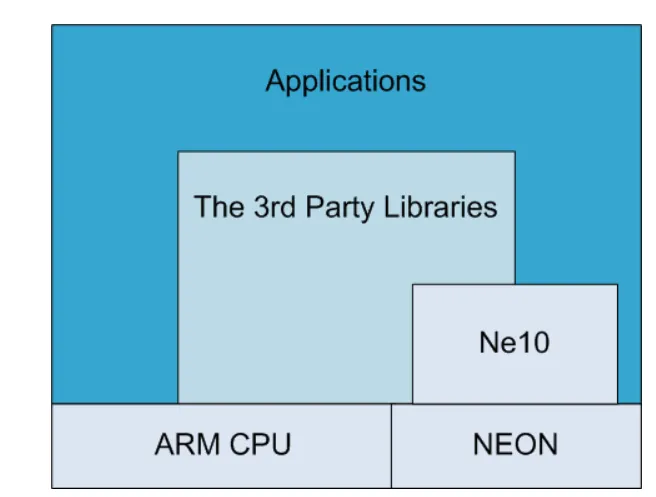
需要说明的是,Ne10完整的库包括了信号处理、图像处理、数学等内容,整体比较大。为了方便使用,将FFT部分单独抽离,编译出来的库只有53KB,相关代码参考文末链接。
在实际应用中,通常不需要完整的复数到复数 FFT 运算;许多应用只处理实数信号。因此,Ne10 提供了实数到复数和复数到实数的一维 FFT/IFFT 运算。与复数到复数函数一样,这些函数仅在逆变换中将数据缩放 1/N。此外,这些 FFT/IFFT 函数提供了三种变体,分别针对 FP32、Q31 和 Q15 数据类型进行操作。Ne10 FFT每种变体都提供纯 C 实现、NEON 实现以及一个函数指针,用于在运行时进行选择。
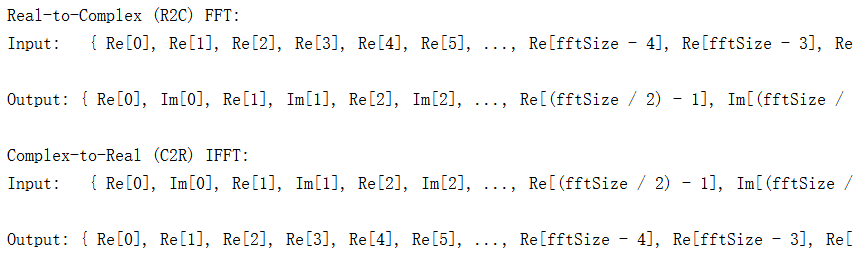
需要说明,Ne10的FFT只支持为2的整数次幂的FFT变换,FFT变换后复数元素的缓冲区将每个元素的实部和虚部交错存储,并将它们连续存储;而实数元素的缓冲区则以简单的 C 数组形式在内存中连续保存值。由于实数到复数的傅里叶变换具有共轭对称性,因此正向变换的输出长度仅为 (fftSize / 2) + 1 个复数元素。同样,逆变换的输入也只需如此长。内存排布如下所示:
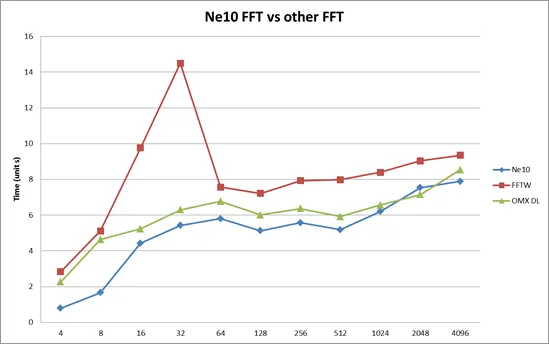
最后看下Ne10 FFT与其他FFT实现的速度比较,如下图所示,从图表中可以看出,
对于较小的样本点数(如4、8、16、32),FFTW的执行时间相对较高,特别是在32点时达到峰值。
随着样本点数的增加,Ne10和OMX DL的性能表现相对稳定且接近,而FFTW的性能则有所下降,
但在大部分情况下,其执行时间都高于Ne10和OMX DL。
本文相关代码:https://github.com/Ryuk17/neon-fft
参考文献:
[1].https://github.com/mborgerding/kissfft/releases/tag/131.1.0
[2].https://www.fftw.org/fftw-3.3.10.tar.gz
[3].https://github.com/projectNe10/Ne10
