
 语音小管家
最近小红书团队放出了一个具有突破性意义的 TTS 开源项目 FireRedTTS-2 。它是一款专门面向多人对话场景的 TTS(Text-to-Speech)模型。
技术报告:https://arxiv.org/pdf/2509.02020
Demo:https://fireredteam.github.io/demos/firered_tts_2/
代码链接:https://github.com/FireRedTeam/FireRedTTS2
支持一次生成3分钟4人对话,通过扩展训练数据可实现更长序列和更多说话人,效果自然稳定,无明显串声或跳音。在L20 GPU上首包延迟仅140ms,适用于语音客服、直播配音等实时场景。
支持7国语言零样本克隆,甚至中英混合合成,完美适配全球化应用。
核心亮点
多人对话生成:一次可生成 3 分钟 4 人播客,对话自然衔接。 可扩展性强:通过扩展训练数据,可以支持更长时长、更多说话人。 低延迟:在 L20 GPU 上首包延迟仅 140 毫秒,完全可以用在实时语音客服、直播配音场景。 多语言支持:支持 7 种语言,还能做到零样本语音克隆。 自然稳定:相较于很多开源 TTS 出现的「声音串台」「语调突兀」问题,FireRedTTS-2 在稳定性上表现更佳。
FireRedTTS-2 系统简介
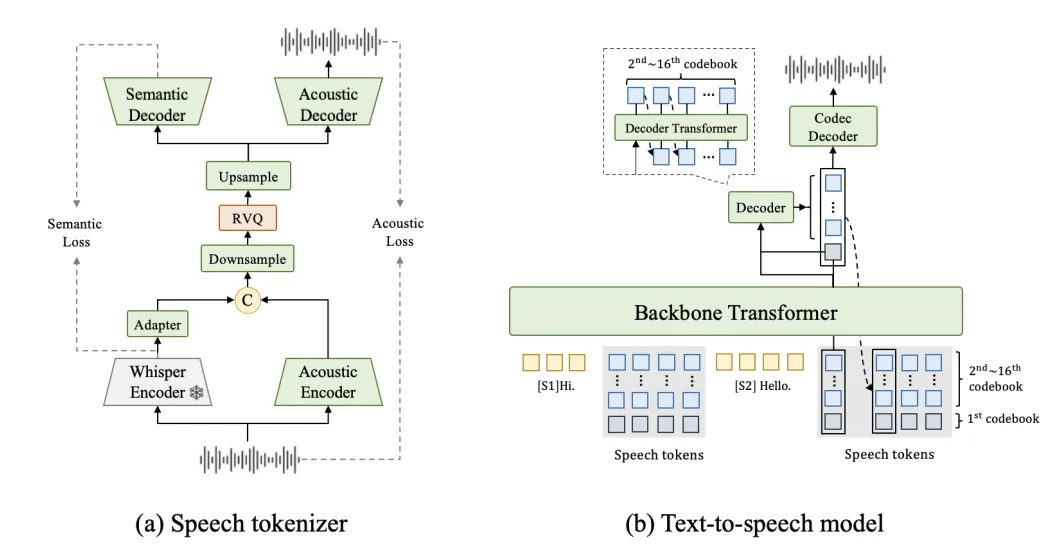
为解决当前对话合成系统存在的灵活性不足、合成质量欠佳等问题,FireRedTTS-2 升级了 TTS 系统的两大核心模块:
离散语音编码器(Speech tokenizer):12.5Hz 低帧率,具有更强语义信息,且支持流式解码
文本语音合成模型(Text-to-speech model):支持逐句生成,合成稳定且质量高
离散语音编码器
离散语音编码器将连续语音信号压缩为离散标签序列,便于大语言模型处理。FireRedTTS-2 采用的语音编码器以 12.5Hz 的低帧率输出:即 1 秒仅对应 12.5 个标签。对于对话建模,这缩短了语音序列长度、即提升了速度,又缩小了与文本序列的长度差距,降低了大语言模型的建模难度。为增强语义表达,编码器在训练时引入预训练模型提取的语义特征,并对离散标签进行语义监督,使标签携带更丰富的语义信息,帮助模型更容易学会从文本到语音的映射。除此之外,它还支持流式解码,可实时输出音频,便于无缝接入各类流式交互应用。
在训练策略上,离散语音编码器先在约 50 万小时的多样化语音数据上训练,以提升泛化能力;再在其中约 6 万小时的高质量语音上继续训练,优化重建音质。
文本语音合成模型
为提升对话合成的灵活性,FireRedTTS-2 采用文本 - 语音混排的格式,支持逐句生成,便于后续编辑与多场景适配。混排格式将对话文本与语音组织为:“[S1] 说话人 1 文本 + 语音 [S2] 说话人 2 文本 + 语音 [S3] 说话人 3 文本 + 语音…”,其中 [S1]、[S2]、[S3] 为说话人标签,用于区分不同角色。
在模型架构上,为更充分地利用对话上下文,FireRedTTS-2 采用 “双 Transformer ” 的设计:
1.5B 参数的 Backbone Transformer 负责建模混排序列中语音的粗粒度信息
0.2B 参数的 Decoder Transformer 补充语音中的声学细节
相比常用的 Delay pattern 方法,该架构充分利用了上下文中的文本与语音,可以生成更自然、连贯的对话语音;同时支持低首包延迟,配合离散语音编码器的流式解码,实现更快起播。
FireRedTTS-2 采用两阶段训练:先在 110 万小时单句语音上预训练,夯实合成基础;再用 30 万小时对话语音继续训练,覆盖 2–4 人对话场景。由此可稳定生成高质量对话语音,准确处理说话人切换,保持上下文一致与自然韵律。面向应用场景, FireRedTTS-2 仅需少量数据即可实现微调,快速完成音色定制。
FireRedTTS-2 效果比较
为评估对话合成效果,FireRedTTS-2 与 MoonCast、ZipVoice-Dialogue、MOSS-TTSD 等其他系统在自建的中英文对话测试集上进行了比较:
客观上,比较了对话合成的正确率(CER/WER)、对话间说话人保持能力(SIM)、以及与真实录音之间的差距(MCD)
主观上,FireRedTTS-2 与其他系统进行了偏好打分(CMOS)
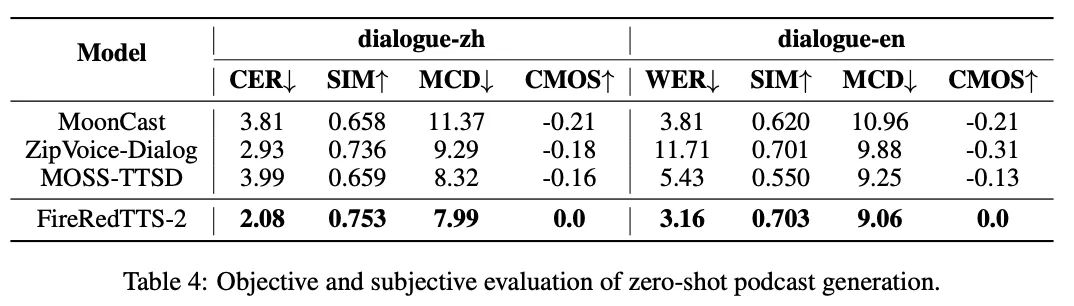
结果显示,FireRedTTS-2 在主客观指标上均为最优,显著降低发音错误,避免说话人混淆,具有更真实的韵律表现,为对话合成提供了更优解。
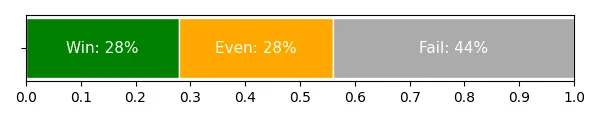
同时,FireRedTTS-2 只需约 50 小时的特定播客说话人录音即可完成音色定制,使对话合成的自然度逼近真人。在自建中文对话测试集上,我们开展了客观(CER)与主观(自然度偏好)评测:微调后 CER 仅为 1.66%;主观听评中,28% 的测例被认为比真实播客录音更自然,另有 28% 难以区分二者。总体来看,56% 的测例表明其自然度已达到或超过真实录音。
安装部署
安装指南:
1、克隆项目
git clone https://github.com/FireRedTeam/FireRedTTS2.git
cd FireRedTTS2
2、创建虚拟环境
conda create --name fireredtts2 python==3.11
conda activate fireredtts2

# Step 1. PyTorch Installation (if required)
pip install torch==2.7.1 torchvision==0.22.1 torchaudio==2.7.1 --index-url https://download.pytorch.org/whl/cu126

# Step 2. Install Dependencies
pip install -e .
pip install -r requirements.txt
3、模型下载
git lfs install
git clone https://huggingface.co/FireRedTeam/FireRedTTS2 pretrained_models/FireRedTTS2
基本使用
启动WebUI界面进行使用
python gradio_demo.py --pretrained-dir "./pretrained_models/FireRedTTS2" 代码生成示例(对话生成):
import os
import sysimport torchimport torchaudiofrom fireredtts2.fireredtts2 import FireRedTTS2device = "cuda"fireredtts2 = FireRedTTS2(    pretrained_dir="./pretrained_models/FireRedTTS2",    gen_type="dialogue",    device=device,)text_list = [
    "[S1]那可能说对对,没有去过美国来说去去看到美国线下。巴斯曼也好,沃尔玛也好,他们线下不管说,因为深圳出去的还是电子周边的会表达,会发现哇对这个价格真的是很高呀。都是卖三十五美金、四十美金,甚至一个手机壳,就是二十五美金开。",
    "[S2]对,没错,我每次都觉得不不可思议。我什么人会买三五十美金的手机壳?但是其实在在那个target啊,就塔吉特这种超级市场,大家都是这样的,定价也很多人买。",
    "[S1]对对,那这样我们再去看说亚马逊上面卖卖卖手机壳也好啊,贴膜也好,还包括说车窗也好,各种线材也好,大概就是七块九九或者说啊八块九九,这个价格才是卖的最多的啊。因为亚马逊的游戏规则限定的。如果说你卖七块九九以下,那你基本上是不赚钱的。",
    "[S2]那比如说呃除了这个可能去到海外这个调查,然后这个调研考察那肯定是最直接的了。那平时我知道你是刚才建立了一个这个叫做呃rean的这样的一个一个播客,它是一个英文的。然后平时你还听一些什么样的东西,或者是从哪里获取一些这个海外市场的一些信息呢?",
    "[S1]嗯,因为做做亚马逊的话呢,我们会关注很多行业内的东西。就比如说行业有什么样亚马逊有什么样新的游戏规则呀。呃,物流的价格有没有波动呀,包括说有没有什么新的评论的政策呀,广告有什么新的打法呀?那这些我们会会关关注很多行业内部的微信公众号呀,还包括去去查一些知乎专栏的文章呀,以及说我们周边有很多同行。那我们经常会坐在一起聊天,看看信息有什么共享。那这个是关注内内的一个方式。",]prompt_wav_list = [
    "examples/chat_prompt/zh/S1.flac",
    "examples/chat_prompt/zh/S2.flac",]prompt_text_list = [
    "[S1]啊,可能说更适合美国市场应该是什么样子。那这这个可能说当然如果说有有机会能亲身的去考察去了解一下,那当然是有更好的帮助。",
    "[S2]比如具体一点的,他觉得最大的一个跟他预想的不一样的是在什么地方。",]all_audio = fireredtts2.generate_dialogue(    text_list=text_list,    prompt_wav_list=prompt_wav_list,    prompt_text_list=prompt_text_list,    temperature=0.9,    topk=30,)torchaudio.save("chat_clone.wav", all_audio, 24000)
代码生成示例(独白生成):
import os
import sysimport torchimport torchaudiofrom fireredtts2.fireredtts2 import FireRedTTS2device = "cuda"lines = [
    "Hello everyone, welcome to our newly launched FireRedTTS2. It supports multiple languages including English, Chinese, Japanese, Korean, French, German, and Russian. Additionally, this TTS model features long-context dialogue generation capabilities.",
    "如果你厌倦了千篇一律的AI音色,不满意于其他模型语言支持不够丰富,那么本项目将会成为你绝佳的工具。",
    "ランダムな話者と言語を選択して合成できます",
    "이는 많은 인공지능 시스템에 유용합니다. 예를 들어, 제가 다양한 음성 데이터를 대량으로 생성해 여러분의 ASR 모델이나 대화 모델에 풍부한 데이터를 제공할 수 있습니다.",
    "J'évolue constamment et j'espère pouvoir parler davantage de langues avec plus d'aisance à l'avenir.",]fireredtts2 = FireRedTTS2(    pretrained_dir="./pretrained_models/FireRedTTS2",    gen_type="monologue",    device=device,)

# random speaker
for i in range(len(lines)):    text = lines[i].strip()    audio = fireredtts2.generate_monologue(text=text)
    # adjust temperature & topk
    # audio = fireredtts2.generate_monologue(text=text, temperature=0.8, topk=30)    torchaudio.save(str(i) + ".wav", audio.cpu(), 24000)


# # voice clone
# for i in range(len(lines)):
#     text = lines[i].strip()

#     audio = fireredtts2.generate_monologue(
#         text=text,
#         prompt_wav=<prompt_wav_path>,
#         prompt_text=<prompt_wav_text>,
#     )
#     torchaudio.save(str(i) + ".wav", audio.cpu(), 24000)
总 结
在 TTS 领域,我们已经见过不少「单人语音合成」的突破,而FireRedTTS-2更进一步,专注在「多人对话」这个细分场景。
它不仅能让声音更自然,还能把「语音内容制作」这件事,从单人朗读拓展到「多人播客、实时客服、跨语种对话」等全新应用领域。
