
 语音小管家
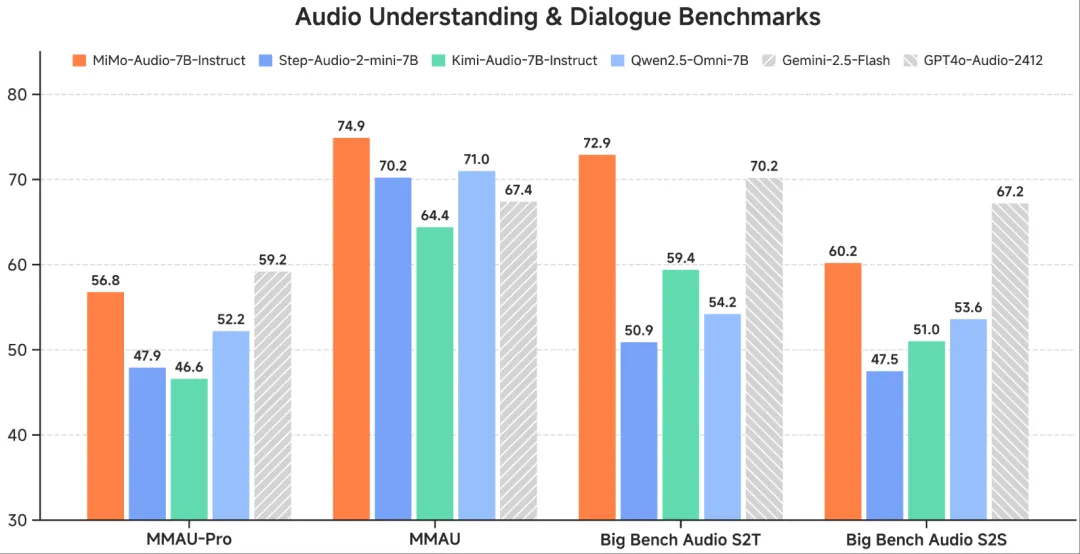
Xiaomi-MiMo-Audio 主要贡献如下:
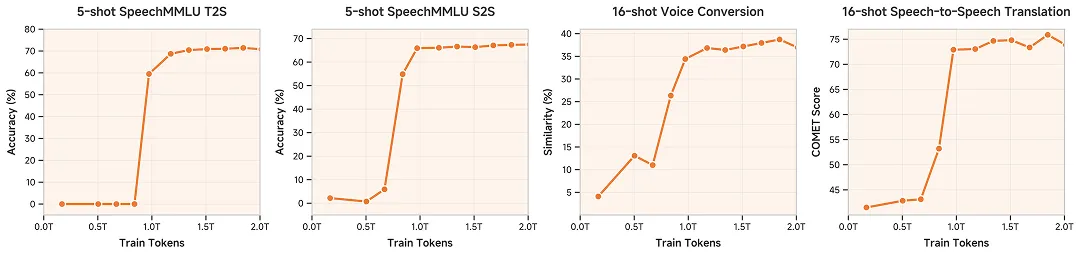
首次证明把语音无损压缩预训练 Scaling 至 1 亿小时可以“涌现”出跨任务的泛化性,表现为 Few-Shot Learning 能力,见证语音领域的 “GPT-3 时刻”
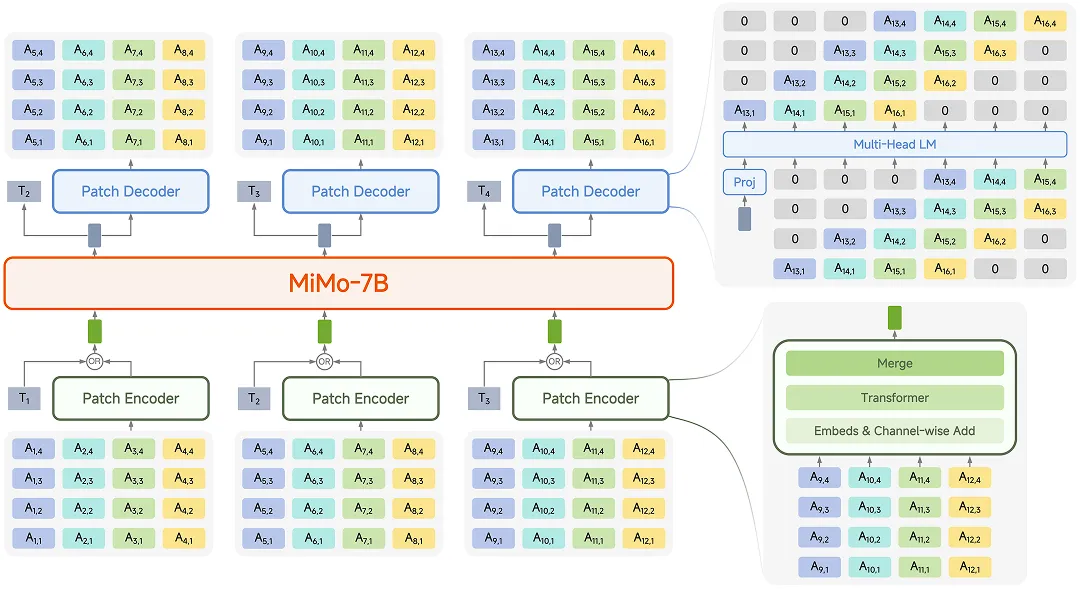
首个明确语音生成式预训练的目标和定义,并开源一套完整的语音预训练方案,包括无损压缩的 Tokenizer、全新模型结构、训练方法和评测体系,开启语音领域的“LLaMA 时刻”
首个把 Thinking 同时引入语音理解和语音生成过程中的开源模型,支持混合思考
技术、模型、评估均开源
模型
预训练模型MiMo-Audio-7B-Base:是目前开源领域第一个有语音续写能力的语音模型
https://huggingface.co/XiaomiMiMo/MiMo-Audio-7B-Base
指令微调模型MiMo-Audio-7B-Instruct:经过轻量级的 SFT,7B 参数规模最强语音理解和生成模型
https://huggingface.co/XiaomiMiMo/MiMo-Audio-7B-Instruct
MiMo-Audio-7B-Instruct 可通过 prompt 切换 non-thinking、thinking 两种模式,强化学习(RL)起点高、潜力足,可以作为研究语音 RL 和 Agentic 训练的全新基座模型。
Tokenizer
开源了 MiMo-Audio 的 Tokenizer 模型:
1.2B 参数量,Transformer 架构,兼顾效率与性能
从头开始训练,覆盖超过千万小时语音数据
同时支持音频重建任务和音频转文本(A2T)任务
Tokenizer 高效实现的推理代码如下:
技术报告
MiMo-Audio 技术报告已公开,全面展示了模型和训练细节:
https://github.com/XiaomiMiMo/MiMo-Audio/blob/main/MiMo-Audio-Technical-Report.pdf
评估框架
提供了一套完整的语音模型预训练 ICL 测评、后训练评估框架,支持 10+ 测评任务,已开源至 GitHub。
