
 语音小管家
在最新发表在Nature上的一项研究中,特温特大学(University of Twente)与 IBM Research Europe、丰田汽车欧洲公司(Toyota Motor Europe)合作,提出了一种新型“物理计算”语音识别方法。这项工作由 Wilfred van der Wiel 教授及其同事主导,展示了如何通过材料本身的物理特性来实现语音处理,而无需依赖高功耗处理器或复杂的软件堆栈。
随着物联网、自动驾驶和个性化医疗等应用的发展,边缘设备(edge devices)对低功耗、低延迟的本地信号处理需求不断增加。然而,传统的语音识别系统依赖数字处理链:声音信号需要经历模数转换、傅里叶变换及复杂的特征提取,再交由大型神经网络分类。这一过程受制于冯·诺依曼瓶颈以及多重域转换,难以在低功耗条件下于边缘端高效运行。
方法与架构
研究团队提出的解决方案是结合两类新兴的物理计算硬件:
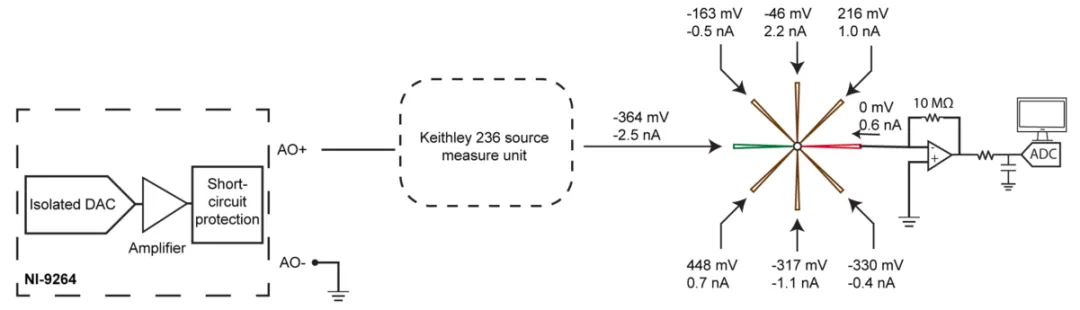
1.可重构非线性处理单元(Reconfigurable Nonlinear Processing Unit, RNPU)
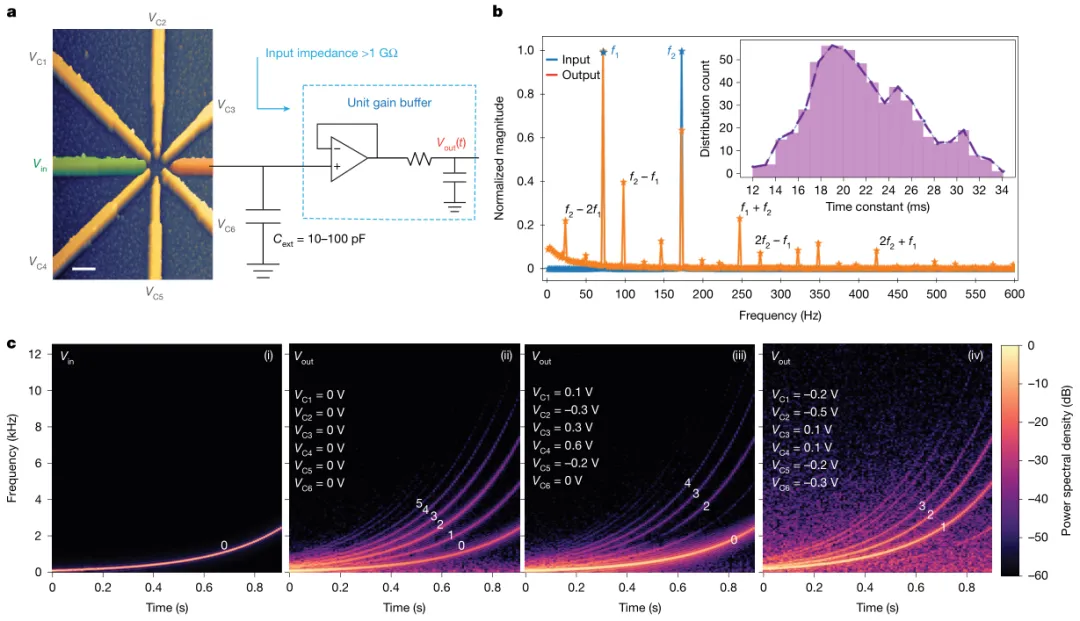
RNPU 室温下的可调非线性与短时记忆表征图。图片来源:Adapted from Zolfagharinejad, M., et al. (2025). Analogue speech recognition based on physical computing. Nature.https://doi.org/10.1038/s41586-025-09501-1. Fig.2
灵感来源于人耳耳蜗,能够在模拟电路中直接对时域信号进行非线性分解与压缩。
通过掺杂硅结构形成的复杂能量景观和电荷传输机制,使其表现出频率选择性、压缩非线性与短时记忆特性。
在毫秒尺度上可实现类似耳蜗毛细胞的动态响应,将原始音频信号转化为低维度但信息丰富的特征表示。
每次推理仅消耗约300 nJ,远低于数字滤波器或神经网络前端处理所需的能量
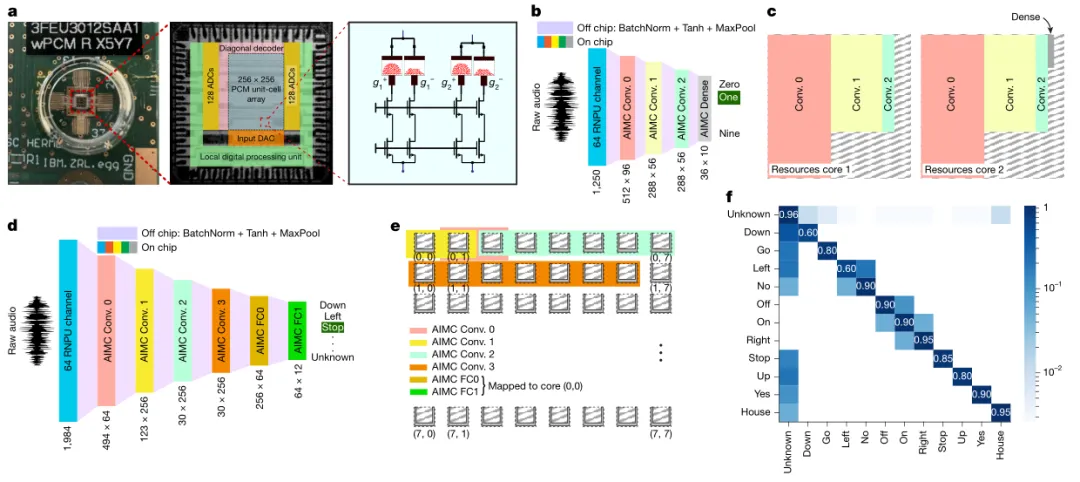
基于 IBM “HERMES” 项目的相变存储器(PCM)交叉阵列,能够在存储阵列中直接执行矩阵–向量乘法,从而避免传统处理器频繁的存取开销。
在实验中被用于实现卷积神经网络(CNN)分类器,承担语音识别中的后端分类任务。
单次推理的能耗约78 µJ,延迟小于0.35 毫秒,未来优化后有望降至 10 µJ 的级别。
TI-46-Word 数据集(口语数字识别):全硬件系统达到96.2%的准确率,仅比软件 CNN 模型低约 2 个百分点。
Google Speech Commands(关键词识别):实现89.3%的准确率,接近全软件系统的92.4%水平,若采用带 Swish 激活函数的 6 层 CNN,RNPU 预处理后准确率可提升至 93.1%,且计算量减少一半以上。
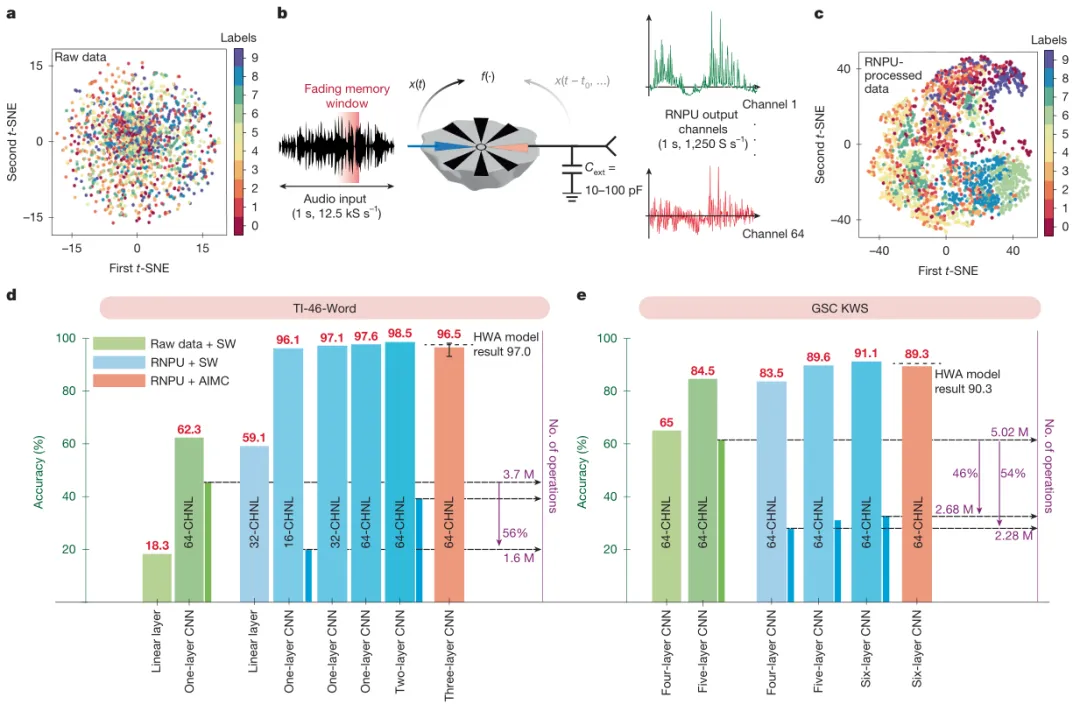
在系统级别的评估中,RNPU 与 AIMC 结合的架构在能效上大幅优于当前主流数字方案:
能效:RNPU单通道静态功耗仅 1.9 nW,64 通道并行也仅需 320 nW;单次特征提取推理能耗约 300 nJ,远低于数字滤波器或神经网络前端处理所需能量。
面积:每个 RNPU 通道仅占约 1 µm² 硅面积,远小于传统 CMOS 滤波电路。
延迟:RNPU 实时运行,不引入额外延迟,AIMC 分类器延迟不足 0.5 毫秒。
系统指标:整体能量–延迟乘积比现有 22 nm 工艺的语音识别专用芯片高效约 8.5 倍。
研究人员指出,这一方法不仅适用于语音识别,还可推广至其他时序信号处理任务,包括视频流分析、心电与脑电信号分类以及环境传感器数据处理等。目前 RNPU 与 AIMC 仍处于分立器件阶段,未来可通过异质集成实现更高程度的硬件整合。
总 结
该研究展示了一种基于物理计算的新型语音识别架构,结合了模拟特征提取与存内分类。在保持较高识别准确率的同时,显著降低了功耗与延迟,为边缘设备的高效时序信号处理提供了一条新的途径。
