
 语音小管家
SongBloom 是一款聚焦歌曲生成的创新模型,只需输入 10 秒参考样本与对应歌词,即可生成双通道/48kHz, 2 分 30 秒的完整歌曲。
开源地址:https://github.com/tencent-ailab/SongBloom
论文链接:https://arxiv.org/abs/2506.07634
Demo:https://cypress-yang.github.io/SongBloom_demo
在主客观双重评测中,SongBloom 不仅全面超越现有开源模型,更在音频质量与歌词准确性两大核心维度上取得了非常优秀的效果;同时在音乐性表现上,也达到了接近领域最佳水平(SOTA)的高度。以下是模型的生成效果。
SongBloom 两大技术创新:
1、首次将自回归扩散模型引入长时歌曲生成任务。模型以离散的 sketch token 作为 “链式思维” 式中间提示,结合 VAE latent(变分自编码器潜在空间)输出最终结果 —— 这一设计既完整保留了自回归模型在结构连贯性、音素对齐上的优势,又充分发挥了扩散模型在连续特征生成中对音质的提升作用,最终实现 “结构稳、细节满、表现力强” 的歌曲生成效果。
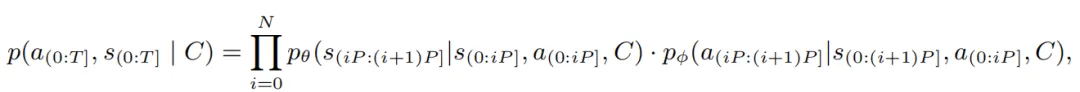
2、提出交替生成范式(interleaved generation)。该范式可在 “语义 - 声学” 两类上下文间动态切换,既能把控歌曲整体结构逻辑,又能精细优化局部音质表现。
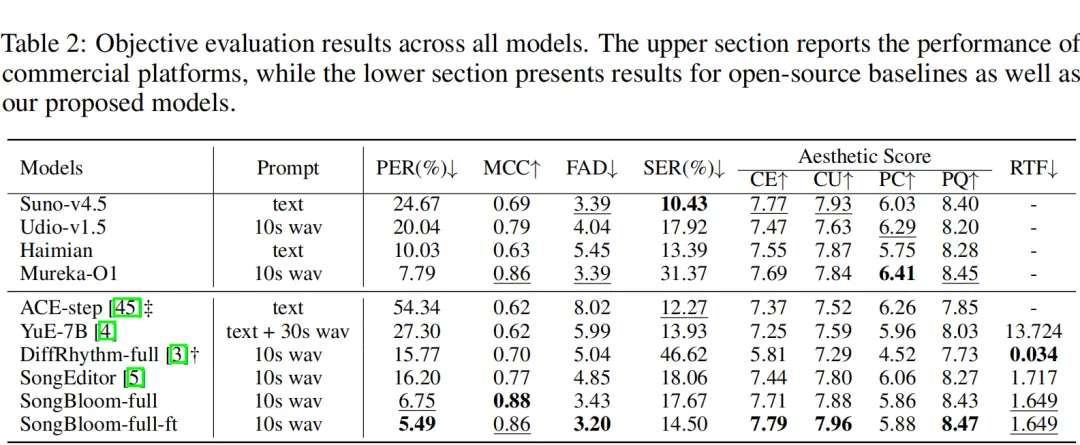
在客观指标层面,SongBloom 的美学评分不仅远超开源基线模型,更与顶尖商用模型 持平甚至实现超越;同时,模型具备极强的歌词 follow 能力,大幅减少 “幻觉生成”(生成内容与歌词不匹配)现象,显著降低了音素错误率(PER),让歌词准确性达到行业新高度。
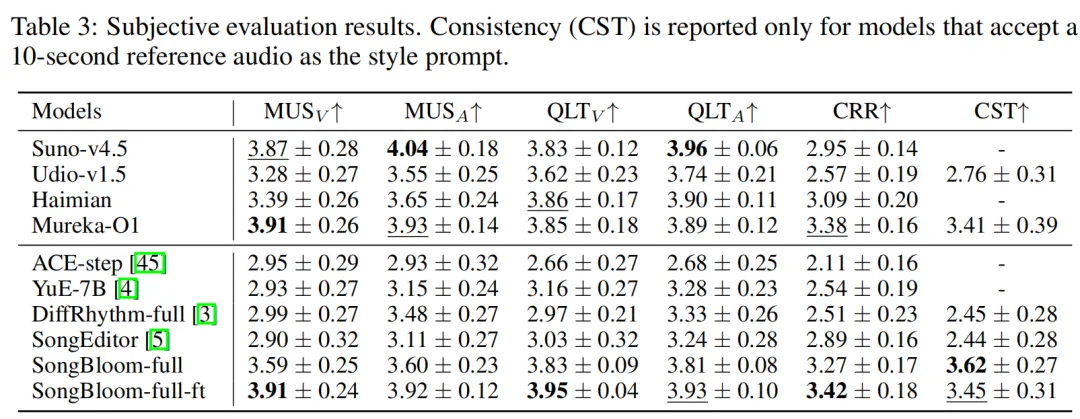
 在主观听感评测中,SongBloom 的表现同样惊艳。得益于 VAE latent 保留的丰富声学细节,其人声音质细腻度直接超越目前顶尖闭源商业模型 Suno-v4.5;而在音乐性上,也达到了媲美甚至超越部分闭源商业模型的水平,让 “AI 生成音乐” 更贴近专业创作质感。
目前相关代码及模型权重已开源。此外,相应的完整240s版本以及文本控制模型也将在后续发布。
