语音小管家
2025年第二十届全国人机语音通讯学术会议(National Conference on Man-Machine Speech Communication,NCMMSC2025)将于2025年10月16~19日在江苏镇江召开。本次会议由中国中文信息学会和中国计算机学会联合主办,由中国中文信息学会语音信息专委会、中国计算机学会语音对话与听觉专委会、江苏大学以及镇江市计算机学会联合承办,会议同时为中国中文信息学会语音信息专委会和中国计算机学会语音对话与听觉专委会的学术年会。
更多会议信息请见会议网站:http://www.ncmmsc.org.cn/
本次会议的主题是“智能语音赋能未来”,大会除了邀请国内外著名学者进行大会报告和教程报告之外,还将举行青年学者论坛、学生论坛、企业论坛、产品和技术展示等活动。除主会外,将组织科普教育活动、基金申请经验交流活动以及多个特殊议题(Special Sessions)。会议吸引众多国内外从事语音、语言科学与技术相关行业的学者、企事业单位以及公司参与,共同促进我国语音、语言科学与技术的不断创新和发展。
⏩NO.1 Ideal-LLM: Integrating Dual Encoders and Language-Adapted LLM for Multilingual Speech-to-Text
作者列表:薛鸿飞、任伟、耿雪龙、魏坤、李龙豪、邵琪杰、杨林举、刁楷、谢磊
论文摘要:通过连接器将音频编码器与大语言模型(LLM)相结合,已能让这类模型处理并理解音频模态,显著提升语音转文本任务(包括自动语音识别(ASR)和自动语音翻译(AST))的性能。然而,这些方法在多语言场景中往往忽视了语言适配这一关键问题,仅依赖多语言数据,却未充分解决语言差异带来的挑战。为填补这一空白,本文提出 Ideal-LLM 模型:该模型采用双多语言编码器以丰富语言特征信息,并利用语言适配连接器实现对每种语言的针对性适配。通过充分发挥 Whisper 与 MMS 两种编码器的互补优势,本文方法可获得更丰富的多语言表征;此外,语言适配连接器还通过为每种语言定制的语言权重选择器,进一步优化模态转换效果。实验结果表明,Ideal-LLM 能显著提升 ASR 性能 —— 与标准语音编码器结合 LLM 的方案相比,其平均词错误率(WER)相对降低 32.6%;在 AST 任务中,该模型的平均 BLEU 值达 36.78。
论文地址:https://arxiv.org/abs/2409.11214
⏩NO.2 StreamFlow: Streaming Flow Matching with Block-wise Guided Attention Mask for Speech Token Decoding
作者列表:郭大可、姚继珣、马林涵、王贺、谢磊
论文摘要:在基于离散令牌的语音生成领域,最新研究进展凸显了 “令牌到波形” 生成环节对音频质量的关键作用,这一点在实时交互场景中尤为重要。传统框架将语义令牌与流匹配(FM)相结合,但其对全局感受野的依赖导致流式处理能力受限;此外,直接采用 “逐令牌” 的流式语音生成方式,往往会造成音频质量下降。为解决这些挑战,我们提出了一种名为 StreamFlow 的新型神经架构,该架构可通过扩散 Transformer(DiT)实现流式流匹配。针对长历史依赖引发的长序列外推问题,我们设计了一种局部块级感受野策略:首先将序列分割为多个块,随后引入块级注意力掩码,使当前块能够接收前一个或后一个块的信息。这些注意力掩码在不同 DiT 块间进行层级组合,从而实现对 DiT 感受野的有效调控。主观与客观实验结果均表明,该方法在语音质量上不仅能达到非流式方法的性能水平,还超越了其他流式方法,同时在长序列生成过程中可有效控制推理时间。此外,在不做工程优化的情况下,我们的首包延迟仅为 180 毫秒。
论文地址:https://arxiv.org/pdf/2506.23986
⏩NO.3 HiStyle: Hierarchical Style Embedding Prediction for Text-Prompt-Guided Controllable Speech Synthesis
作者列表:张子萸、李函昭 、胡景斌、李文豪、谢磊
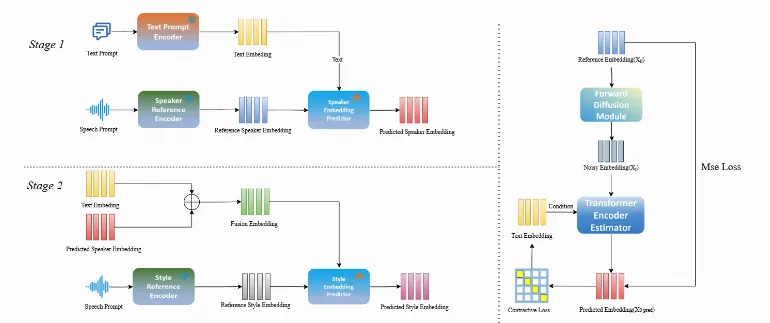
论文摘要:可控语音合成指通过操纵特定韵律和副语言属性(如性别、音量、语速、音高和音高波动)来精确控制语音风格。随着先进生成模型(特别是大语言模型和扩散模型)的整合,可控文本转语音(TTS)系统已逐渐从基于标签的控制转向基于自然语言描述的控制,这通常通过从文本提示预测全局风格嵌入来实现。然而,这种直接预测忽略了风格嵌入的潜在分布,这可能限制可控TTS系统的全部潜力。在本研究中,我们使用t-SNE分析来可视化和分析各种主流TTS系统的全局风格嵌入分布,揭示了一个清晰的分层聚类模式:嵌入首先按音色聚类,随后根据风格属性细分为更精细的簇。基于这一观察,我们提出了HiStyle,一个两阶段风格嵌入预测器,能够根据文本提示分层预测风格嵌入,并进一步引入对比学习以帮助对齐文本和音频嵌入空间。此外,我们提出了一种风格标注策略,利用统计方法和人类听觉偏好的互补优势,生成更准确和感知一致的文本提示用于风格控制。综合实验表明,当应用于基础TTS模型时,HiStyle在保持高语音质量(自然度和清晰度)的同时,实现了比替代风格嵌入预测方法显著更好的风格可控性。
音频样本获取:https://anonymous.4open.science/w/HiStyle-2517
论文地址:https://arxiv.org/abs/2509.25842
⏩NO.4 MPO: Multidimensional Preference Optimization for Language Model-based Text-to-Speech
作者列表:夏康翔、朱新发、姚继珣、谢磊
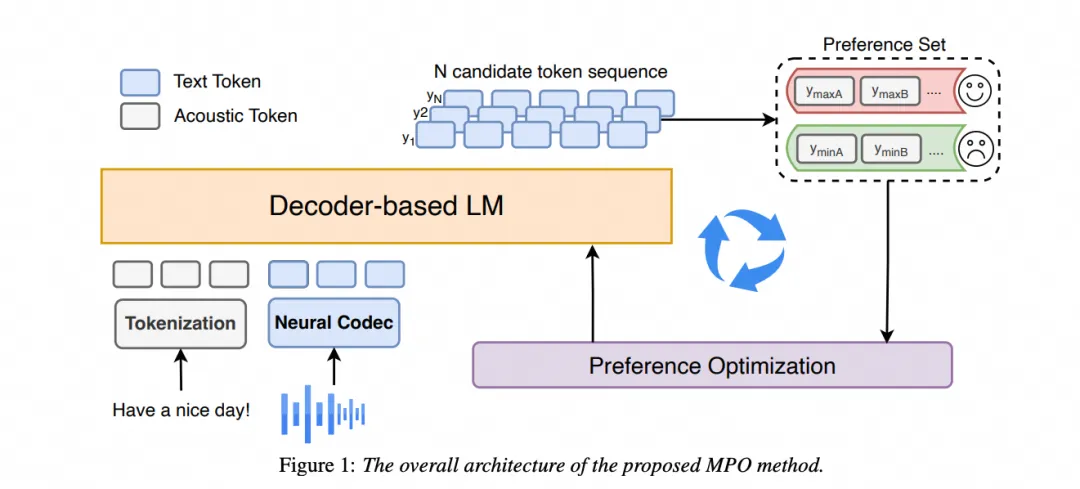
论文摘要:近年来,基于大语言模型的文本转语音(TTS)技术取得了显著进步,语音质量已接近人耳水平。引入人类反馈已被证明是提升TTS系统鲁棒性的有效方法。然而,现有的方法在利用多维度偏好数据优化TTS系统时存在诸多挑战,并且由于过度依赖奖励机制,性能容易下降。为此,我们提出了一种多维度偏好优化(MPO)方法,旨在更好地将TTS系统与人类偏好相匹配。MPO引入了一个偏好集,简化了多维度偏好优化数据构建过程,从而实现多维度偏好的匹配。此外,我们在训练过程中引入正则化技术,以解决基于偏好优化的方法中常见的性能下降问题。实验结果表明,与基线系统相比,MPO在语音清晰度、说话人相似度和语调等方面均有显著提升,充分证明了其有效性。
论文地址:https://arxiv.org/abs/2509.00685
⏩NO.5 SynthVC: Leveraging Synthetic Data for End-to-End Low Latency Streaming Voice Conversion
作者列表:郭钊、宁子谦、马国斌、谢磊
论文摘要:语音转换(Voice Conversion, VC)旨在在保留语言内容的同时,修改说话人的音色。尽管最新的VC模型在性能上表现优异,但大多数模型在实时流式场景下仍面临诸如高延迟、依赖语音识别(ASR)模块或复杂的说话人解耦等问题,这常常导致音色泄露或自然度下降。我们提出了SynthVC,一种流式端到端VC框架,通过预训练的零样本VC模型生成的合成并行数据,直接学习说话人的音色变换。该设计无需显式的内容-说话人分离或识别模块。在神经音频编解码器架构基础上,SynthVC支持低延迟的流式推理,并具备高输出音质。实验结果显示,SynthVC在自然度和说话人相似度方面均优于基线流式VC系统,实现了仅77.1毫秒的端到端延迟。
论文地址:https://arxiv.org/abs/2510.09245
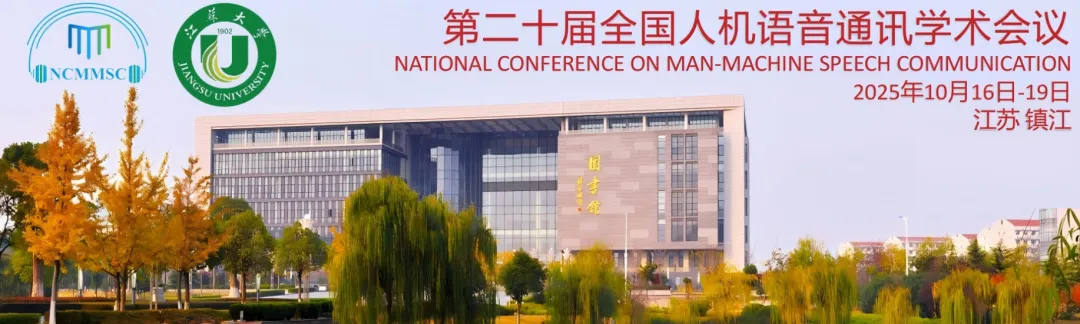
⏩NO.6 Serial-Parallel Dual-Path Architecture for Speaking Style Recognition
作者列表:李国健、邵琪杰、赵致闲、王水源、付中华、谢磊
论文摘要:说话风格识别(Speaking Style Recognition,SSR)旨在从语音中识别说话者的说话风格特征。现有的风格识别方法主要依赖语言信息,对声学信息的融合较少,从而限制了识别精度的提升。声学与语言模态的融合具有显著潜力,可进一步增强识别性能。本文提出了一种新颖的串行-并行双路径架构,用于利用声学-语言双模态信息进行SSR。串行路径遵循ASR+STYLE的串行范式,体现了顺序性的时间依赖关系;并行路径则集成了我们设计的声学-语言相似性模块(Acoustic-Linguistic Similarity Module,ALSM),以实现具有时间同步性的跨模态交互。与现有的SSR基线——OSUM模型相比,我们的方法在参数规模上减少了88.4%,并在测试集八种风格的识别精度上提升了30.3%。