
 语音小管家
全长度歌曲生成(Lyrics-to-Song Generation)任务的目标是根据输入的歌词和风格提示生成一首完整的歌曲,包括人声和伴奏。该任务涵盖了歌声合成、歌词建模和音乐生成,挑战性极大。近年来,随着深度生成模型的发展,歌词驱动的歌曲生成已有显著进展,例如基于扩散模型的 DiffRhythm 已能够在秒级别生成完整歌曲。然而,现有方法在实际应用中依然存在许多不足之处,如训练数据分布不均导致不同语言歌曲质量差异明显,风格控制的灵活性不足,以及生成质量和音乐表现力不稳定等问题。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)的论文 “DiffRhythm+: Controllable and Flexible Full-Length Song Generation with Preference Optimization” 被语音旗舰会议 ASRU 2025 接收。该论文在 DiffRhythm 的基础上进行了重要改进,提出了升级版的 DiffRhythm+。通过引入大规模均衡数据集、多模态风格控制和偏好优化机制,DiffRhythm+ 显著提升了全歌曲生成的质量、灵活性和听感表现。在多项主观与客观评测中,DiffRhythm+ 相较于 DiffRhythm 以及其它基线系统表现出显著的提升,并且在生成效率方面远超同类大规模模型系统。
论文题目:DiffRhythm+: Controllable and Flexible Full-Length Song Generation with Preference Optimization
作者列表:陈华康,姜月鹏,马国斌,郝春博,王帅,姚继珣,宁子谦,孟猛,栾剑,谢磊
论文网址:https://arxiv.org/abs/2507.12890
开源仓库:https://github.com/ASLP-lab/DiffRhythm
歌曲作为人类文化与情感表达的重要载体,传统上需要具备丰富的音乐知识与创作能力才能完成。然而,随着深度生成模型的发展,歌词到歌曲(Lyrics-to-Song)的自动生成逐渐成为可能。现有的方法主要可以分为基于语言模型和基于扩散模型两大类。语言模型在建模复杂结构和多模态条件下表现出色,但推理速度较慢,限制了其在实时交互中的应用。而扩散模型在生成音频的保真度和控制灵活性方面具有优势,尤其适用于长时音乐的生成。
尽管如此,现有的代表性工作,如 DiffRhythm [1],在中文歌曲生成质量、音乐复杂度以及风格控制的灵活性方面仍然存在不足。其训练数据偏向英语歌曲,导致中英文表现差异明显;同时,其风格提示依赖单一音频,缺乏更自由的创作空间和更精准的风格控制。
10秒生成4分钟音乐,8GB显存就能跑!已登Hugging Face趋势榜一
为了解决这些问题,我们提出了 DiffRhythm+,通过在数据规模与均衡性、风格控制灵活性以及偏好对齐等方面进行系统性改进,显著提升了生成音乐的自然度、复杂性以及创作自由度,使得歌词到歌曲的自动生成更具灵活性与表现力。
如图1所示,DiffRhythm+ 采用基于 VAE 与扩散 Transformer (DiT) 的生成框架。首先,VAE 模块将音频映射到潜在空间,再通过 DiT 在条件输入下对潜在分布进行建模并重建为歌曲。在数据层面,模型使用了十二万小时的大规模均衡语料,涵盖中文、英文歌曲及器乐,并通过 SongEval [2] 与 Audiobox [3] 等美学评价工具筛选,最终得到两万五千小时高质量数据用于训练,从而缓解了歌词重复或遗漏问题,并显著提升了跨语言表现。在风格控制方面,DiffRhythm+ 引入 MuLan [4] 跨模态风格提取器,使模型能够同时接受文本和音频作为提示,用户既可以通过自然语言描述风格,也可以提供音频样例,实现更细粒度和更灵活的风格控制。在优化机制上,DiffRhythm+ 融合了直接偏好优化(DPO [5]),利用美学模型生成的“优胜—劣败”对作为训练数据,使模型输出与人类偏好更一致。DPO 阶段在监督微调基础上进行,进一步增强了生成音乐的自然性、编排复杂度与主观满意度。
SongEval 驱动歌曲生成优化:DiffRhythm 1.2 正式发布
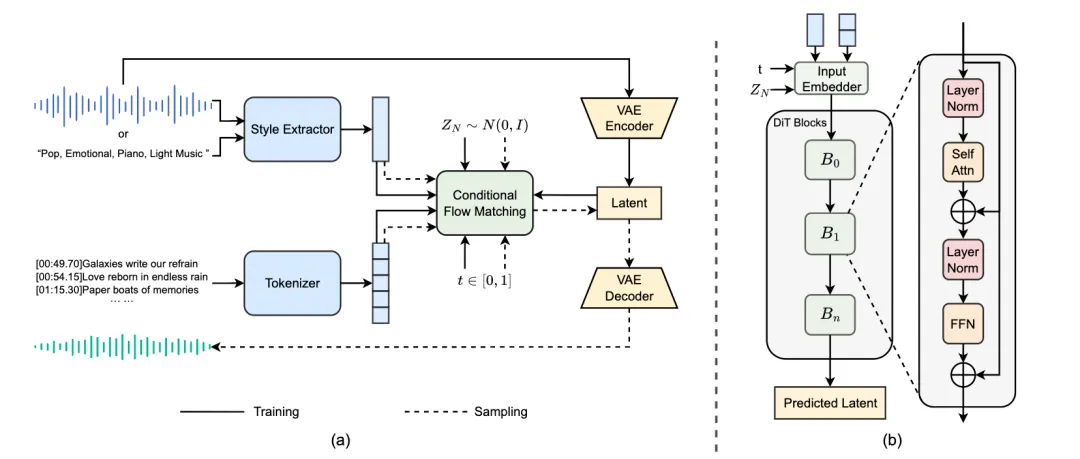
图1 DiffRhythm+ 模型结构
实验数据:为了训练 DiffRhythm+,我们首先收集了来自互联网的 300,000 小时原始音乐录音,并应用基于规则的过滤管道。经过处理,生成了包含约 120,000 小时的高质量音乐数据集,涵盖中文歌曲、英文歌曲和器乐曲,比例为 2:2:1。为进一步提高生成质量,使用 Audiobox-aesthetic 和 SongEval 进行音频质量过滤,并选择了一小部分高质量数据进行监督式微调(SFT)。
对比系统
SongLM [6]:采用一个两阶段的方法,结合自回归语言模型生成离散语义 tokens,并利用扩散模型重建音乐。
YuE [7]:是一个针对歌词到歌曲生成的双语言模型框架,分为两个阶段:首先进行与音轨解耦的next token prediction,再进行残差建模以精确重建音频。
DiffRhythm:引入了基于潜在扩散模型的方案,专注于全长度歌曲的快速非自回归生成,通过 DiT 模块对歌词内容和风格提示进行条件化。
主观测试
我们通过主观听感测试评估 DiffRhythm+ 的生成效果,测试项目包括三个核心音乐方面:可懂度、音乐性和质量。每个模型生成的歌曲样本由30位听众进行评分,评分范围为1到5。如图2所示,DiffRhythm+ 在多个方面表现超越了 DiffRhythm,并且与 YuE 相当,特别是在可懂度和音质上有显著改善。
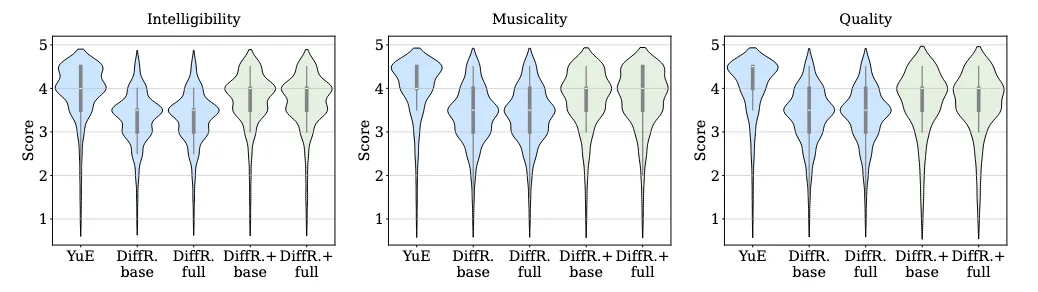
图2 主观测试结果 (MOS)
客观测试
在表1中,我们列出了 DiffRhythm+ 与基准系统的多个客观评测指标。DiffRhythm+ 在 FAD 和 KL 散度等分布匹配指标上显著优于 DiffRhythm,在 PER(词误差率)上也取得了最低值。与 YuE 相比,DiffRhythm+ 的 RTF(实时因子)表现出色,显示出其在快速和高效生成歌曲方面的潜力。
表1 客观评价指标对比
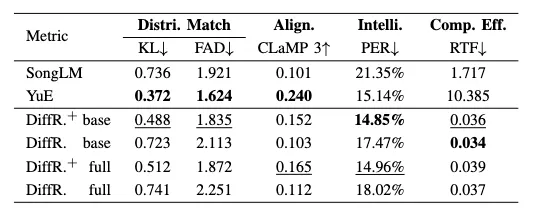
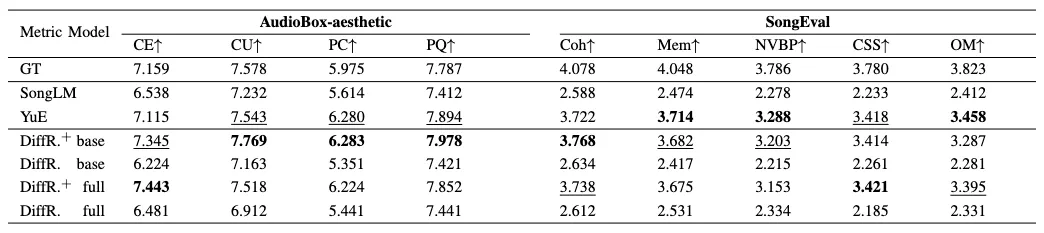
表2展示了基于 SongEval 和 Audiobox-aesthetic 的音乐质量评分。DiffRhythm+ 在这两项指标上均表现出色,在结构性和自然性方面接近 YuE,尤其在 Coh(连贯性)上获得了最佳评分。
表2 美学评价指标对比
[1] Ziqian Ning, Huakang Chen, Yuepeng Jiang, Chunbo Hao, Guobin Ma, Shuai Wang, Jixun Yao, and Lei Xie, “Diffrhythm: Blazingly fast and embarrassingly simple end-to-end full-length song generation with latent diffusion,” arXiv preprint arXiv:2503.01183, 2025.
[2] Jixun Yao, Guobin Ma, Huixin Xue, Huakang Chen, Chunbo Hao, Yuepeng Jiang, Haohe Liu, Ruibin Yuan, Jin Xu, Wei Xue, et al., “Songeval: A benchmark dataset for song aesthetics evaluation,” arXiv preprint arXiv:2505.10793, 2025.
[3] Apoorv Vyas, Bowen Shi, Matthew Le, Andros Tjandra, Yi-Chiao Wu, Baishan Guo, Jiemin Zhang, Xinyue Zhang, Robert Adkins, William Ngan, et al., “Audiobox: Unified audio generation with natural language prompts,” arXiv preprint arXiv:2312.15821, 2023.
[4] Haina Zhu, Yizhi Zhou, Hangting Chen, Jianwei Yu, Ziyang Ma, Rongzhi Gu, Yi Luo, Wei Tan, and Xie Chen, “Muq: Self-supervised music representation learning with mel residual vector quantization,” arXiv preprint arXiv:2501.01108, 2025.
[5] Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, and Chelsea Finn, “Direct preference optimization: Your language model is secretly a reward model,” Advances in Neural Information Processing Systems, vol. 36, pp. 53728–53741, 2023.
[6] Chenyu Yang, Shuai Wang, Hangting Chen, Jianwei Yu, Wei Tan, Rongzhi Gu, Yaoxun Xu, Yizhi Zhou, Haina Zhu, and Haizhou Li, “Songeditor: Adapting zero-shot song generation language model as a multi-task editor,” in Proceedings of the AAAI Conference on Artificial Intelligence, 2025, vol. 39, pp. 25597–25605.
[7] Ruibin Yuan, Hanfeng Lin, Shuyue Guo, Ge Zhang, Jiahao Pan, Yongyi Zang, Haohe Liu, Yiming Liang, Wenye Ma, Xingjian Du, et al., “Yue: Scaling open foundation models for long-form music generation,” arXiv preprint arXiv:2503.08638, 2025.
