语音小管家
UniFlow-Audio: Unified Flow Matching for Audio Generation from Omni-Modalities
作者:徐薛楠¹,梅嘉豪²⁵,郑子豪¹²,陶也¹²,谢泽宇³,张耀匀²,刘濠赫⁴,吴宇宁⁵,严明⁵,吴雯¹,张超¹,吴梦玥²
单位:¹ 上海人工智能实验室 ² 上海交通大学 ³ 北京大学 ⁴ Meta ⁵ 阿里巴巴集团
论文简介:UniFlow-Audio 是一个统一的非自回归的音频生成框架,根据时序对齐特性将音频生成任务分为 time-aligned (TA) 和 non-time-aligned (NTA) 任务,通过 Dual-Fusion 机制将两种任务的输入统一融合到流匹配模型中,从而实现对于各个输入模态、各种任务的统一建模,在7个任务 (TTS、SVS、SE、SR、T2A、T2M、V2A) 上同时取得优异表现,生成质量与任务专用模型相当甚至更优,同时保持高参数效率 (Small 版本仅不到200M可学习参数)。
完整论文:https://arxiv.org/abs/2509.24391
项目主页:https://wsntxxn.github.io/uniflow_audio
非自回归统一音频生成新思路
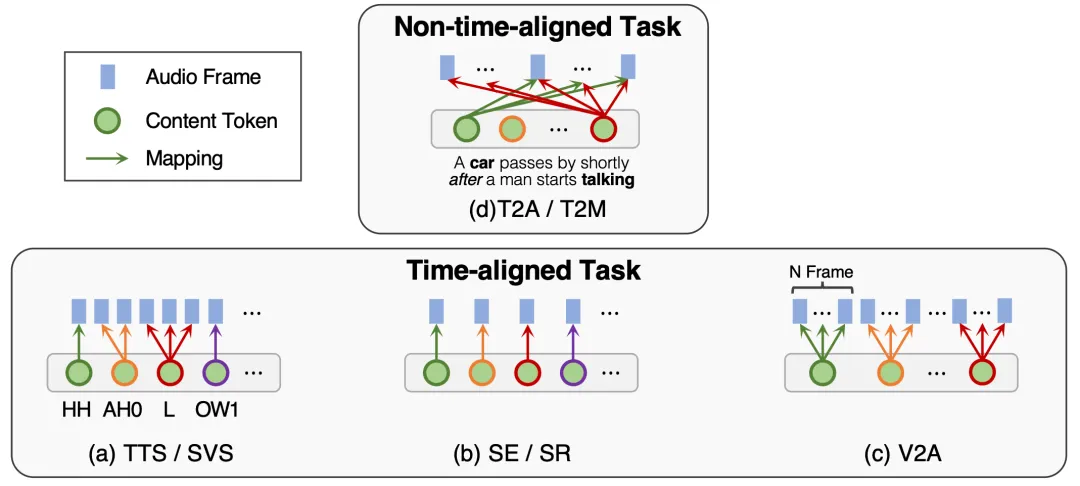
在声音生成领域,我们通常把任务分为两大类:时间对齐 (Time-Aligned, TA) 任务,例如语音合成 (TTS)、语音增强 (SE);以及非时间对齐 (Non-Time-Aligned, NTA) 任务,例如文本到音效、音乐生成 (T2A, T2M) 等。
TA 任务的输入顺序和输出顺序有对齐关系,例如:
TTS 中的强制对齐,一个建模单元对应不固定的多帧语音
SE 中输入的 noisy speech 和输出 clean speech 之间逐帧对齐
video to audio (V2A) 中输入的一个视频帧对应固定多帧音频
NTA 任务输入顺序和输出顺序没有必然的对齐关系,例如:
T2A 任务的 audio caption 中,先出现的词表示的声音可能发生在后,有的虚词在音频中没有对应的部分
传统的非自回归 (NAR) 模型对于这两类任务往往需要不同的架构:
VoiceFlow、Matcha-TTS、E2TTS、F5TTS 等通过 duration expansion 或者 filler token 方式将 TA 任务的输入和输出对齐,但没有在 NTA 任务上进行尝试
AudioLDM、E3TTS、AudioX 等通过 cross attention 方式融入信息,但是只能生成定长的音频
那么,有没有可能用一个模型,同时兼顾 TA 和 NTA 任务,接受不同模态 (文本 / 音频 / 视频) 输入,统一生成语音、音乐或音效?这篇论文给出了答案 ——UniFlow-Audio。
方 法
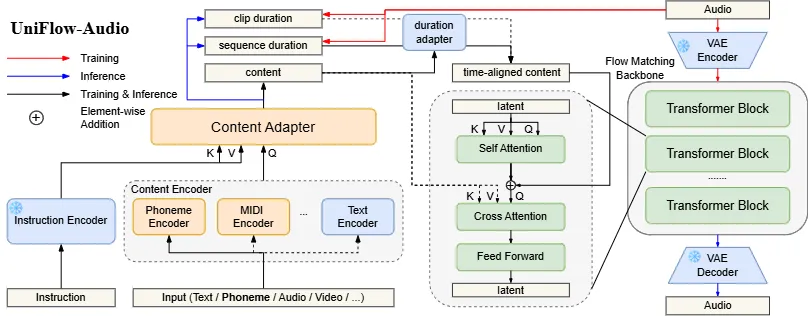
UniFlow-Audio 采用一个统一的流匹配模型统一建模各种音频生成任务。音频通过一个在原始波形上进行压缩和解压缩的 VAE,压缩为 latent,流匹配模型学习基于输入信息生成 latent 的过程。该 VAE 在一系列公开的高质量语音、歌唱、音乐以及一般场景音频数据上进行训练。
输入编码
对于不同类型的输入,该团队采用此前单任务中表现较好的输入编码器:
音素、MIDI:FastSpeech2 中采用的 Transformer 编码器
描述文本:Flan-T5 编码器
音频:复用前面提到的 VAE 编码器
视频:对于每一帧使用 CLIP 编码器
通过以上编码器,各种输入均能得到无损的连续特征。随后,输入特征序列和任务 instruction 之间进行 cross attention 融合,从而将任务目标一并编码。
时长适配器
对于 TTS、SE 这类 TA 任务,需要得到和音频 latent 同样长度的特征从而进行融合;对于 T2A、T2M 这类 NTA 任务,同样需要时长预测器得到目标长度。因此该团队用了一个统一的时长适配器,对于 TA 任务预测输入元素级时长 (如音素时长) 并根据时长做帧扩展,对于 NTA 任务预测段落级时长。
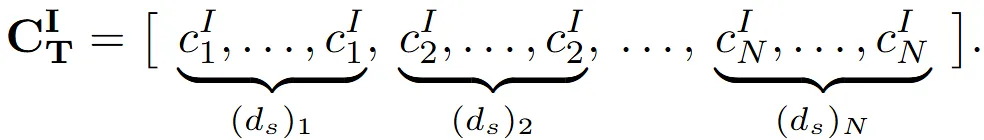
Dual-Fusion 融合机制
多任务统一的最大挑战在于任务的时间对齐差异。UniFlow-Audio 提出Dual-Fusion机制根据任务类型选择合适的融合方式:
TA 任务:latent 和输入特征时间轴对齐,进行逐元素相加;
NTA 任务:cross attention,让模型自由学习非对齐模态与音频帧之间的软对应。
为了避免任务间的互相干扰,模型引入了可学习的 dummy embedding,在某一模态无输入时自动替代,使整体架构在不同任务下保持统一。
最终 UniFlow-Audio 使用流匹配损失、段落级时长损失和元素级时长损失进行训练。
实 验
统一 NAR 框架下的生成效果
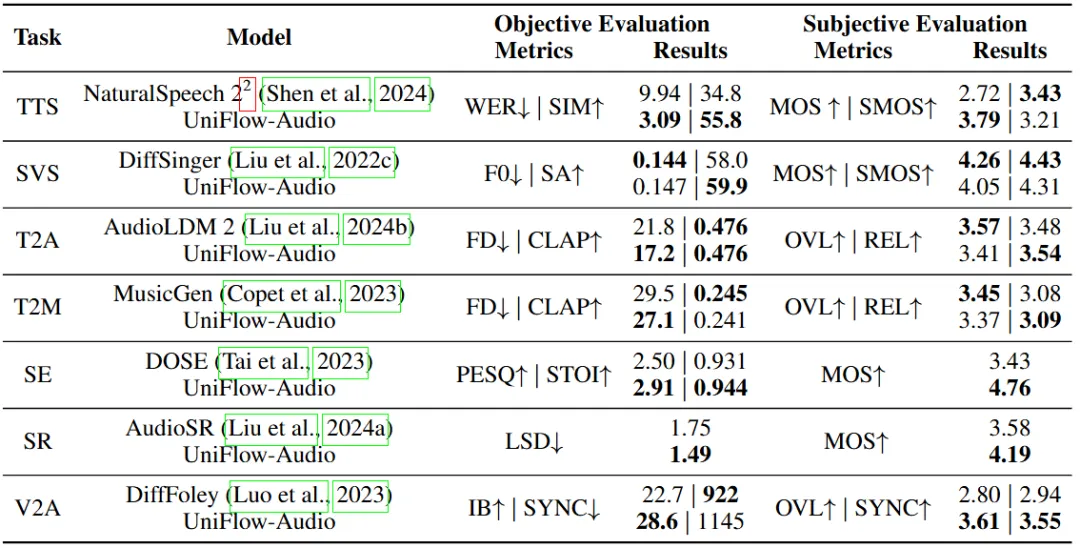
UniFlow-Audio 在各个任务上均表现优异,和任务专用模型相比,取得了相似甚至更好的结果,证明了 UniFlow-Audio 在统一建模上的有效性。特别是在 SE、super resolution (SR) 中,无论主客观指标都体现出和基线模型的优势。
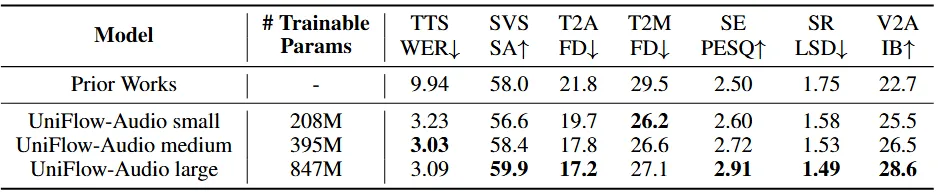
在不同的模型规模下,UniFlow-Audio 均有出色表现。small 版本的模型有 208M 可学习参数,在大部分任务上也取得了比基线任务专用模型更好的效果,展示出极高的参数效率。
CFG 引导和采样步数的作用
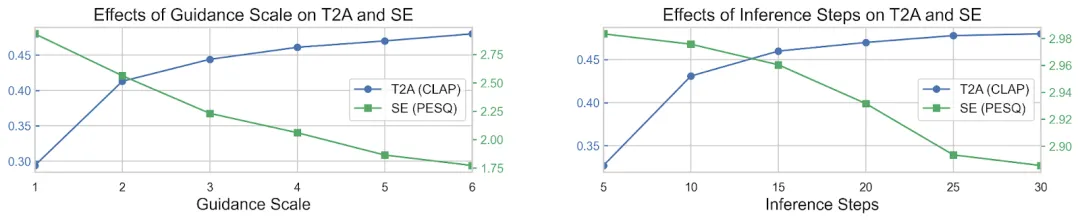
对于 diffusion 和 flow matching 模型,CFG 的引导值和采样步数往往直接影响性能。该团队发现 UniFlow-Audio 的有趣现象:两种类型的任务表现出不一样的趋势:SE 和 SR 任务随着 scale 减小、步数减小效果越来越好,而剩下的任务则表现出相反的趋势。这可能是由于 SE 和 SR 任务只需要保留输入的部分内容,CFG 反而使得噪声被保留下来。
消融实验
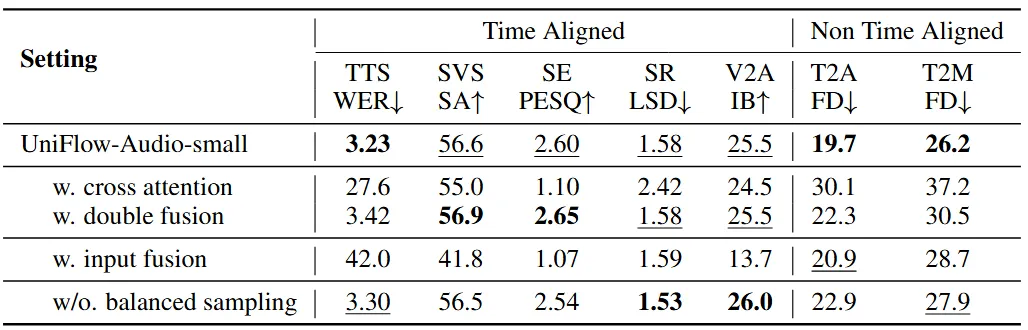
对于 UniFlow-Audio 的关键设计,该团队进行了消融实验:
Dual-Fusion 机制:去掉该机制后,NTA 任务性能显著下降,TA 输入成为了干扰
Block-wise 融合:将每个 block 内融合改为输入处融合,TA 任务性能明显下降,因为 TA 输入只融合一次,而 NTA 输入每层都进行 cross attention
任务平衡采样策略:训练时该团队对各个任务轮流采样数据,并将 T2A 和 T2M 任务上采样,使得两种任务的训练数据比例相同。若取消该采样策略,模型在数量少的 T2M 任务上表现明显下降。