
 语音小管家
大语言模型(LLM)的爆发式发展彻底改变了人工智能的学习与应用范式。如今,这股变革力量又延伸到了语音领域,由西北工业大学、南京大学和WeNet社区研发的WEST(WE Speech Toolkit)正式开源,它以LLM为核心,打通语音识别、合成、理解、对话全流程。
此前,语音领域虽涌现出Fireredasr-llm 、Qwen3-omni、GPT-4o等优秀模型,但对于研究和复现存在一些难度:
多数模型仅开放推理代码或部分模型权重,训练细节、数据无从获取,用户无法复现训练过程,更难进行二次开发; 不同语音任务(如识别、合成)依赖不同框架与数据,模型间兼容性差,想搭建一个多任务语音系统,需手动整合多个工具。
而WEST的出现,正是为了打破这些壁垒,搭建一个语音领域统一的、全栈的、开源的、基于大模型的语音工具包。
关键特性
1. LLM驱动
充分复用成熟的技术生态,让语音任务与LLM生态无缝衔接,降低技术迁移成本:
兼容Hugging Face等平台的开源模型(如LLaMA、QWen、Mistral); 采用Sequence Packing、Flash Attention等LLM训练技术,大幅提升训练效率;
2. 统一数据格式
受文本LLM训练范式的启发,语音大模型的训练通常分为两个阶段:预训练和微调。预训练阶段通常利用大规模数据集,而微调阶段采用较小规模的高质量数据集。为了支持上述两个训练阶段并考虑数据存储和读取效率,我们设计了两种数据格式:
预训练数据格式:此数据包含语音和可选文本标签,且数据量较大,一般为百万级,支持tar/json两种格式。
微调数据格式:使用"role-content"格式,方便支持多轮微调训练,对于语音理解、对话和多轮交互等任务至关重要。
3. 全任务覆盖
支持识别、合成、理解、对话任务,同时具有可扩展性:
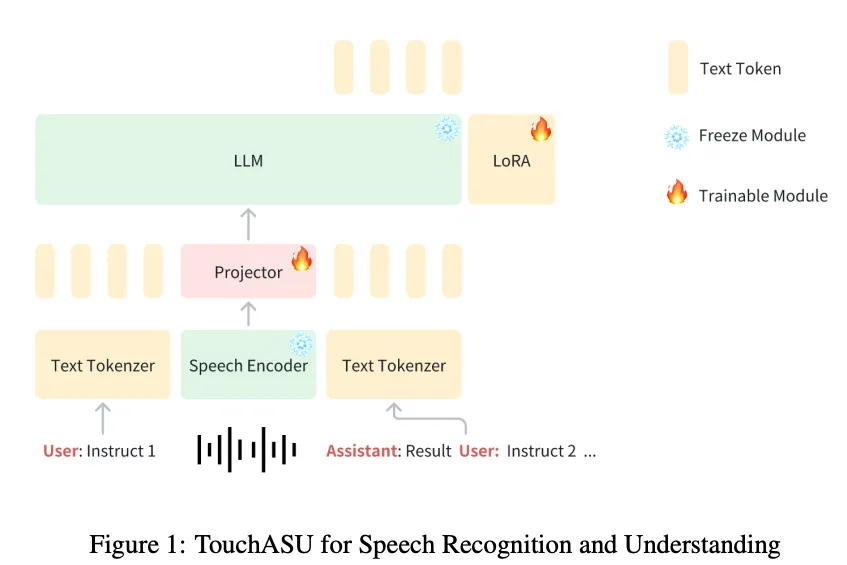
TouchASU:由语音编码器、投影仪和LLM组成。用于支持语音识别、语音理解和语音问答任务。
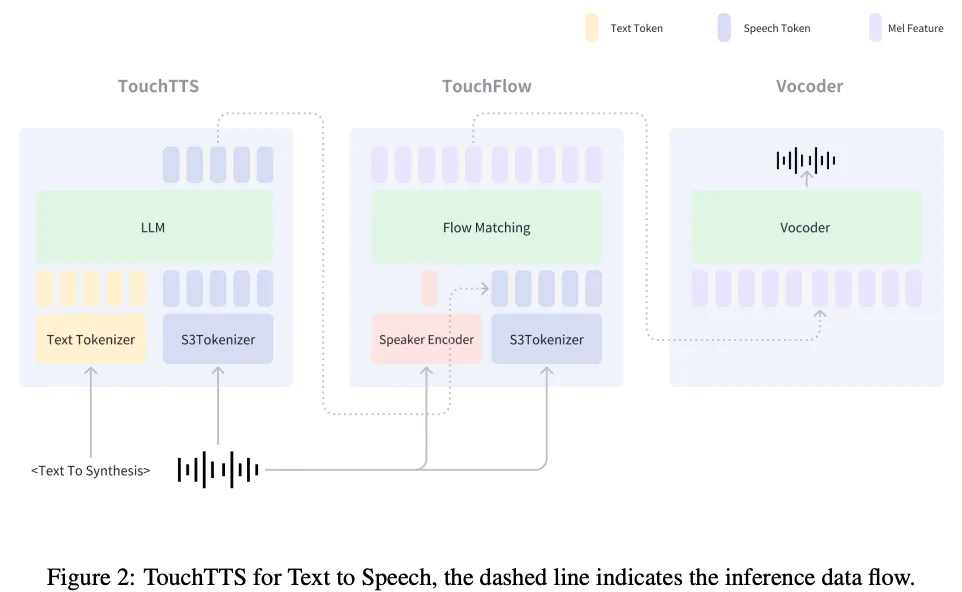
TouchTTS:由TouchTTS、TouchFlow、声码器三部分组成。TouchTTS负责文本到语音token建模,TouchFlow将语音token转化为梅尔谱特征,然后声码器将其转换为音频。
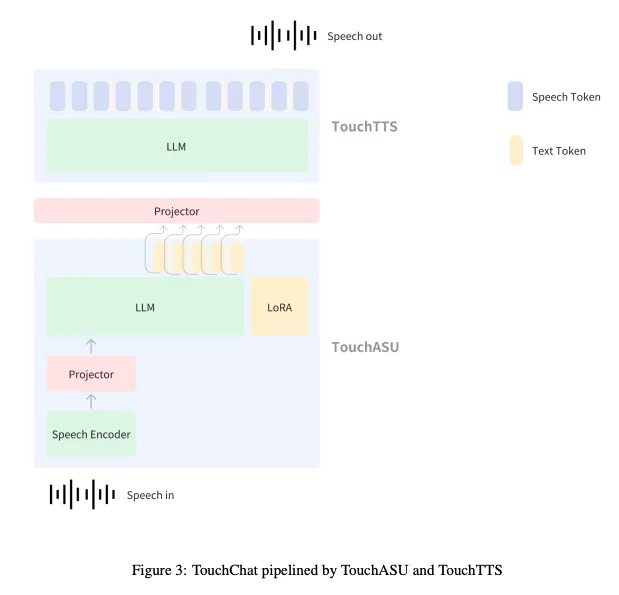
TouchChat:参考Qwen2.5-omni设计,由TouchASU和TouchTTS组成,TouchASU负责理解语音,TouchTTS负责生成语音回复。
可扩展性:支持适配开源模型,目前已支持OSUM-echat;用户也能基于基础组件自定义模型。
实验结果
1. 语音识别
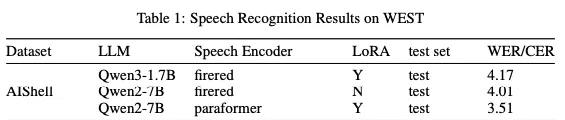
我们给出了Aishell上语音识别的结果,同时对比了不同编码器、LLM以及Lora的结果:
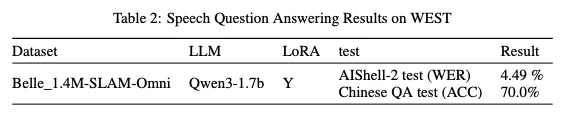
2. 语音问答(S2T)
基于Belle-1.4M-SLAM-omni和aishell2数据集训练,使其同时具备asr 和 QA能力,同时构建了300条中文测试集(Chiese QA)。
3. 语音合成
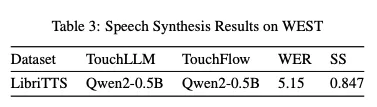
基于LibriTTS数据训练,复用Qwen2.5-0.5B权重,使用Whisper验证WER,wespeaker验证说话人相似度,结果如下:
4.语音对话
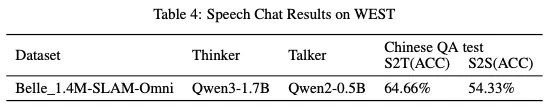
复用TouchASU权重,TouchTTS使用Wenetspeech4TTS训练。然后使用belle_1.4M-SLAM-Omni微调TouchChat,结果如下:
5. 训练效率
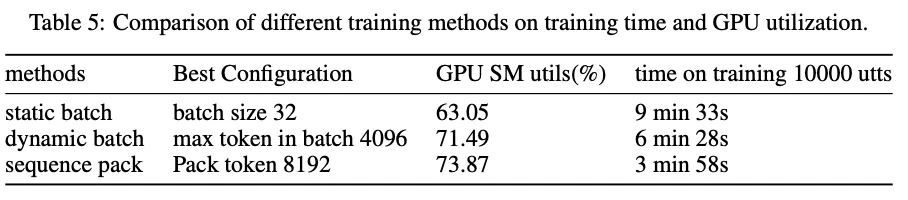
通过sequence packing技术,WEST在处理10000条语音时,比传统静态批处理快2.4倍,GPU利用率提升至73.87%,兼顾效率与稳定性。
未来展望
目前WEST仍在快速迭代,持续优化模型性能、扩展任务类型(如多语言支持、情感语音交互、全双工语音交互),目标是打造语音领域的“标准工具箱”。
如果你关注语音的发展,或是正在寻找高效的语音开发工具,不妨试试WEST——它或许会成为你突破语音技术瓶颈的关键帮手。非常欢迎大家多多使用、多多评论、多多PR,一起推动语音走向下一阶段!
