语音小管家
论文地址:https://dl.acm.org/doi/pdf/10.1145/3746027.3762030
网站地址:https://ai4ai.anonymous-demo.fun/
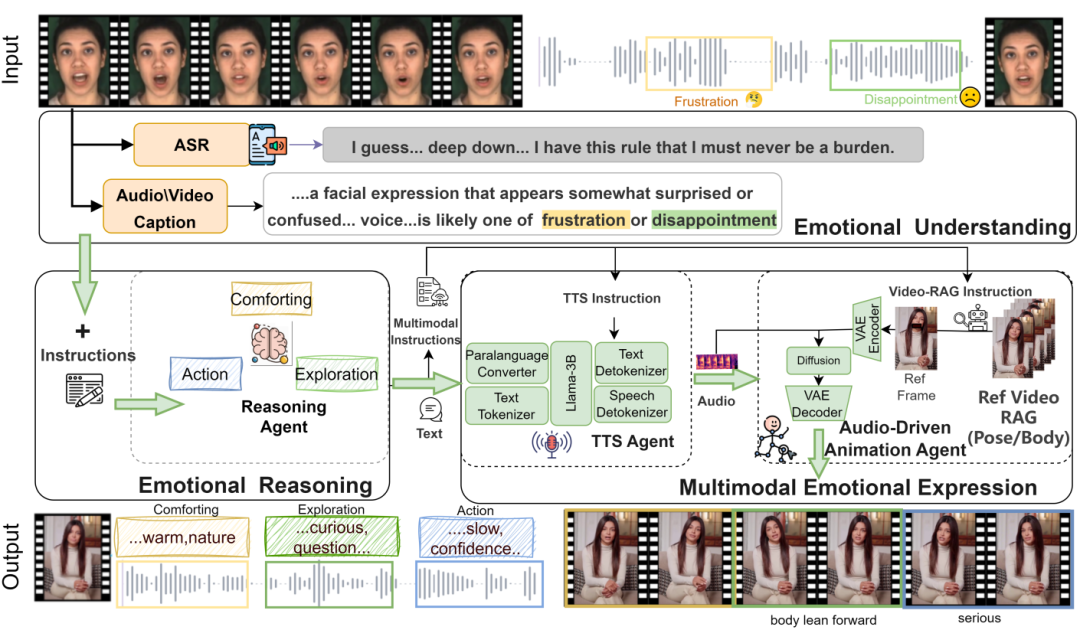
情感理解模块:借助多模态智能体,从音视频输入中解析并生成可解释的情感线索描述。例如当用户表达含糊的负面言论时,系统能精准捕捉其情绪状态,为后续响应提供依据。 情感推理模块:基于希尔(Hill)三阶段咨询理论,形成 “安慰-探索-行动” 支持策略。在LLM智能体引导下,不仅指导文本回复生成,还能让虚拟人在不同阶段呈现特定语言风格、副语言、肢体语言及表情偏好,且可根据用户情况灵活调整阶段时长与顺序。 多模态情感表达模块:为解决长对话场景下视频质量不稳定问题,此框架引入了视频检索增强生成(video-RAG)技术,构建包含 54 个高质量种子参考视频的数据库。生成视频时,系统先根据推理结果产生视频RAG指令,检索匹配参考片段并抽取参考帧,结合语音通过扩散模型合成唇音同步的面部表情与动作,有效避免长对话场景下的误差累积。
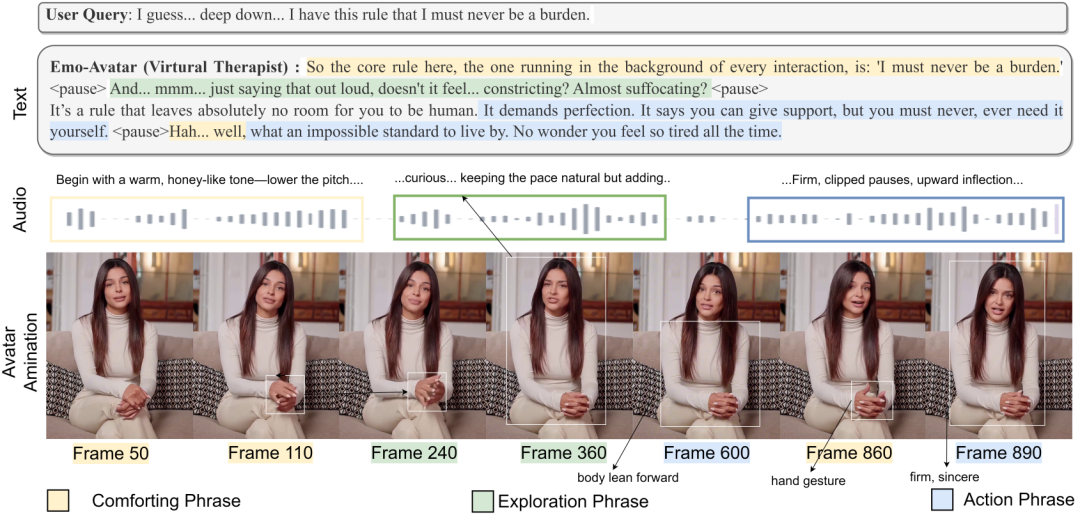
图2:多模态共情回复生成样例
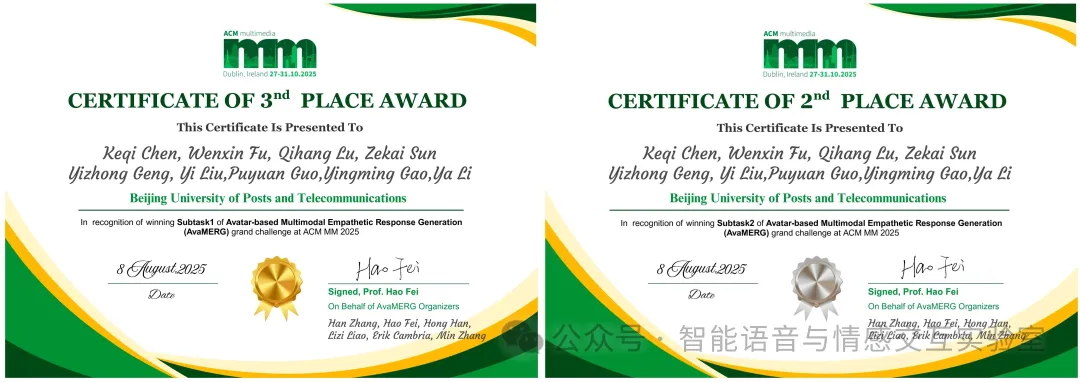
AvaMERG是ACM Multimedia 2025大会旗下专注于多模态共情交互的核心竞赛,致力于推动AI系统实现更贴近人类情感的多模态交流能力。竞赛数据集涵盖64种虚拟人形象与4小时情感对话视频,评估体系融合自动指标与人工评价。在赛道1与赛道2的全部任务中,EMO-Avatar在文本多样性、语音情感匹配度和视频质量等多个关键维度表现卓越,其长对话生成稳定性显著超越竞赛平均水平。最终,EMO-Avatar在多模态共情回复生成赛道荣获亚军,并在文本共情回复赛道获得季军。