语音小管家
前言:今天arxiv发消息,CS板块不再接收未经同行评审的综述类文章,不好评论,只记得十年前,综述都是顶刊邀请,IEEE Fellow坐镇,再加上几个Senior,几年才有一篇,当宝贝一样来回读,近几年综述是挺多的。。。以后既然不再接收新的综述,今天就找了一下个人知识库里最近的一个语音大模型综述,做个纪念。
原文地址:https://arxiv.org/pdf/2504.08528
同时推荐另一篇:《Recent Advances in Speech Language Models: A Survey》,这篇是IEEE Fellow挂名,且今年八月还在更新,可以关注。
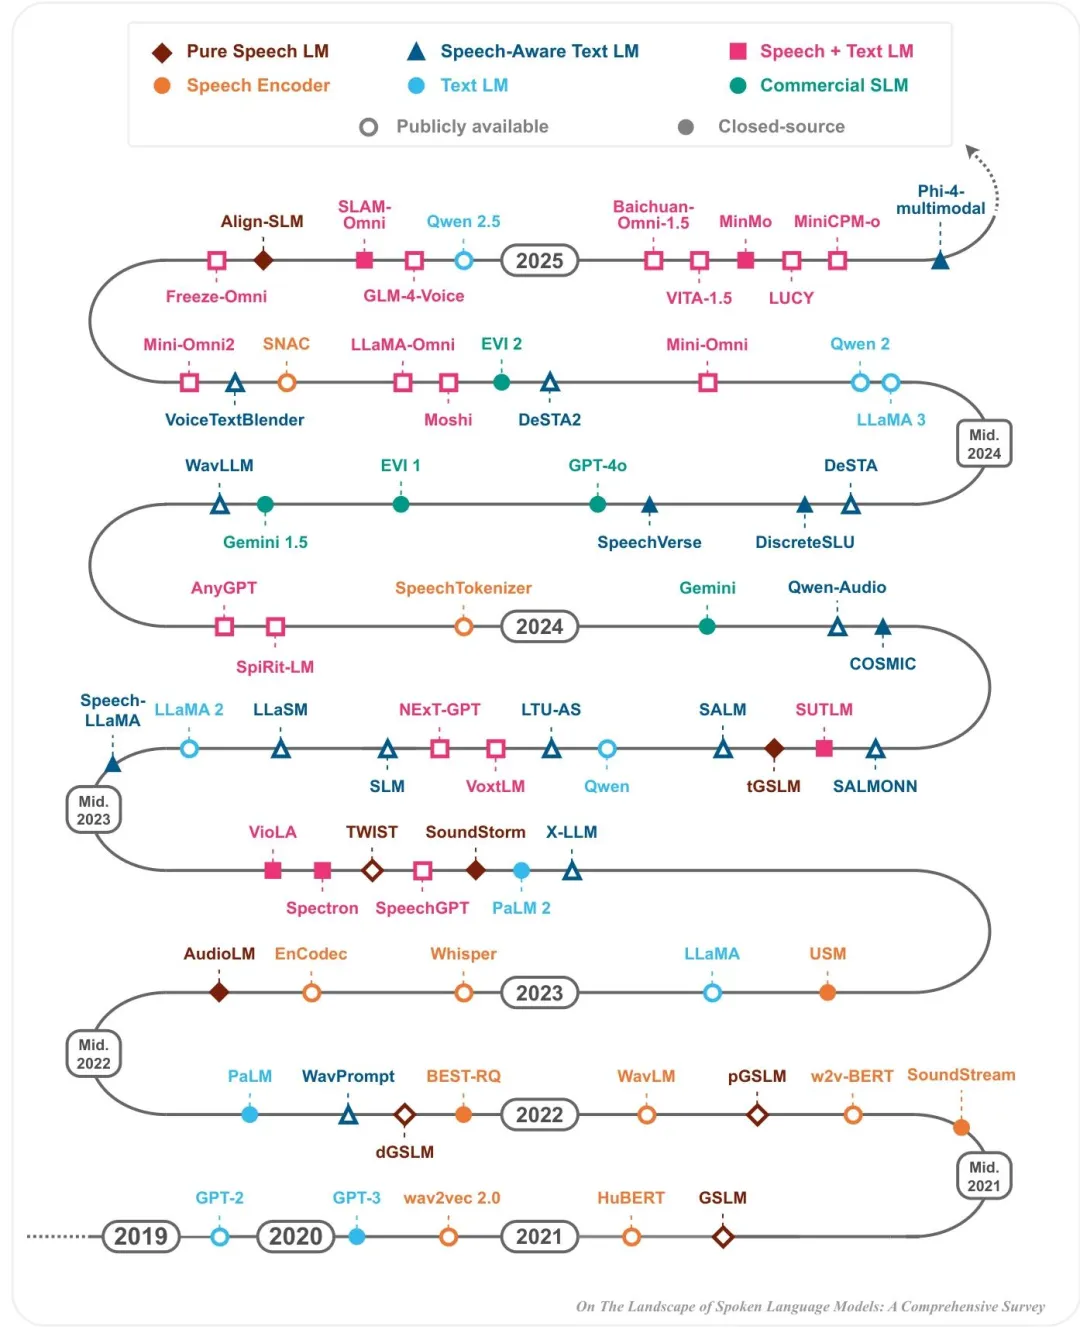
01、引言:SLM是怎么来的?(类比NLP的发展)
能处理语音输入/输出,也能加文本输入/输出; 能做任意语音任务(不管是传统的ASR,还是复杂的语音推理); 用自然语言当指令(比如“把这段语音翻译成英文”),而不是用任务代码或隐藏提示。
02、SLM的整体架构:从输入到输出的流程
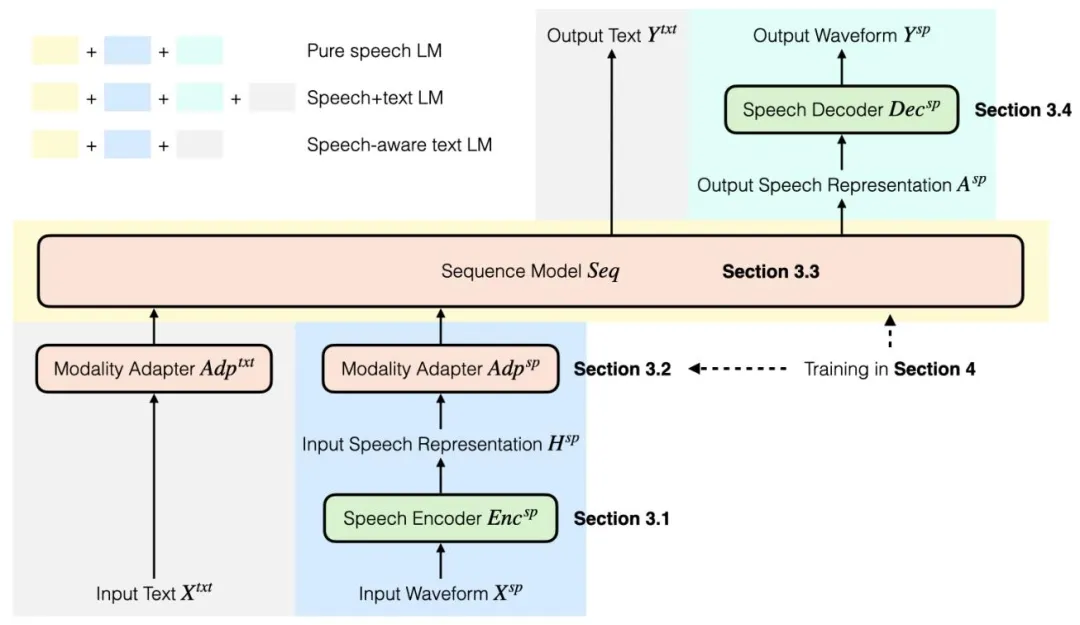
文本输入(Xtxt):就是普通的文本token序列(比如“把这段语音翻译成英文”)。 语音输入(Xsp):是连续的波形(比如一段录音),第一步要过语音编码器(Encsp),转成“语音表示(Hsp)”——要么是连续的向量,要么是离散的token(后面会细讲)。
语音适配器(Adpsp):把语音表示(H^sp)转成和序列模型兼容的格式,还能调整长度(比如缩短语音序列,让它和文本长度差不多)。 文本适配器(Adptxt):一般就是个嵌入层,把文本token转成向量,长度不变。
纯SLM:只输入输出语音,生成“语音表示(Asp)”,最后过语音解码器(Decsp)转成波形。 Speech+Text SLM:联合处理语音和文本,能生成混合的语音+文本序列(比如一边生成文字,一边生成对应的语音)。 Speech-aware Text SLM:结合文本LLM和语音编码器,输入语音+文本指令,输出文本(比如输入一段语音+“总结这段内容”,输出文字总结)。
03、SLM的核心组件:每个部分怎么设计?
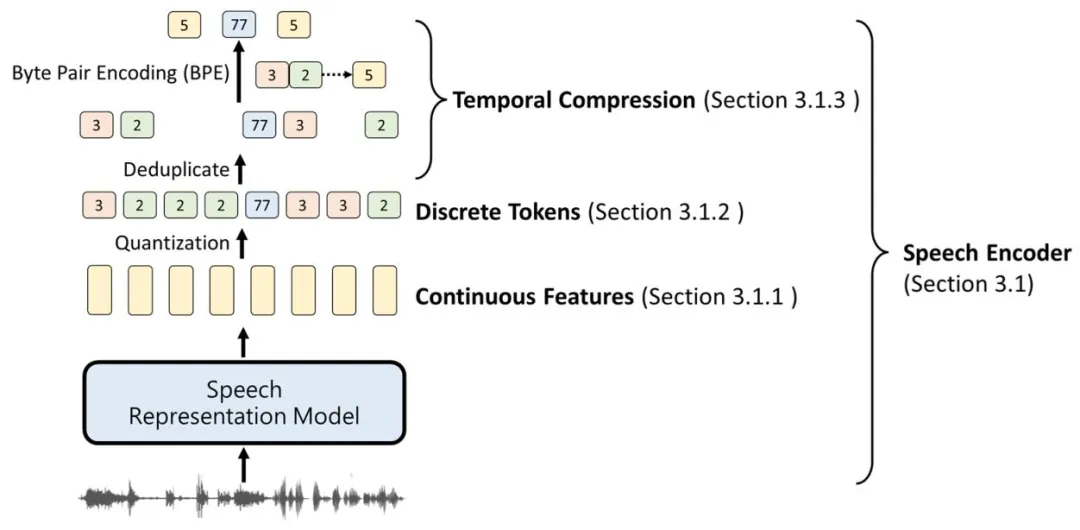
传统特征:比如mel谱图(经典语音处理方法); SSL模型特征:用自监督预训练的语音模型(比如wav2vec 2.0、HuBERT、WavLM),这些模型在海量无标注语音上训过,能抓语言相关的信息; 有监督预训练模型特征:比如Whisper、USM(这些是训过ASR/ST的模型,直接用它们的中间层输出); 神经音频编解码器特征:比如SoundStream、EnCodec(本来是做音频压缩的,中间层输出的特征能保留声学细节)。
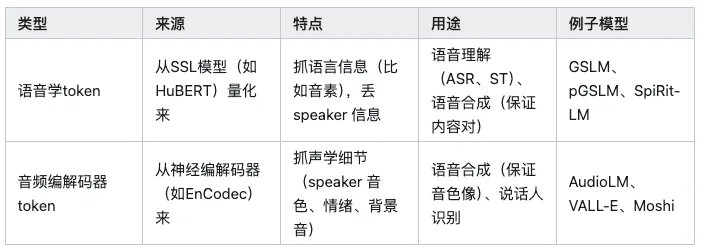
去重(Deduplication):把连续相同的token合并成一个(比如“aaaabbbbb”→“ab”),但会丢时长信息,所以有些模型会单独建模时长; BPE(字节对编码):像文本LLM那样,把频繁出现的token组合成新token(比如“ab”出现多了,就变成一个新token),减少序列长度。
线性变换/词汇扩展:最简单的方式——用线性层把语音token转成文本LLM的嵌入维度,相当于给LLM的词汇表加了“语音token”。比如SpeechGPT给LLaMA的词汇表加了HuBERT的语音学token,Mini-Omni给Qwen加了8层编解码器token。 带步幅的CNN:用CNN的步幅(stride)缩短语音序列长度,同时保留时间信息(比如ASR任务需要知道词的顺序),有些会用池化层替代。 CTC-based压缩:用CTC来选“重要的语音帧”——CTC会给每个帧分配一个概率,挑概率高的非空白帧,合并重复帧,既能缩短长度,又能保留关键语言信息。 Q-Former:把任意长度的语音序列转成固定长度的向量(比如M个向量)。原理是训一组“查询向量(Q)”,通过交叉注意力和语音序列交互,最后输出M个向量,适合处理长语音。有些模型会用“窗口级Q-Former”,把语音切成小段分别处理,保留时间信息。 AlignFormer:结合了CTC压缩和Q-Former,在冻结LLM的情况下,只用ASR数据就能让模型具备零样本指令跟随能力,比单独用Q-Former在SQA(语音问答)、语音翻译上表现更好。
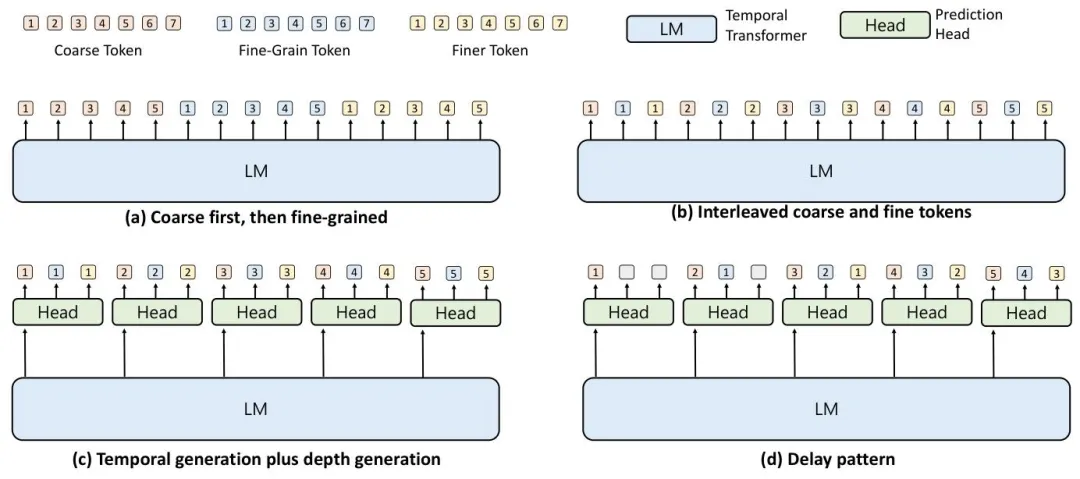
图3(a) 先粗后细:先生成所有粗token,再根据粗token生成细token。比如AudioLM,先生成语音学token(粗),再生成编解码器第一层token(细),最后生成深层token(更细);SoundStorm把后两步改成非自回归,提速;VALL-E用文本转写指导粗token生成,再非自回归生成细token。 图3(b) 交错粗/细token:同一时间步里,先生成粗token,再生成对应的细token。比如SpiRit-LM,把语音学token、音调token、风格token和文本token交错生成,提升语音的表现力。 图3(c) 时间+深度生成:用大Transformer建模“时间上的顺序”(比如前一帧和后一帧的关系),用小Transformer头建模“同一时间步里不同粒度token的关系”(比如同一帧的粗/细token)。比如UniAudio、Moshi,能高效生成多粒度token。 图3(d) 延迟模式:粗token和细token之间有时间差(比如细token比粗token晚1步生成),这样生成细token时能参考“未来的粗token”,提升连贯性。比如pGSLM,语音学token和韵律token(音调、时长)之间有延迟,生成的语音更自然。
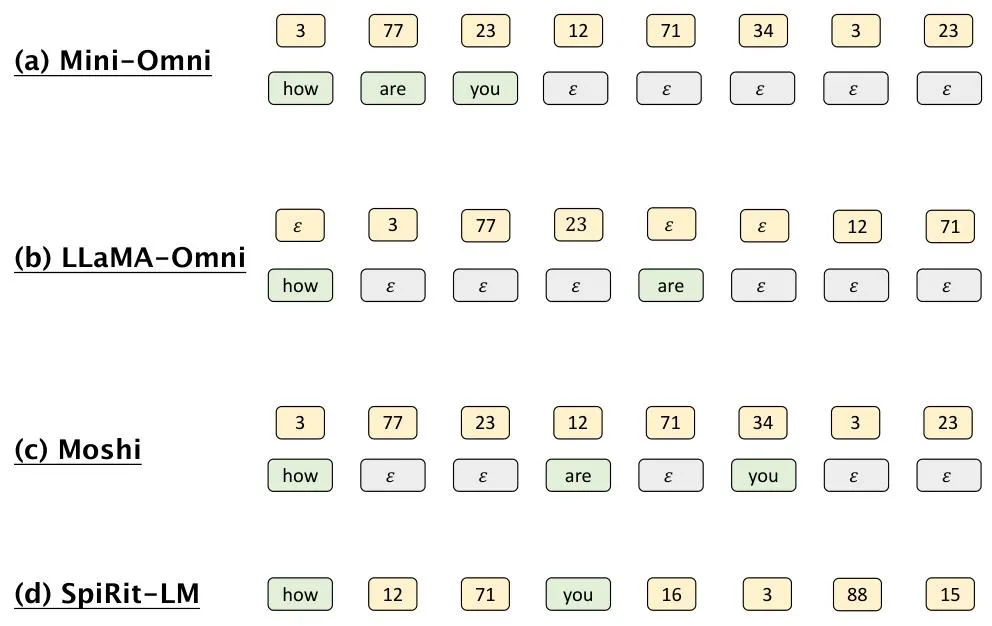
图4(a) Mini-Omni:文本token后面加padding(空白token),文本先生成完,再根据文本生成语音token,像TTS一样。 图4(b) LLaMA-Omni:每个文本token后面加固定长度的padding,语音token也加padding,让两者长度一样,然后用CTC损失训对齐。 图4(c) Moshi:动态加padding——训的时候用时间对齐的语音-文本数据,让模型学“该在哪加padding”,让文本和语音长度匹配,生成更灵活。 图4(d) SpiRit-LM:直接把文本和语音token交错排成一个序列(比如“how 12 71 you 16 3”),训的时候用预对齐的数据,语义连贯性更好。
传统声码器:比如HiFi-GAN、WaveFit,处理连续特征(如mel谱图),像传统TTS那样合成语音。 基于单元的声码器:专门处理语音学token,比如HiFi-GAN的变种,还能加时长模型补过去重丢失的时长信息(比如GSLM用这个)。 编解码器解码器:如果生成的是音频编解码器token(比如EnCodec、Mimi的token),直接用预训练的编解码器解码器转波形,不用额外训(比如AudioLM、VALL-E)。 其他:比如Spectron用WaveFit声码器处理生成的mel谱图,CosyVoice用专门的解码器处理语音学token。
04、SLM的训练策略:怎么让模型“会干活”?
纯语音预训练(p(speech)):用无标注语音训“纯SLM”,比如GSLM——用HuBERT把语音转成语音学token,训自回归模型预测下一个token,能生成简单的语音,但长语音不连贯;后续pGSLM加了韵律信息(音调、时长),生成更自然。 联合语音-文本预训练(p(text,speech)):用对齐的语音-文本数据(比如语音+转写)训模型,同时建模两者的联合分布,比如Moshi、SpiRit-LM——Moshi用预训练文本LLM继续训语音+文本token,能做长对话;SpiRit-LM用交错的语音-文本token训,语义理解更好(比如StoryCloze测试得分高)。 文本预训练后继续训:先训好文本LLM,再用语音数据继续训,让LLM“懂语音”,比如TWIST——用OPT(文本LLM)初始化,再用语音数据训,词汇和句法能力提升(用sWUGGY、sBLIMP测试)。
隐式对齐:比如用ASR数据——给文本LLM输入文本转写,让它生成回答;给SLM输入对应的语音,训SLM生成同样的回答,让两者输出一致;或者训SLM做音频描述(比如“这段语音里有人在笑”),发现只训音频描述就能泛化到其他任务。 显式对齐:直接最小化语音特征和文本嵌入的距离,比如Wav2Prompt——冻结文本LLM的嵌入,训模型把语音特征转成和文本嵌入L2距离最小的向量,实现对齐。
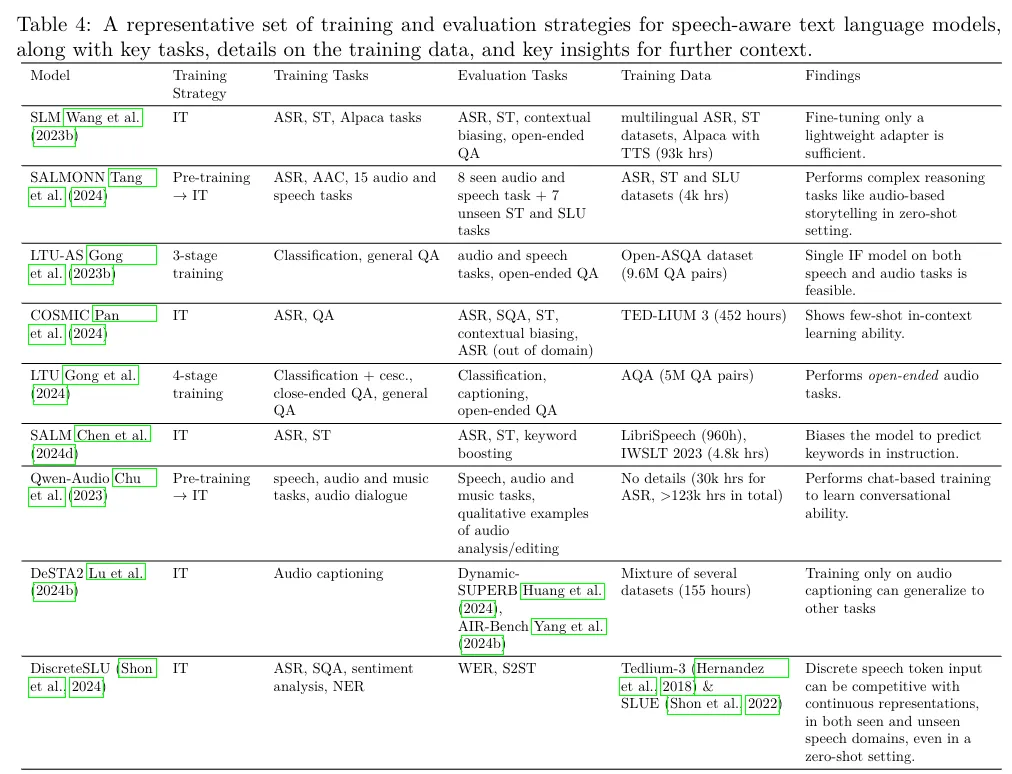
任务数据转指令:把原来的任务数据(比如ASR的“语音+文本”)改成指令格式(比如“识别这段语音→文本”); SQA(语音问答)数据:用LLM(比如ChatGPT)根据语音转写生成“问题-答案”对(比如语音转写是“苹果富含维生素”,生成问题“苹果富含什么?”,答案“维生素”); 文本指令数据合成:用TTS把文本指令数据(比如ChatGPT的对话)转成语音,生成“语音指令+文本回答”数据; 组合指令:把多个任务的指令拼起来(比如“先识别这段语音,再把识别结果翻译成法文”),提升模型处理复杂任务的能力。
专门训能和人对话的SLM,分两个方向:
基于聊天文本LLM:比如Qwen-Audio-Chat——用文本LLM生成“围绕语音的对话”(比如给一段语音,让LLM生成“用户问:这段语音讲了什么?助手答:…”),再用这些数据训SLM; 纯语音/语音+文本对话:用TTS把文本对话数据转成语音对话(比如SpeechGPT),或者用真实语音对话数据(比如Moshi用真实对话数据训,能处理打断、插话等自然对话场景)。
参数高效微调(PEFT):SLM很大,不用全训——比如冻结语音编码器和LLM,只训适配器;或者给LLM加LoRA(低秩适配器),只训少量参数。 渐进式微调:先训简单任务(比如ASR,抓内容),再训复杂任务(比如情感识别,抓语音细节),避免模型学偏;训对话SLM时,先训多通道音频,再训真实对话,提升稳定性。 经验回放:后训练时加一些预训练数据,防止模型“忘光”之前学的能力(比如忘了文本LLM的推理能力)。 偏好优化:用RLHF(人类反馈强化学习)让模型生成更符合人类偏好的内容,比如Qwen2-Audio用RLHF提升回答质量;Align-SLM用AI反馈替代人类评估,降低成本。
05、代表性SLM模型:三类模型各有什么特点?
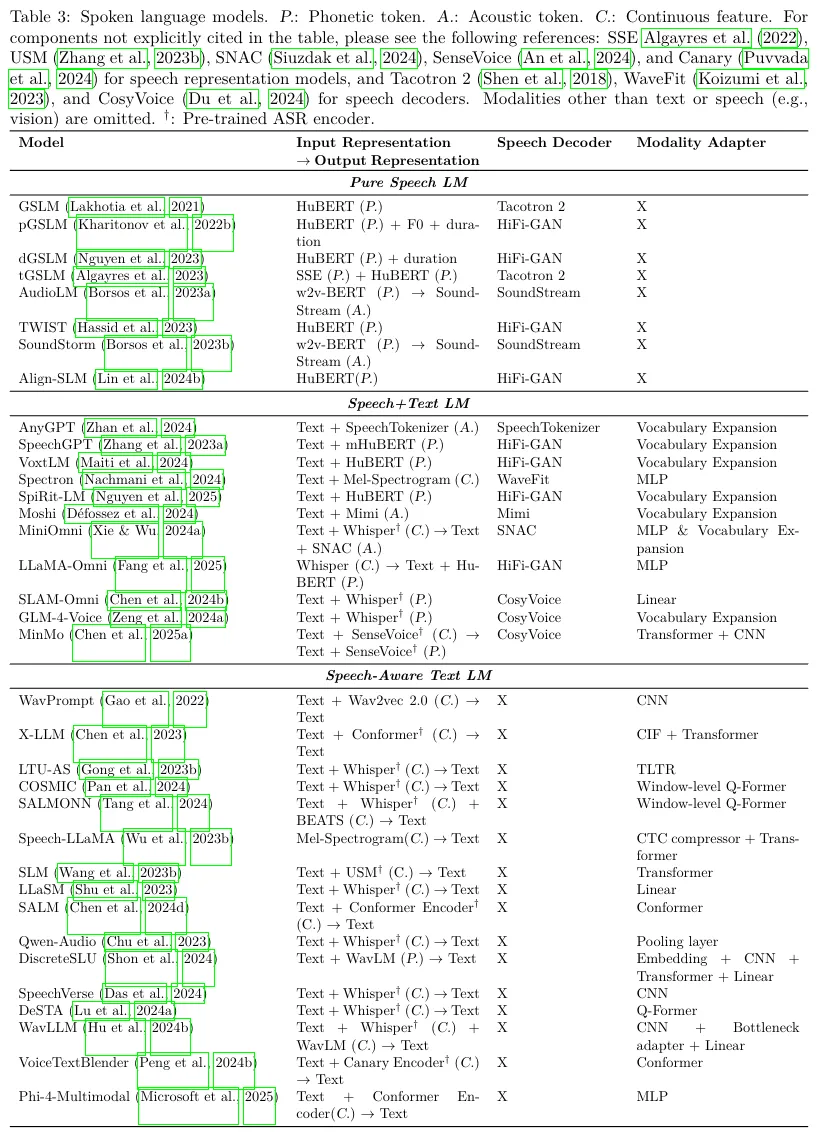
GSLM(2021,早期经典):用HuBERT把语音转成语音学token,训自回归模型预测下一个token,能生成简单的语音,但长语音不连贯; pGSLM(2022):在GSLM基础上,联合预测语音学token和韵律token(音调、时长),生成的语音更有表现力; TWIST(2023):用文本LLM(OPT)初始化,再用语音数据训,词汇和句法能力提升(sWUGGY、sBLIMP测试得分高); AudioLM(2023):分层生成——先语音学token,再编解码器token,生成的语音质量高,还能保持长时一致性(比如几分钟的独白); SpeechSSM(2024):用状态空间模型(不是Transformer),生成的长语音(几分钟)更自然,语义更连贯。
Moshi(2024,开源亮点):第一个能实时对话的开源SLM,用预训练文本LLM(Helium)初始化,再训语音+文本token的联合预测,最后用对话数据训双工模式;能生成几分钟的独白,也能做多轮对话,支持语音输入输出; SpiRit-LM(2025):用交错的语音-文本token训,只做预训练不做后训练,但语义理解比纯SLM好(StoryCloze测试得分高); SpeechGPT(2023):先输出文本,再输出对应的语音,适合turn-taking(轮流说话)对话,但不能处理插话; Mini-Omni/LLaMA-Omni(2024):用延迟模式生成语音token,文本和语音分通道输出,也是turn-taking结构,灵活性不如Moshi。
WavPrompt(2022,早期):wav2vec 2.0(语音编码器)+ GPT-2(文本LLM),冻结GPT-2,只训语音编码器;能做简单的语音分类,但不能处理没见过的任务; SALMONN(2024,经典):Vicuna(文本LLM)+ 语音编码器,先训ASR和音频描述,再训多任务;冻结大部分参数,只训适配器和LoRA;能泛化到没见过的任务(比如语音总结); Qwen-Audio(2023):训语音编码器和LLM,从多任务(ASR、情感识别、音频描述)开始,再加聊天微调,鲁棒性强;后续Qwen2-Audio加了偏好优化,回答质量更高; DeSTA(2024):用“描述性语音-文本对齐”任务训——让模型同时识别语音内容和描述语音细节(比如“说话人是女性,语气开心”),不用专门的指令数据也能做指令跟随; UniverSLU(2024):从Whisper(条件预训练)开始,先加任务标识符训,再加自然语言指令训,能做各种SLU任务(比如意图识别、槽位填充)。
06、双工语音对话:让SLM“边听边说”
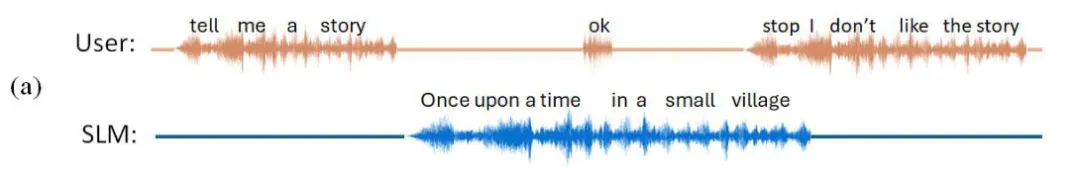
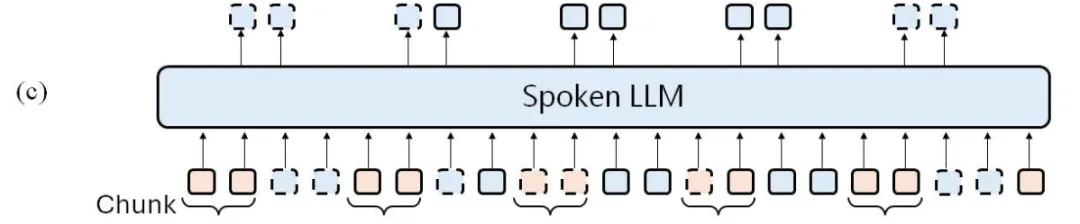
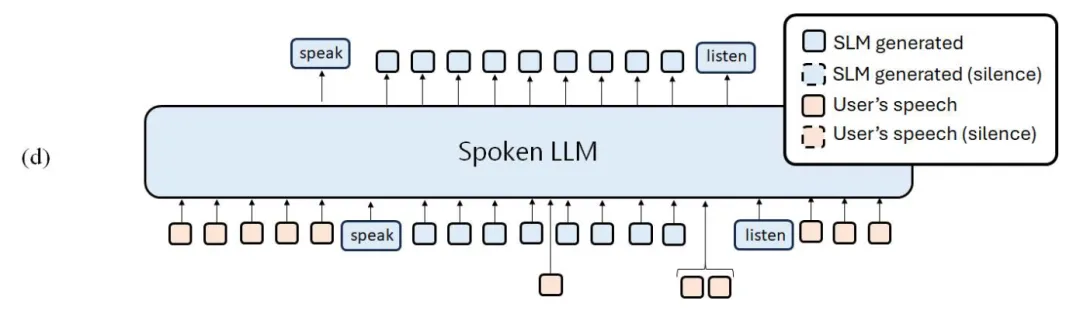
论文讲了两种实现双工的方式:
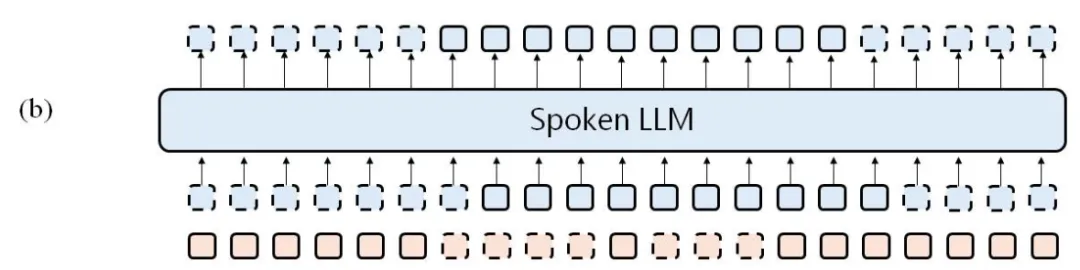
监听通道:一直听用户的语音输入; 说话通道:生成SLM的语音输出,同时跟踪自己说了什么;
07、SLM的评估:怎么判断模型好不好用?
sWUGGY:评词汇能力(正例“brick”,负例“blick”); sBLIMP:评句法能力(正例“我吃饭”,负例“我饭吃”); StoryCloze:评语义能力(给一段故事,选正确的结尾); ProsAudit:评韵律能力(正例正常停顿,负例停顿在奇怪位置); SALMon:评声学和韵律一致性(比如同一说话人前后音色是否一致,语气和内容是否匹配)。
语音质量:用MOSNet(客观指标)或人评(主观MOS分); 一致性:用人或预训练分类器评“生成的语音和输入是否一致”(比如说话人音色、情绪是否不变); 内容质量:把生成的语音转文本,用文本LLM(比如GPT-4)评分,或对比参考文本(用BLEU、ROUGE)。
SQA(语音问答):比如LLaMA-Questions、TriviaQA(合成语音版),评模型“听语音答问题”的 accuracy; 指令跟随:用动态基准,比如: Dynamic-SUPERB(Phase2有180个任务,涵盖分类、回归、生成,比如ASR、情感识别、语音翻译); AIR-Bench:包含分类和开放式聊天问题; VoiceBench:评语音助手能力(开放问答、参考问答、多选择、指令跟随); MMAU:评语音推理(比如“两个说话人是什么关系”); AudioBench:涵盖语音理解、音频场景识别、语音分析(口音、性别、情绪)。
风格对齐:评模型“生成符合指定风格的语音”能力,比如StyleTalk(语调、情绪)、E-chat200(情绪)、SD-Eval(口音、年龄、音量)。
幻觉:SLM会“瞎编”——比如音频里没有狗叫,问“有狗叫吗?”,模型说“有”。Kuan等人发现:SLM比“ASR+文本LLM”串联模型幻觉多,提出“分步提示”(先让模型描述音频,再根据描述回答问题)能缓解; 毒性:评生成语音的文本转录是否有冒犯内容(比如SpiRit-LM、GPT-4o会测这个); 偏见:看模型是否因说话人特征(性别、年龄、口音)改变回答。Lin等人测试发现当前SLM偏见少,但可能是因为模型还不会区分说话人特征;GPT-4o用多样语音后训,偏见控制得好; 深度伪造:SLM能模仿真人语音,容易被滥用。Wu等人做了CodecFake数据集(SLM生成的伪造语音),发现基于这个数据集训的检测模型能有效识别伪造语音。
08、挑战与未来方向:SLM还缺什么?
语音表示没统一:到底用连续特征还是离散token?用哪种token(语音学/编解码器)?不同选择影响后续设计; 语音文本结合方式没统一:适配器用哪种?序列生成用分层还是混合?没系统对比过; 效率低:SLM太大太慢,不适合实时/端侧场景(比如手机上用),需要压缩算法和更高效的架构。
缺高质量数据:尤其是指令微调、聊天对话的数据,现在很多用合成数据(比如TTS转的),真实数据少; 数据集不统一:不同模型用不同数据集,没法公平对比“是架构好还是数据好”; 缺缩放研究:不知道SLM随模型大小、数据量增长的规律(比如文本LLM有缩放定律),只有少数研究(比如Maimon等人用单GPU24小时训出高质量纯SLM)。
基准没普及:Dynamic-SUPERB这些基准刚出来,没成为通用标准; 任务覆盖不全:语音任务比文本多(比如说话人识别、韵律分析),现有基准还没覆盖全; 生成评估没标准:语音生成的质量(比如自然度)主观因素多,没统一的客观指标。
少全开源模型:很多模型只放权重,不放代码、数据,没法复现和对比; 包容性差:现在主要关注高资源语言(英语、中文),低资源语言、方言、有语音障碍的用户(比如口吃)没覆盖到; 安全性:深度伪造、偏见这些问题还没彻底解决,需要专门的语音安全方案。
09、总结
10、附录图表