
 语音小管家
近日,蚂蚁集团AI身份智能团队在音频-语言大模型的后训练研究上取得重要突破。团队联合香港中文大学、上海交通大学、华南理工大学、萨里大学等国内外知名学府,提出了迄今为止规模最大、质量最高的音频理解选择题数据集AudioMCQ,并基于AudioMCQ深入探究了音频-语言大模型的“音频贡献缺失”现象:即音频-语言大模型不需要听音频也可以正确地回答问题。
基于研究结果,团队创新性地提出了“音频贡献过滤”和“基于音频贡献的后训练”方法,解决了在音频-语言大模型的后训练过程中监督微调-强化学习范式失效的问题。研究成果在多个权威基准测试(MMAU、MMAR、MMSU)中刷新了最优性能记录。目前AudioMCQ及相关数据集、模型已经开源。
论文标题:Measuring Audio's Impact on Correctness: Audio-Contribution-Aware Post-Training of Large Audio Language Models
论文地址:
Huggingface:
Github:https://github.com/inclusionAI/AudioMCQ
随着多模态AI技术的快速发展,音频-语言大模型(Large Audio Language Model, LALM)成为继视觉语言模型之后的又一重要研究方向。由于从零预训练LALM需要海量计算资源和数据,所以后训练(post-training)作为一种高效的模型优化方法受到广泛关注。后训练通过在预训练模型基础上进行监督微调(Supervised Fine-Tuning, SFT)和/或强化学习(Reinforcement Learning, RL),能够以较小代价显著提升模型性能。
然而,当前音频大模型的后训练方法仍存在诸多挑战:
后训练数据匮乏:缺乏大规模、高质量的专门后训练数据集;
“音频贡献缺失”现象:模型常常仅依赖文本信息就能答对问题,并未真正理解音频内容,导致后训练效果受限;
SFT-RL两阶段训练策略不清晰:SFT和RL两个阶段如何分配数据、哪些数据更适合哪个阶段尚无定论,导致SFT-RL范式的训练效果甚至经常不如单纯做SFT或者RL。
⏩1. AudioMCQ数据集:首个大规模音频理解选择题数据集
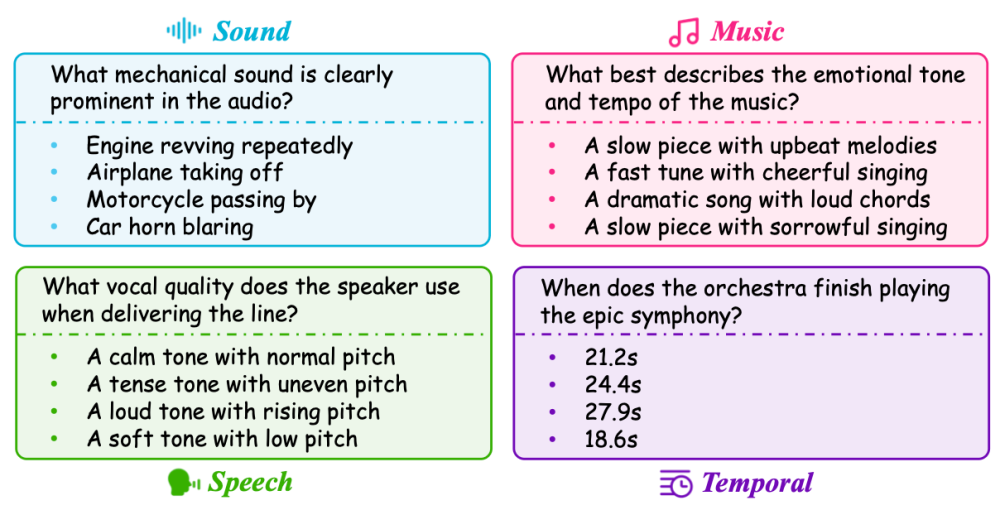
图1:AudioMCQ数据集的样本示例
团队构建了包含57万+样本的AudioMCQ数据集,这是目前最大规模的音频理解后训练数据集。数据集具有以下特点:
多样化高质量来源:整合了Clotho、AudioCaps、MusicCaps等7个高质量音频理解数据集,这些数据集在构造过程中都完全避免了使用LALM(团队不希望将LALM的音频贡献缺失现象引入到数据集的构造中);
四类问题:涵盖声音(39.1%)、语音(47.0%)、音乐(8.1%)、时序(5.8%)四大类别的问题;
两种思维链标注:每条样本都提供了结构化和非结构化两种思维链标注,以支持模型后训练中的思维链研究;
自动化质量控制:利用大语言模型Qwen3-235B进行五维度质量评估,确保后训练数据质量。
数据集构建采用了创新的自动化流水线,包括基础问答构建、多选题生成、思维链标注和质量控制四个阶段,并利用大语言模型进行自动评分过滤,确保只保留高质量的后训练样本。
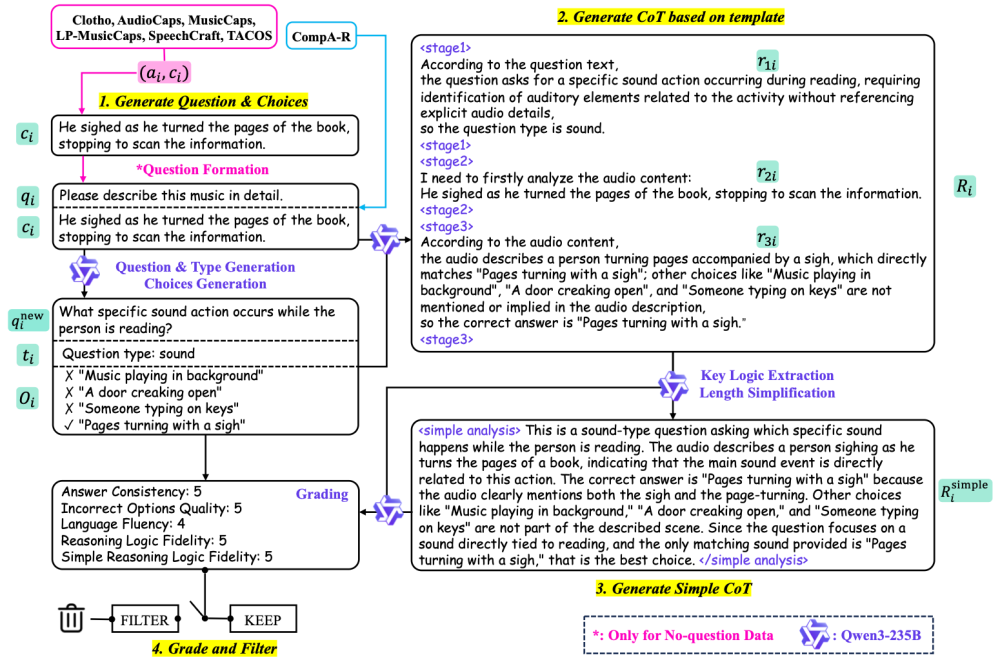
图2:数据集构造流水线
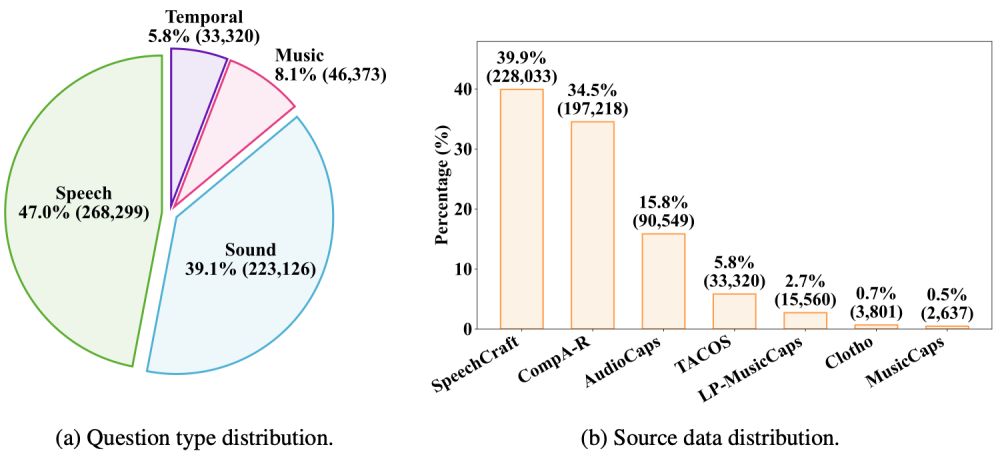
图3:AudioMCQ的样本种类、样本来源分布情况
⏩2. “音频贡献”概念:模型真的听了吗?
AI身份智能团队发现了一个普遍存在但此前常被忽视的现象——“音频贡献缺失”现象:当前主流音频大模型在多个权威测试集上,即使使用静音音频替换原始音频,仍能在MMAU(v05.15.25)测试集上平均达到49.8%的准确率,远超随机猜测的25.5%。这说明许多问题可以仅凭文本信息回答,音频理解能力并未真正发挥作用。在MMAR和MMSU上,也出现了类似的情况。
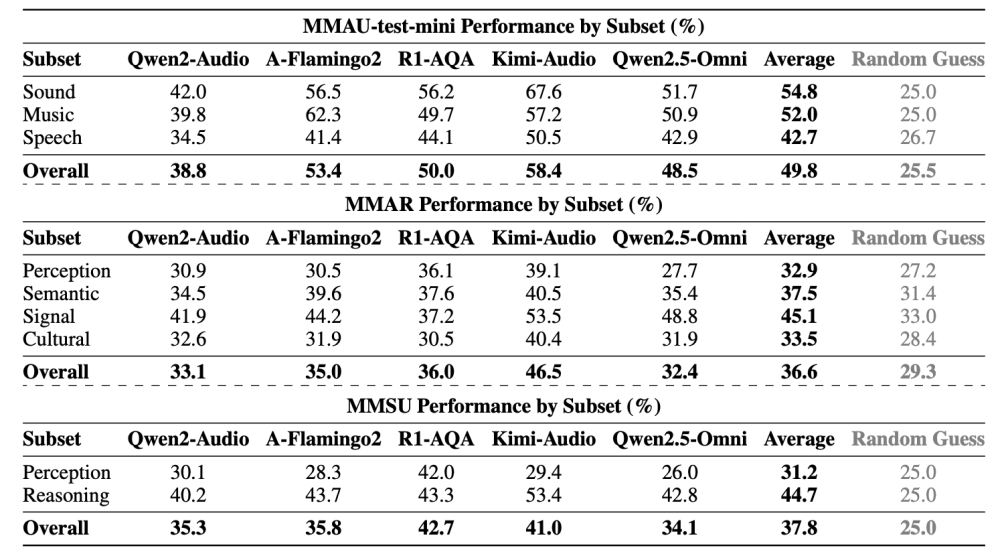
表1:空白音频输入的前提下,多个主流LALM在三个benchmark上的表现
基于这一发现,团队提出了“音频贡献过滤”(Audio-Contribution Filtering, ACF)方法,这是首个针对音频大模型后训练的数据分层策略。该方法将后训练数据分为:
弱音频贡献数据(54.8%):多数LALM仅凭文本信息即可正确作答;
强音频贡献数据(45.2%):多数LALM必须听取音频才能正确作答。
这一创新为后训练的两个阶段提供了新的数据分配思路。
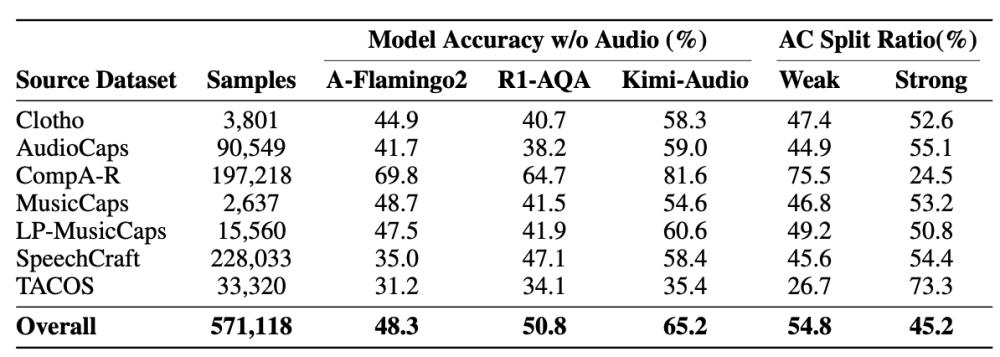
表2:对AudioMCQ各个数据源的音频贡献过滤结果
即使在数据集构造过程中尽量精细严谨,避免引入LALM,依旧有54.8%的弱音频贡献数据,因此,团队又更加深入地探究了弱音频贡献数据的细分情况。团队发现“音频贡献缺失”又可以继续分为两类:
显式逻辑推理:问题中包含明显的文本线索,可以直接根据线索推理出答案,通过使用Qwen3-235B分析,团队发现这部分数据只占弱音频贡献数据的31.1%,且其中85.1%的样本都来自于CompA-R数据集(本身是一个推理数据集);
隐式知识检索:虽然问题中没有包含明显的文本线索,但是LALM在训练过程中已经对各类音频事件的概率分布产生了概念,所以直接就会选择最可能出现的选项。通过使用Qwen3-235B分析,这部分数据在弱音频贡献数据中占比68.9%。
⏩3.新的后训练数据分配范式:从“随机分配”到“弱强分离”
基于音频贡献分析,团队开发了两种创新的SFT-RL两阶段后训练范式,即使没有使用任何思维链模式,模型在不同基准测试上也均取得显著提升:
Weak-to-Strong后训练范式(弱到强):
SFT阶段:使用弱音频贡献数据进行监督微调,让模型学会基础的文本推理和知识检索;
RL阶段:使用强音频贡献数据进行GRPO(Group Relative Policy Optimization)强化学习,专注提升真正的音频理解能力。
效果:在MMAU-test-mini上达到78.2%,MMAU上达到75.6%,创下了最优性能记录,在MMAR和MMSU上也分别有65.3%和69.3%的好成绩,综合效果显著超过单纯的SFT或者单纯的RL。
Mixed-to-Strong后训练范式(混合到强):
SFT阶段:使用混合音频贡献数据进行监督微调,保持数据的自然分布;
RL阶段:使用强音频贡献数据进行强化学习,强化音频理解核心能力。
效果:在MMAR上达到67.0%,首次突破67%大关,MMSU上达到71.7%,首次突破71%大关。
这两种后训练范式都显著超过在SFT和RL阶段随机分配数据的效果。
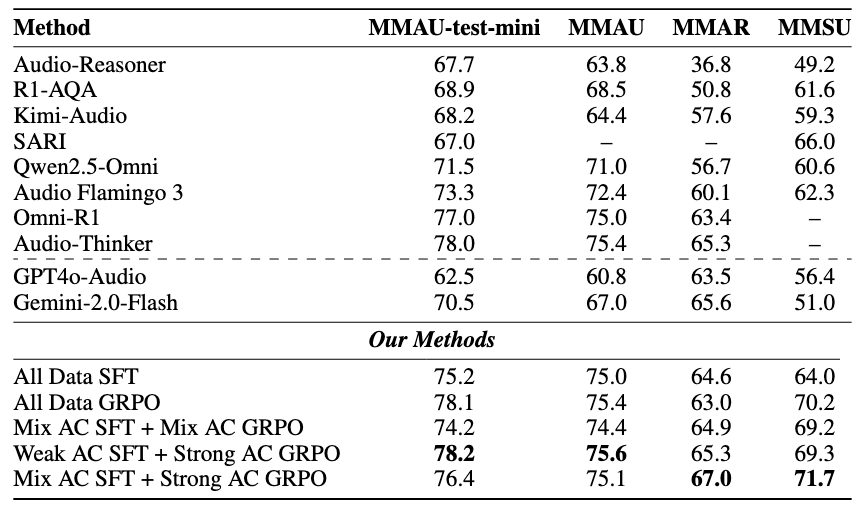
表3:不同方法的性能比较
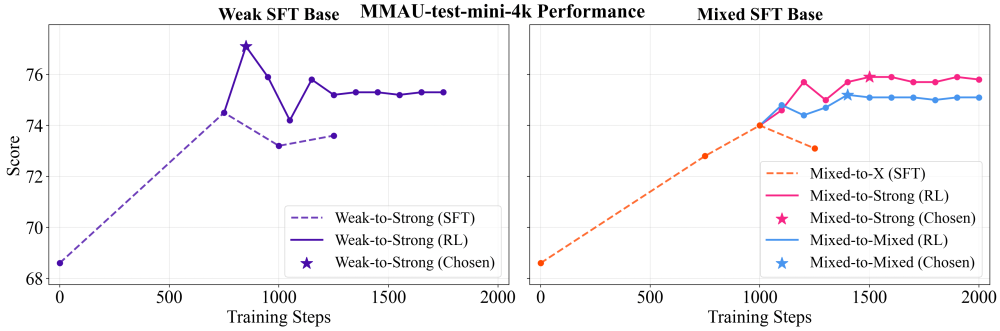
图4:每个步骤最好的checkpoint是通过测试模型在MMAU-test-mini-4k上的表现找到。团队将MMAU-test-mini扩展了4倍,使得原每道题的正确选项出现在每个位置各一次。
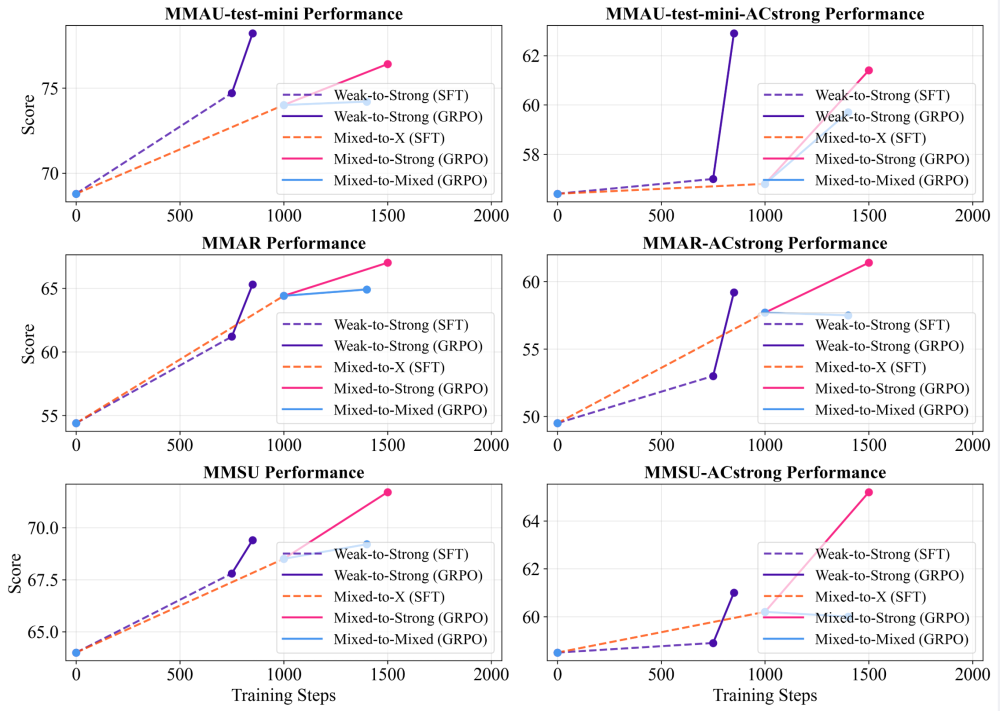
图5:使用两种训练范式以及随机分配范式,在SFT-RL两阶段对模型的性能的提升情况。其中-ACstrong后缀的benchmark指的是原benchmark的“强音频贡献”部分,更能反映模型感知音频的能力。
⏩4.核心洞察:后训练数据分配的实践依据
研究揭示了LALM后训练的两个关键规律:
RL阶段必须使用强音频贡献数据:使用混合数据进行强化学习不仅提升有限,甚至可能导致性能下降。这是因为弱贡献数据会干扰模型学习真正的音频理解能力。
SFT阶段的数据选择应与下游任务对齐:
MMAU这类弱音频贡献基准(约50%问题可不听音频回答),使用弱贡献数据进行SFT效果更好
对于MMAR、MMSU这类强音频贡献基准(超过60%问题必须听音频),使用自然分布的混合数据进行SFT更合适
这些发现为音频大模型的后训练提供了更清晰的方法论指导。
团队使用AudioMCQ数据集及创新后训练方法在DCASE 2025音频问答挑战赛中获得全球第一名。此外,基于不同后训练策略,团队在多个权威基准上建立了新的最优性能:MMAU-test-mini达到78.2%,MMAU达到75.6%,MMAR达到67.0%,MMSU达到71.7%,刷新了最优性能记录。
还有一些可以提升的地方:
“音频贡献过滤”方法目前仅针对音频理解选择题数据集进行了设计,可以扩展到通用的音频理解数据集上(如音频描述等);
在训练过程中依旧没有完全用尽AudioMCQ数据集(只用到了不到一半),期待在强化学习的scalingup被进一步探索后,可以用AudioMCQ训练出更好的结果;
暂时还没有用到AudioMCQ的思维链标注,希望后续可以探索思维链的新应用。
团队的工作
随着AI技术的快速发展,一方面Deepfake手段不断升级,AI欺诈快速蔓延到身份认证核验领域,亟需新的防伪手段和核身能力;另一方面,LLM驱动的多模态实时交互成为人机交互新范式。基于以上背景和对技术、业务的洞察,探索并沉淀了以下产品能力,已在多个业务场景下落地:
流式视频核身&交互:基于多模态大模型的多模理解能力,支持在视频中进行身份核验、低时延自然的自然语言对话、屏外前后摄像头信息采集等,通过重构核身交互形态和升级防伪能力提升信息采集的丰富度、及时性和连续性,实现对黑产的降维打击。
泛终端核身:在智能硬件领域,眼镜目前代表了的新交互范式,除了通过智能眼镜用来支付,基于眼镜的其他应用都需要基于身份验证。目前团队已经和Rokid等厂商合作上线声纹支付能力,参与到用户在支付交互过程中的金额提取、意图理解和支付确认环节,端到端保障眼镜上支付的流程、体验和安全。团队也在提前技术布局,进行虹膜和眼动能力的建设。
光鉴凭证防伪:光鉴是行业内首个工业级生成式篡改大模型并完成全面落地,行业首次创新性设计使用生成式大模型解决判别式问题的score化方案;经蓝军攻防测试,目前线上真实防伪水位高出行业一个水位。作为行业领先的凭证防伪能力,光鉴已经获得了蚂蚁集团技术年度十大突破创新项目奖和T STAR等多个奖项的认可。
除了上述产品能力,团队还积极参与到行业标准的建设及前沿技术的探索中,累计发表CCF-A类论文20+篇,专利授权24项,沉淀了一批高质量成果。
团队招聘
AI身份智能是一支处于快速成长、对用AI解决身份验证问题踌躇满志的队伍,如果你对多模态交互算法、多模态大模型&内容理解算法、人机交互等领域感兴趣,欢迎自荐或他荐,实习生持续招募中~
联系邮箱
hehaolin.hhl@antgroup.com
sunrenhe.srh@antgroup.com
