
 语音小管家
标题:《SpeechJudge: Towards Human-Level Judgment for Speech Naturalness》
01、先搞懂背景:为啥这事儿重要?
02、核心第一块:SpeechJudge-Data——大规模人类反馈数据集
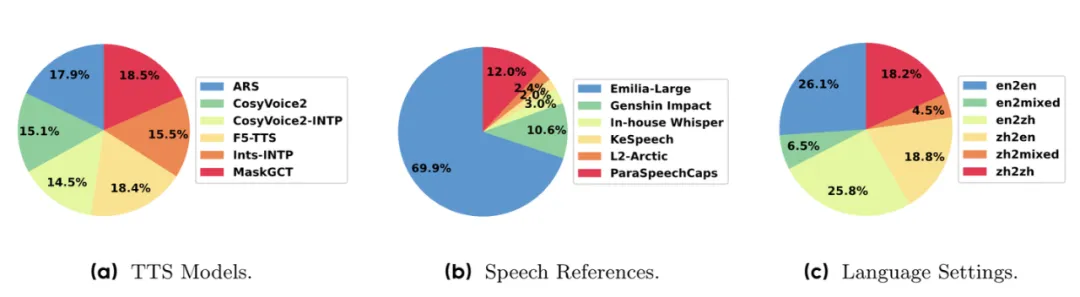
TTS模型:选了3种架构的6个主流零样本模型(AR类的CosyVoice2、FM类的F5-TTS、MGM类的MaskGCT等),确保语音多样性; 风格:常规语音用Emilia-Large数据集,情感语音找了ParaSpeechCaps(情感库)、原神角色语音、还有带口音的L2-Arctic这些,连中英混码都覆盖了; 场景:单语(比如中文转中文、英文转英文)、跨语言(中文转英文、英文转混码)都有,图2里能看到模型、语音来源、语言的分布,特别均匀。
标注员:69个人,中文得是母语,英文至少CET-6水平,培训后才上岗; 标注任务:俩核心任务,整整干了2个月,成本约50万人民币:
可懂度标注:二进制判断——语音有没有读错、漏读、多读(比如文本是“熊猫”,读成“熊”就算错); 自然度标注:5级CMOS pairwise判断——比如“A比B明显自然”(A+2)、“差不多”(Tie)、“B比A稍自然”(B+1),每个语音对平均被2.49个人标过,保证靠谱。
数据集子集:raw数据99K,但得筛出高质量的来用: hq子集(高质量):过滤掉“可懂度差距太大”的样本(WER差距>12%,不然可懂度会掩盖自然度差异),剩44K对; 训练集&验证集:hq子集里抽1K当验证集(dev),剩下42K当训练集(train)。
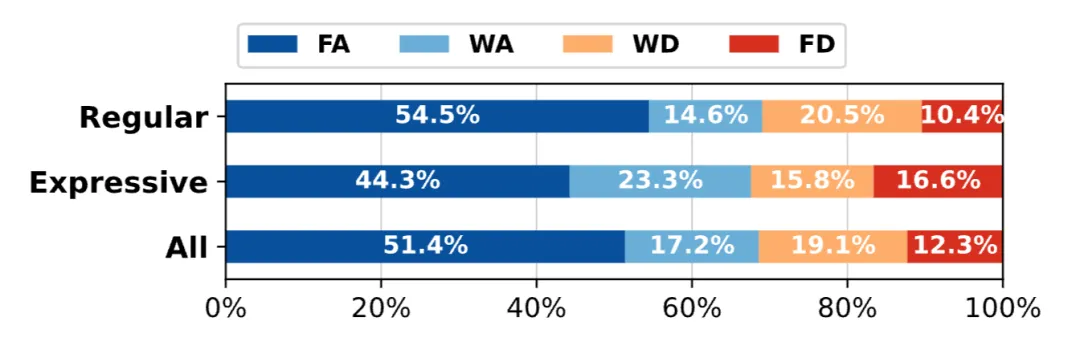
70%的样本是“完全一致”(51.5%)或“弱一致”(17.2%),说明标注质量靠谱; 但情感风格样本的“完全一致”比例(44.3%)比常规样本(54.5%)低——这说明人类判断“带感情的语音自不自然”,本身就更难。
03、核心第二块:SpeechJudge-Eval——自然度判断基准
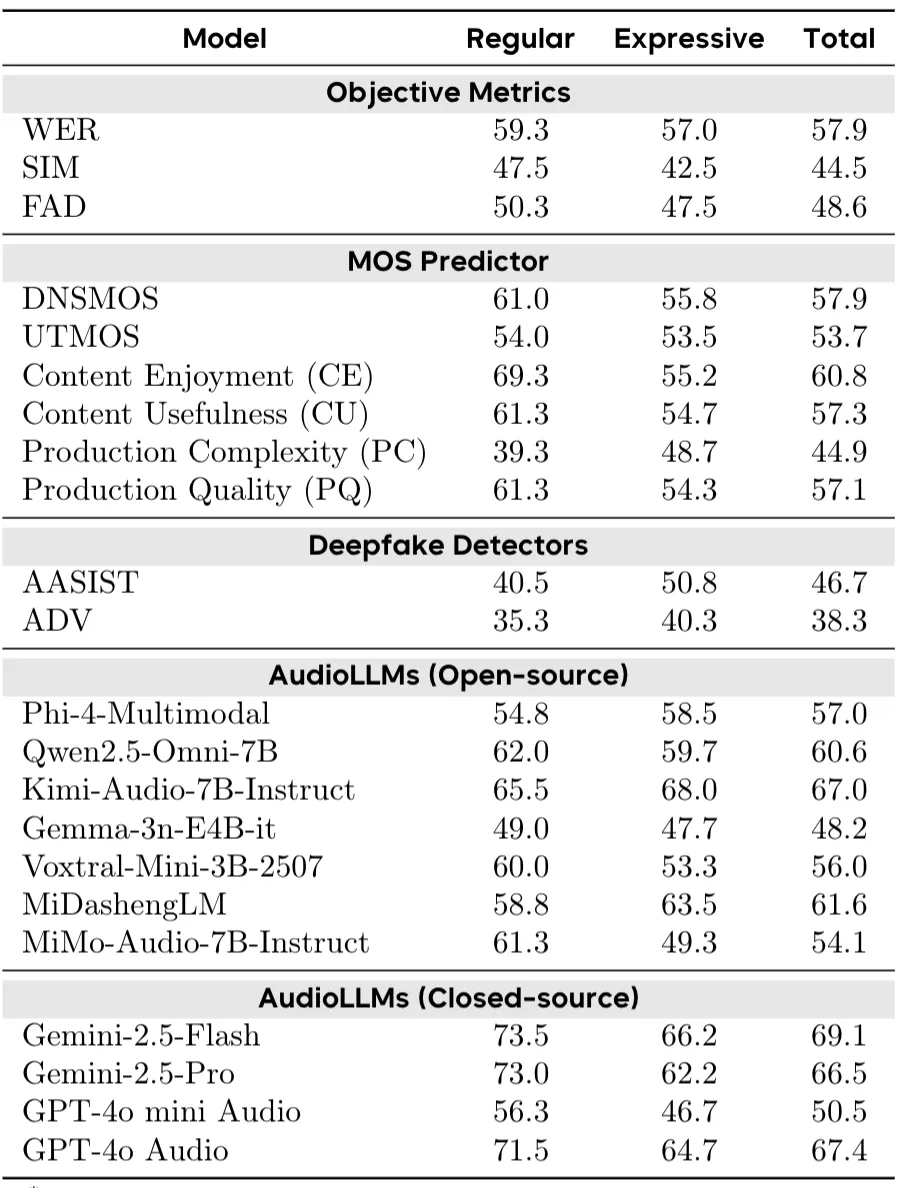
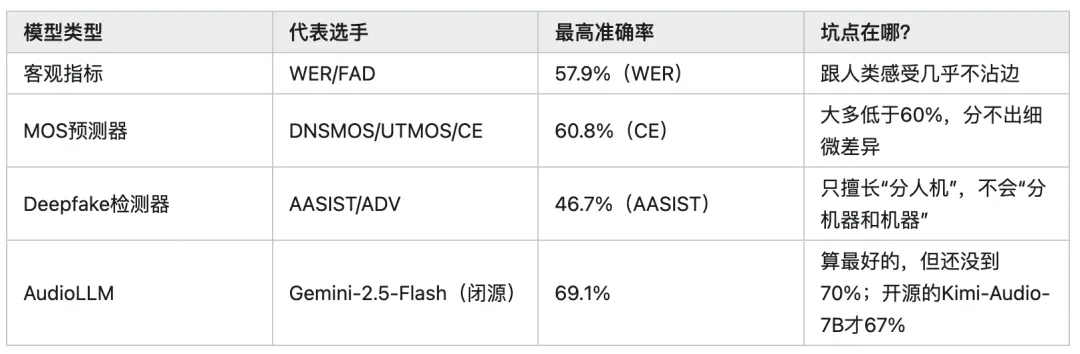
04、核心第三块:SpeechJudge-GRM——生成式奖励模型(创新点!)
支持CoT推理(Chain-of-Thought):能像人一样分析“为啥A比B自然”(比如“A的节奏更顺,B有机械音”),可解释; 支持推理时缩放:比如生成10次结果投票,能进一步提准确率。
SFT阶段(冷启动):
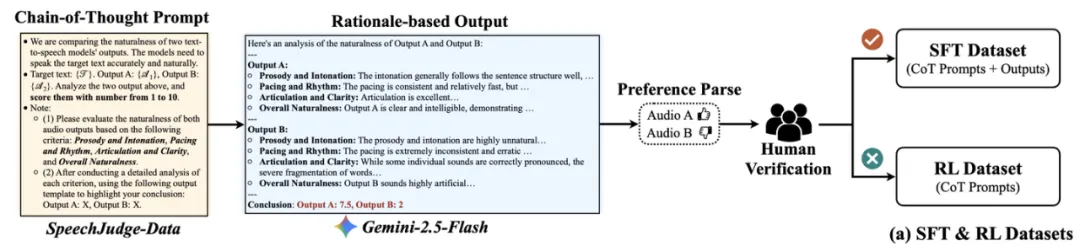
问题:直接练Qwen2.5-Omni-7B不行,它的指令跟随和推理能力太弱; 解决:找Gemini-2.5-Flash当“老师”——对SpeechJudge-Data里25K“Gemini判断和人类一致”的样本,让Gemini生成CoT推理文本(比如分析韵律、清晰度),用这些数据fine-tune Qwen2.5-Omni-7B,提升它的理解和推理能力。
RL阶段(难样本优化):
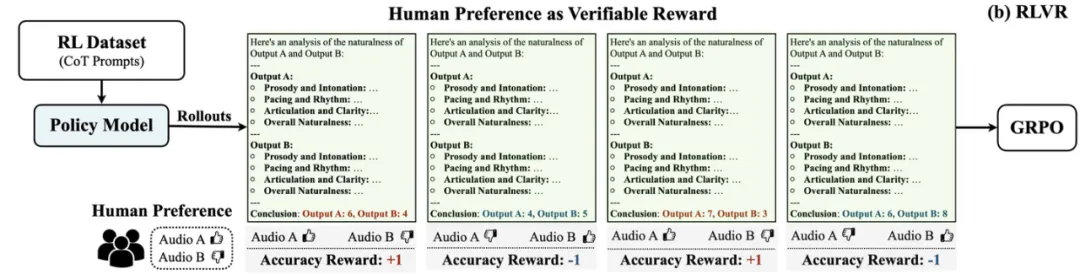
针对:Gemini判断错的17K“难样本”(这些才是提升关键); 方法:用GRPO算法(一种强化学习),把人类标注当“奖励”——模型判断对了给+1,错了给-1,专门优化难样本的判断能力。
05、GRM真的能用吗?实际应用测试
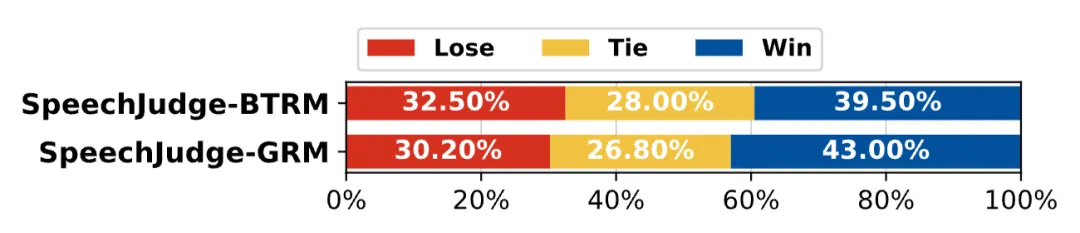
场景:让Qwen2.5-Omni-7B(Talker)生成100个语音,用GRM和BTRM分别选“最自然的那个”,再让人类对比“选出来的”和“随机抽的”哪个好。 结果:GRM选的样本“赢过随机样本”的比例比BTRM高——说明GRM选的确实更符合人类偏好。
方法1:用INTP数据集对齐; 方法2:用SpeechJudge-Data对齐; 方法3:用GRM离线标注对齐; 方法4:用GRM在线奖励对齐。
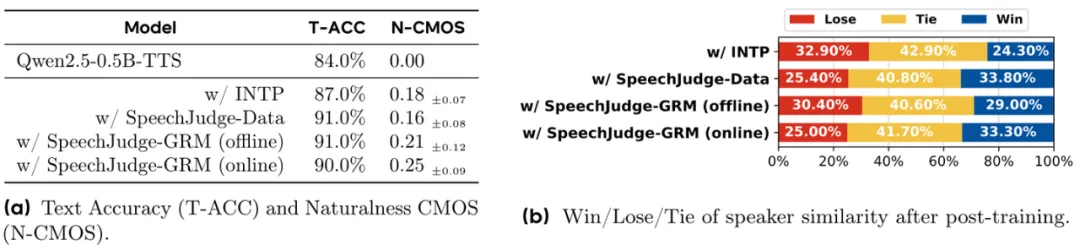
自然度:GRM在线方法的CMOS最高(0.25±0.09),比其他方法都好; 可懂度:所有方法都比基线(84.0%)高,最高到91.0%; 说话人相似度:没下降(图6b里“Tie”比例都超40%)——说明优化自然度不会影响“像不像某个说话人”,这点很关键。
06、总结&未来方向
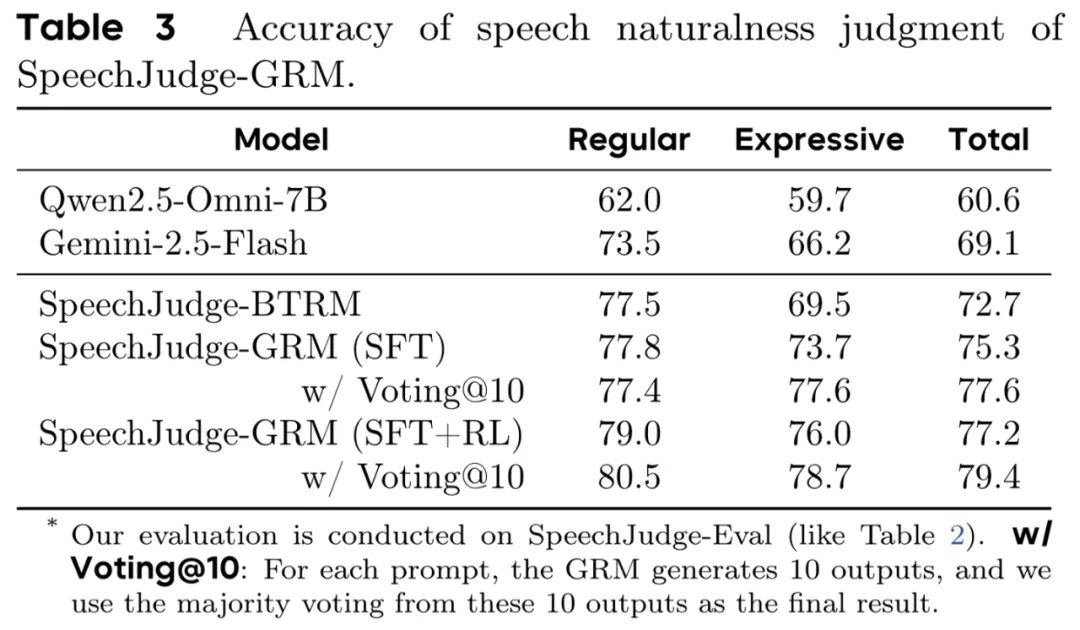
搞了99K大规模人类反馈数据集,覆盖全、质量高; 建了自然度判断基准,测出来现有方法都不行; 提出的GRM模型,用两阶段训练达到77.2%准确率(投票79.4%),还能落地优化TTS模型。
扩展到其他指标:比如说话人相似度、情感表达准不准; 搞多目标奖励:同时优化自然度、可懂度、相似度,不用顾此失彼。
