
 语音小管家
近年来,以思维链(Chain-of-Thought)为代表的扩展推理技术,在文本和视觉领域取得了巨大成功。然而,在音频领域,一个令人困惑的现象始终存在:音频语言模型似乎无法从思维链中受益,甚至表现出“想得越多,错得越多”的“反常缩放”现象。这不禁让我们提出一个根本性问题——音频智能真的无法进行深度、有效的推理吗?
近日,阶跃星辰发布Step-Audio-R1首个成功解锁音频领域深度推理能力的模型。通过模态锚定推理蒸馏框架(Modality-Grounded Reasoning Distillation,MGRD) ,Step-Audio-R1能够生成真正基于声学特征的推理链,而不是基于转录文本进行思考。实验证明,Step-Audio-R1在语音、环境音和音乐等多个维度的音频理解与推理基准测试中,超越Gemini 2.5 Pro,比肩Gemini 3 Pro。
GitHub:
Demo Page:
Paper:
Playground:https://huggingface.co/spaces/stepfun-ai/Step-Audio-R1
⏩音频推理的“怪象”:为何“想得越多,错得越多”?
思维链(CoT)技术已经成为大模型的标志性能力,它让语言模型能够通过一步步的推导,解决复杂的数学题、编写代码、进行逻辑演绎。然而,这一在文本和视觉领域屡试不爽的“法宝”,在音频领域却遭遇“水土不服”。
团队系统性地研究了现有音频语言模型的推理过程,发现了一个反常模式:这些模型所谓的“音频推理”,实际上是“文本替代推理”(textual surrogate reasoning)。当被要求分析音频内容时,模型倾向于从转录的文本或内容的文本描述出发进行推理,而非直接分析音频本身的声学属性。
举个例子:当分析一段音乐为何听起来悲伤时,现有模型可能会推理“因为歌词提到了伤心的事”,而不是分析其“小调和弦进行与下行的旋律线”。这种推理与音频特征的“割裂”,是导致性能下降的根本原因。究其根源,在于这些模型大多通过基于文本CoT数据的监督微调来初始化其推理能力,从而继承了文本的“思维惯性”。
⏩破局之道:Modality-Grounded Reasoning Distillation
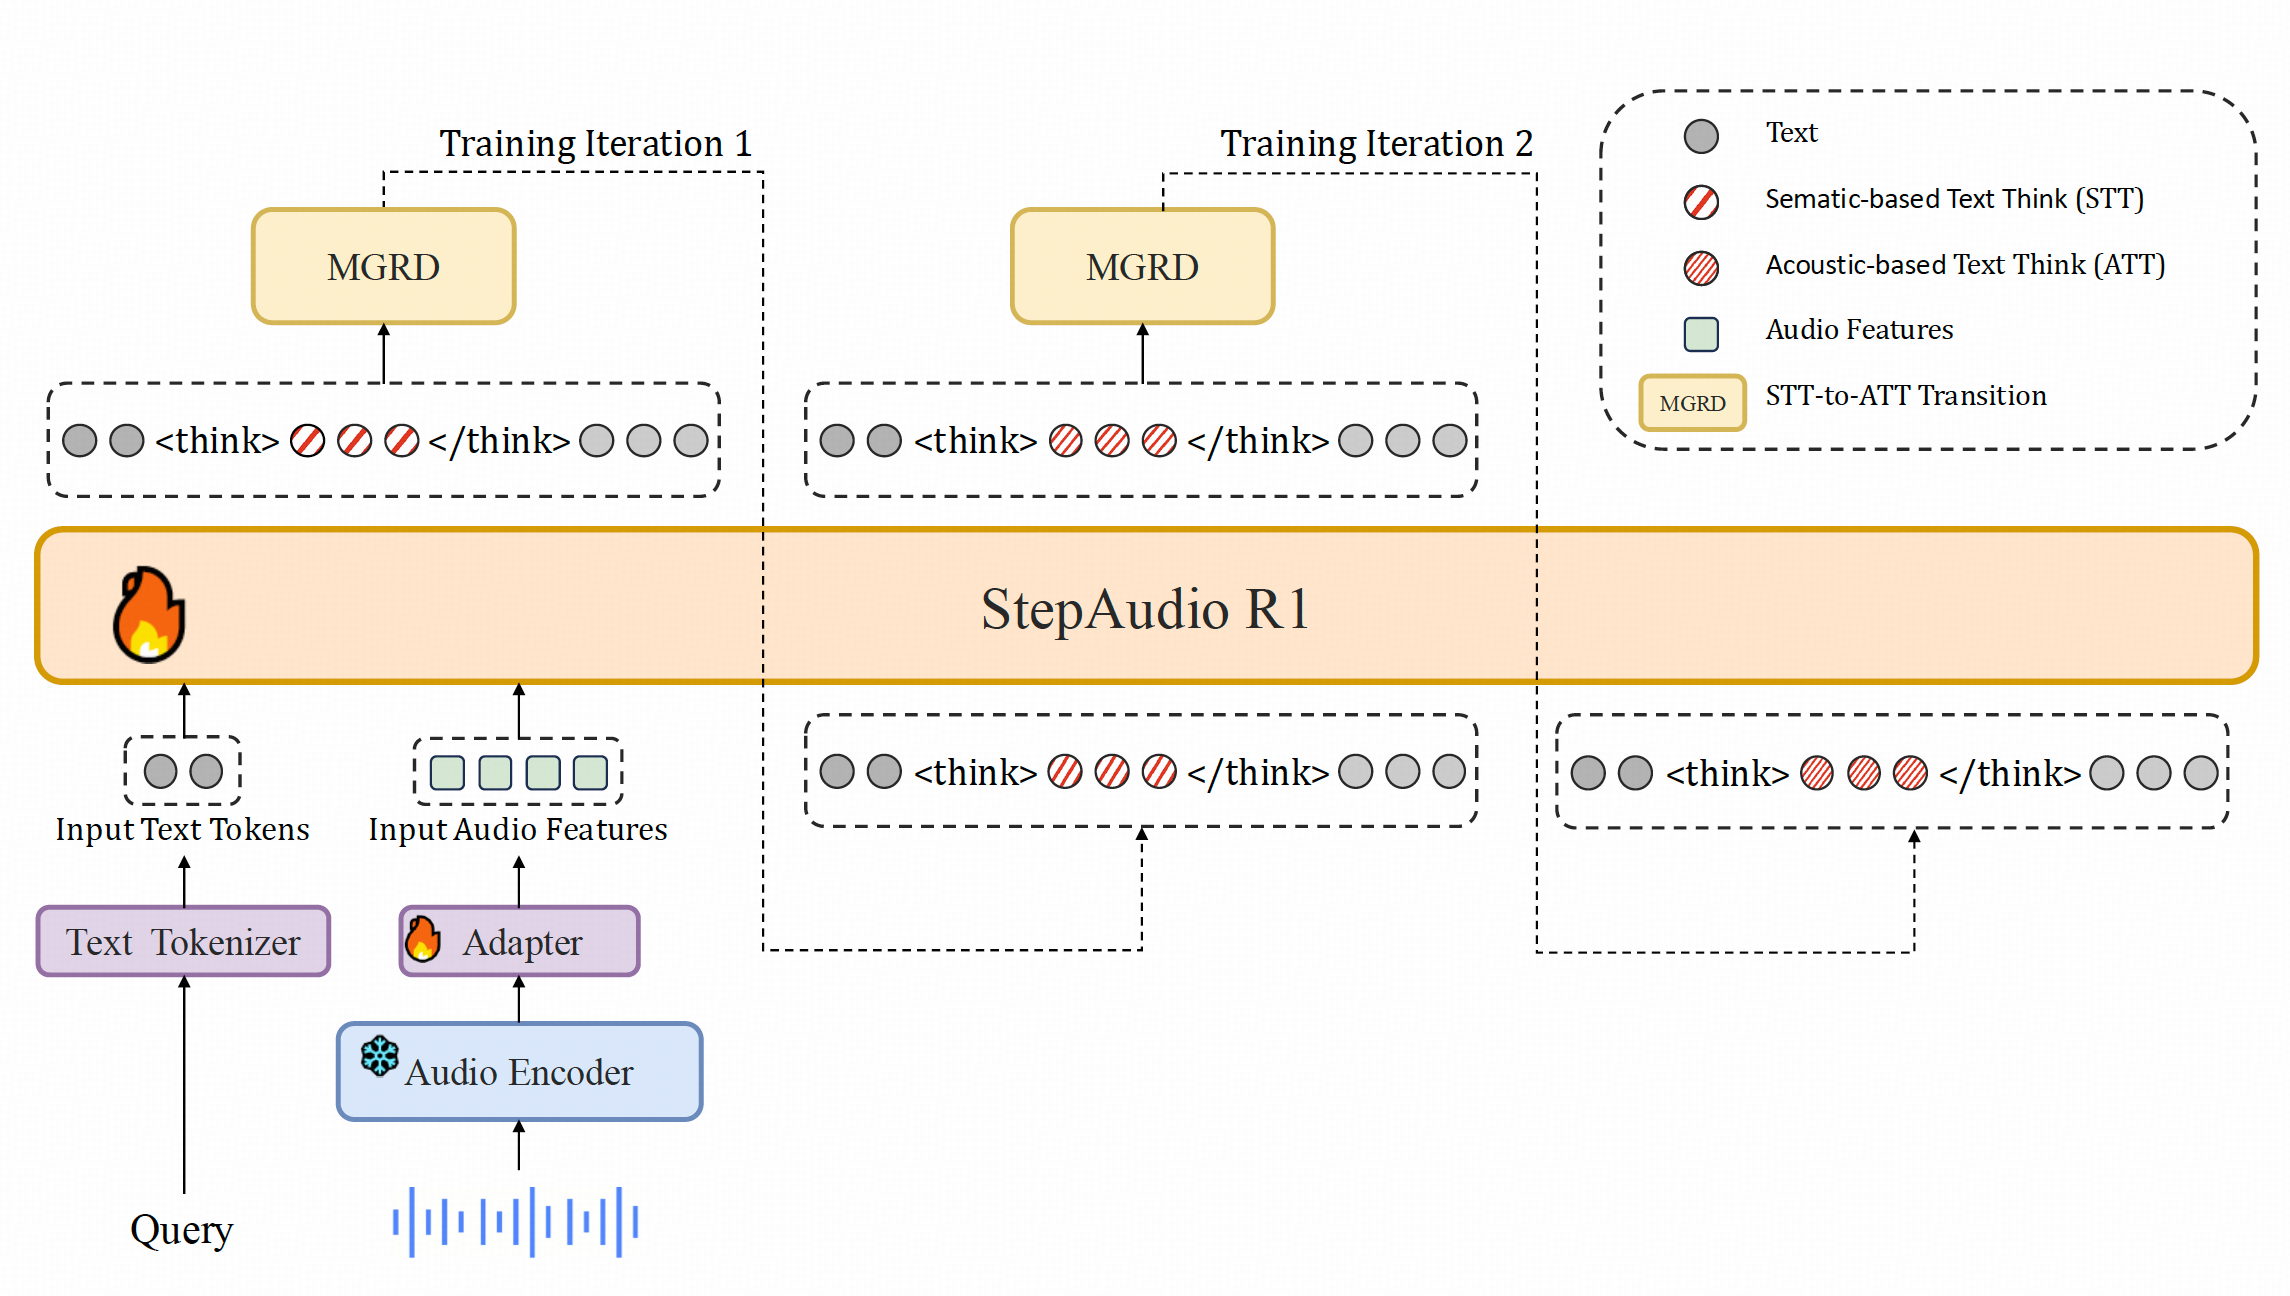
为了打破这一怪象,团队提出了MGRD框架,其核心思想是引导模型的推理过程,从依赖文本抽象,逐步转向直接基于声学属性。
MGRD框架通过一种迭代式的自蒸馏和精炼循环,实现这一转变:
感知驱动的数据筛选:挑选那些必须通过直接分析音色、音高、节奏等声学特征才能解答的音频问题。
思维链筛选:只保留那些明确引用了声学特征、逻辑连贯且答案正确的思维链,形成一个高质量的“声学思维”数据集。
监督微调:将新生成的声学推理数据与原始的文本推理数据结合,共同对模型进行微调,从而在强化声学推理能力的同时,保持其原有的文本推理水平。
强化学习:通过强化学习进一步优化模型,为生成正确且包含声学推理步骤的答案提供奖励,确保模型在追求准确性的同时,不会“偷懒”跳过推理过程。
迭代式自蒸馏:重复上述过程,在每一次迭代中,使用上一代的模型,不断强化音频原生思维。
通过这一系列精巧的设计,成功训练出了Step-Audio-R1,它真正学会了“用耳朵思考”。
⏩Step-Audio-R1架构概览
Step-Audio-R1的架构由三部分组成:一个音频编码器、一个音频适配器和一个大语言模型(LLM)解码器。
音频编码器:采用了在多种语音和音频任务上预训练的Qwen2音频编码器,并在训练中保持冻结。
音频适配器:通过一个降采样率为2的适配器,将音频编码器的输出与LLM解码器连接起来。
LLM解码器:基于强大的Qwen2.5 32B模型,它直接处理来自适配器的音频特征,并生成包含推理过程的文本输出。
整个模型的创新核心在于MGRD训练方法,它确保了LLM解码器在生成“思考过程”时,其依据是真实的声学信号,而非仅仅是文本转录。
⏩性能表现:全面超越,树立新标杆
团队在全面的语音转文本(Speech-to-Text)和语音转语音(Speech-to-Speech)基准测试中,对Step-Audio-R1进行了严格评估。
语音转文本(S2T)基准测试
在涵盖复杂逻辑推理(Big Bench Audio)、数学推理(Spoken MQA)、专家级音频理解(MMSU,MMAU)和对话语音(Wild Speech)的测试中,Step-Audio-R1取得了83.6%的平均分,超越Gemini 2.5 Pro在内等多个顶尖模型,展现了其卓越的深度音频理解能力。
语音转语音(S2S)基准测试
在实时对话场景中,模型的推理能力和响应速度至关重要。团队将Step-Audio-R1适配为实时版本(Step-Audio-R1 Realtime),在Big Bench Audio的S2S测试中,其语音推理性能得分高达96.1%,显著优于现有的闭源系统,如GPT Realtime和Gemini 2.5 Flash Native Audio Dialog。同时,它实现了0.92秒的首包延迟,达到了极具竞争力的实时交互水平。

⏩结论与展望
Step-Audio-R1不仅为音频智能领域带来了一个性能强大的新模型,更重要的是,它从根本上证实了:通过恰当的模态锚定,深度思考能力同样可以成为音频智能的核心。团队开创的MGRD框架,为解决多模态模型中普遍存在的“模态脱节”问题,提供了一个有效的解决思路。
