标题:《HPSU: A Benchmark for Human-Level Perception in Real-World Spoken Speech Understanding》

链接:https://arxiv.org/pdf/2511.23178

开源地址:https://github.com/Ichen12/HPSU-Benchmark

公开日期:2025年12月1号

作者单位:中山大学、腾讯

其他:论文已被AAAI2026接收

咱们先聊聊中山大学和腾讯合作的这篇论文核心:现在语音大模型(Speech LLMs)虽然在ASR(自动语音识别)、简单情感分类上还行,但要理解真实对话里藏着的意图、复杂情绪这些“人类级感知”能力,还差得远。现有基准要么只支持单语言,要么任务太粗(比如只分“开心/难过”),根本测不出真水平。所以作者团队就搞了个叫 HPSU 的基准,专门填补这个空白。

01、核心贡献(这仨点是真·创新,得重点说)

  • 搞了个超大规模的评估基准 :HPSU里有超过2万条中英双语样本,还都经过专家验证,覆盖了从“认说话人性别”到“猜潜台词”的16个细分任务,能全方面测模型的感知和推理能力。
  • 解决了标注难的问题 :设计了“多模态半自动化标注流程”,不用全靠人工,还顺便产出了 HPSC数据集 (5万+条中英语音-描述对)——这个数据集不光能给模型微调,还能用来做可控语音生成。
  • 测了13个主流模型,发现了关键差距 :包括11个开源模型(比如Qwen2.5-Omni、SALMONN)和2个闭源模型(Gemini 2.5 Pro/Flash),明确了现在模型和人类在“复杂推理”上的核心差距,给后续研究指了方向。

02、方法部分(怎么造的HPSU?实验前的准备很关键)
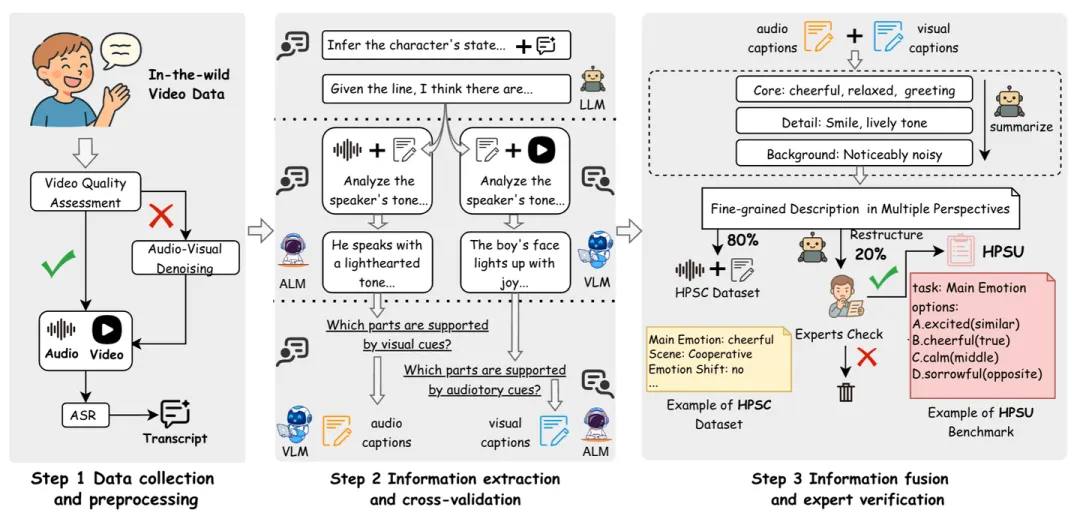
1. 三步搞定数据标注:从找数据到专家审核
作者怕数据质量不行、标注效率低,特意拆了3个步骤,每步都有细节:

第一步:找数据+预处理
数据来源很实在,都是真实场景的:比如CelebV-HQ(名人视频)、MELD(《老友记》对话片段)、MER(中文影视素材),还有VCTK(多口音英文音频)。 选数据时还卡了“音质门槛”:用DNSMOS评分,要求语音清晰度(SIG)≥3.5,背景噪音(BAK)≥2.0;音质差的样本,就用ClearerVoice-Studio降噪,保证听着清楚还不丢原语境。 最后每个样本都保留“视频+音频+文本转录”三模态,方便后续处理。
第二步:提信息+交叉验证
先让LLM分析文本转录,猜说话人的情绪、意图这些“先验信息”;再结合音频、视频模型提特征(比如音频里的语气、视频里的表情);还搞了“跨模态验证”——比如把视觉描述喂给音频模型,看两者说的是不是一致,确保信息没毛病。
第三步:融信息+专家拍板
用QWQ推理模型把信息整合成“三层描述”:核心层(比如“开心,想建议”)、细节层(比如“微笑,语气轻快”)、背景层(比如“环境有点吵”)。 然后分数据:80%做成HPSC数据集,剩下20%用Gemini 2.5 Pro转成“评估三元组”(比如“问题+选项+正确答案”),再让3个标注员审核——必须3人意见一致才能留下,最后通过率81.26%,保证HPSU的质量。
2. HPSU基准怎么设计?测的就是“人类会的能力”
基准分了2个认知层级、5个领域、16个任务,每个任务都针对性很强:
  • 基础感知:比如认年龄(选“成年/青少年”)、性别(男/女)、口音(美式/苏格兰式),还有简单的主情感识别(“担忧/感兴趣”)。
  • 复杂推理:这才是重点,比如“情感变化”(从平静到焦虑)、“语言和情绪矛盾”(嘴上说“开心”实际“失望”)、“猜潜台词”(比如反讽暗示情况不好),甚至还要推测“说话人的视觉行为”(比如“在哭/在大笑”)。
评估方式也做了丰富,不是只考选择题:
  • 客观题(单选/多选)、主观题(判断描述准不准)都有;
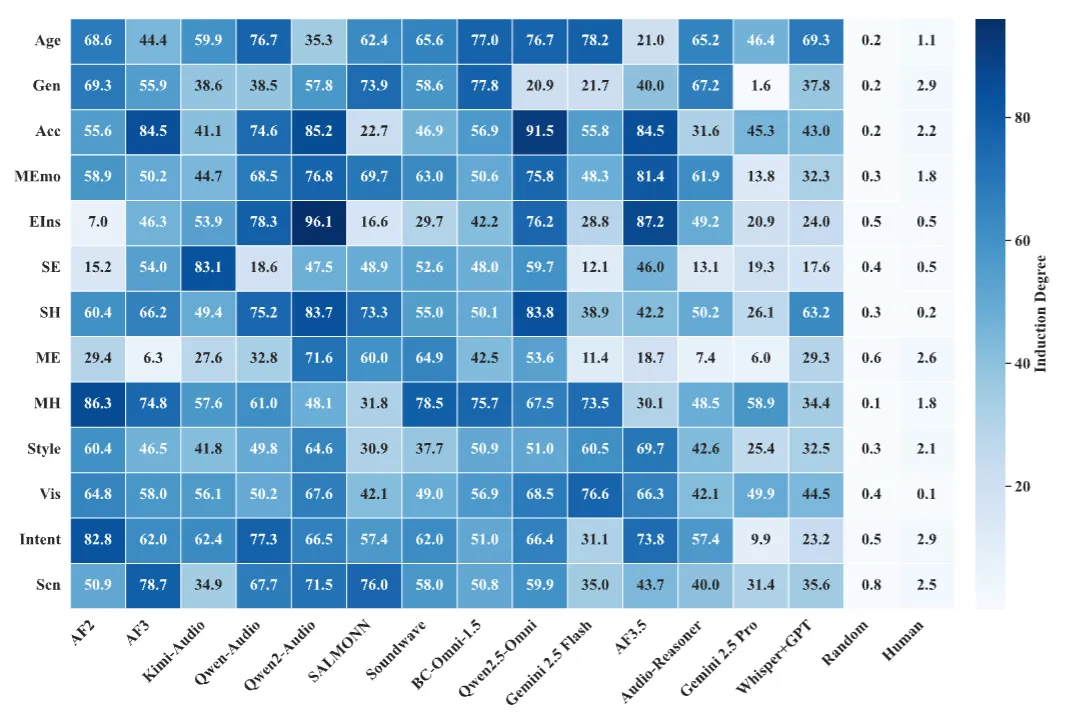
  • 还加了“对抗性提示”:每个任务给三种提示——标准的、带正确答案暗示的(正向泄露)、带错误引导的(负向误导),看模型会不会被带偏;
  • 评分超严格:用Gemini 2.5 Pro自动打分,单选必须和标准答案语义完全一致,多选错一个就0分,杜绝“蒙对一半”的情况。

03、实验过程(测了哪些模型?怎么测的?)

1. 实验对象和基线
  • 模型:13个主流语音LLM,比如闭源的Gemini 2.5 Pro/Flash,开源的Qwen2.5-Omni、Kimi-Audio-Instruct、Audio Flamingo系列等(GPT-4o因为安全政策不答题,没算进去)。
  • 基线:三个参照组,确保结果有对比性:
  • 人类基线:每种语言找10个大学生,每人做300道题,平均准确率87.3%(这是“天花板”);
  • 随机猜测:纯靠运气选答案,看 Chance 水平;
  • Whisper+GPT-4o:先让Whisper转写音频成文本,再让GPT-4o只看文本答题——测“光看文字能不能搞定”。
2. 还做了微调实验:HPSC数据集好不好用?
选了开源里表现最好的Qwen2.5-Omni,用HPSC数据集做微调(8张A100显卡,batch size 64,训2轮)。结果很明显:微调后中文任务准确率从56.7%涨到67.9%,英文从63.2%涨到74.4%;甚至在外部基准MMAR(另一个语音推理基准)上,准确率也从59.86%涨到64.28%——证明HPSC是真有用,不是“自嗨数据集”。

04、实验结果(重点来了!模型表现怎么样?差距在哪?)

1. 整体表现:模型离人类还很远

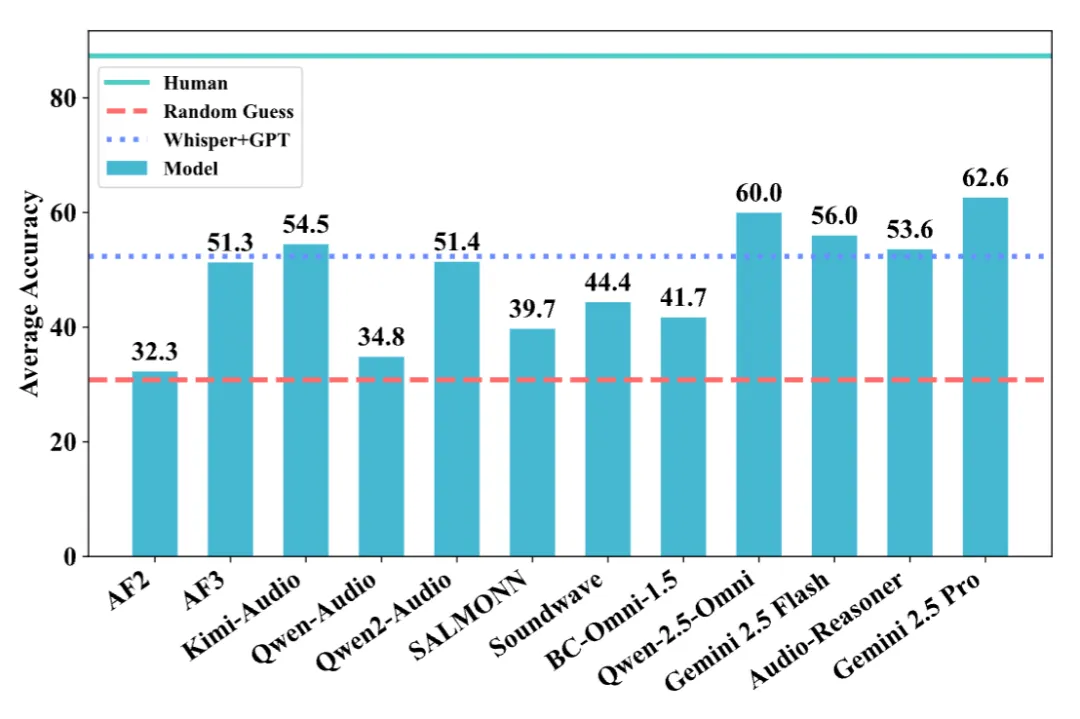
从 图2 (模型整体准确率图)能看出来:人类准确率87.3%,最牛的模型Gemini 2.5 Pro才62.6%,开源的Qwen2.5-Omni差一点(60.0%),比人类低了20多个百分点;Whisper+GPT-4o和其他开源模型更靠后,随机猜测就不用说了,垫底。这说明HPSU是真难,也证明现在模型的“人类级感知”还没达标。
2. 任务差异:基础任务行,复杂任务废

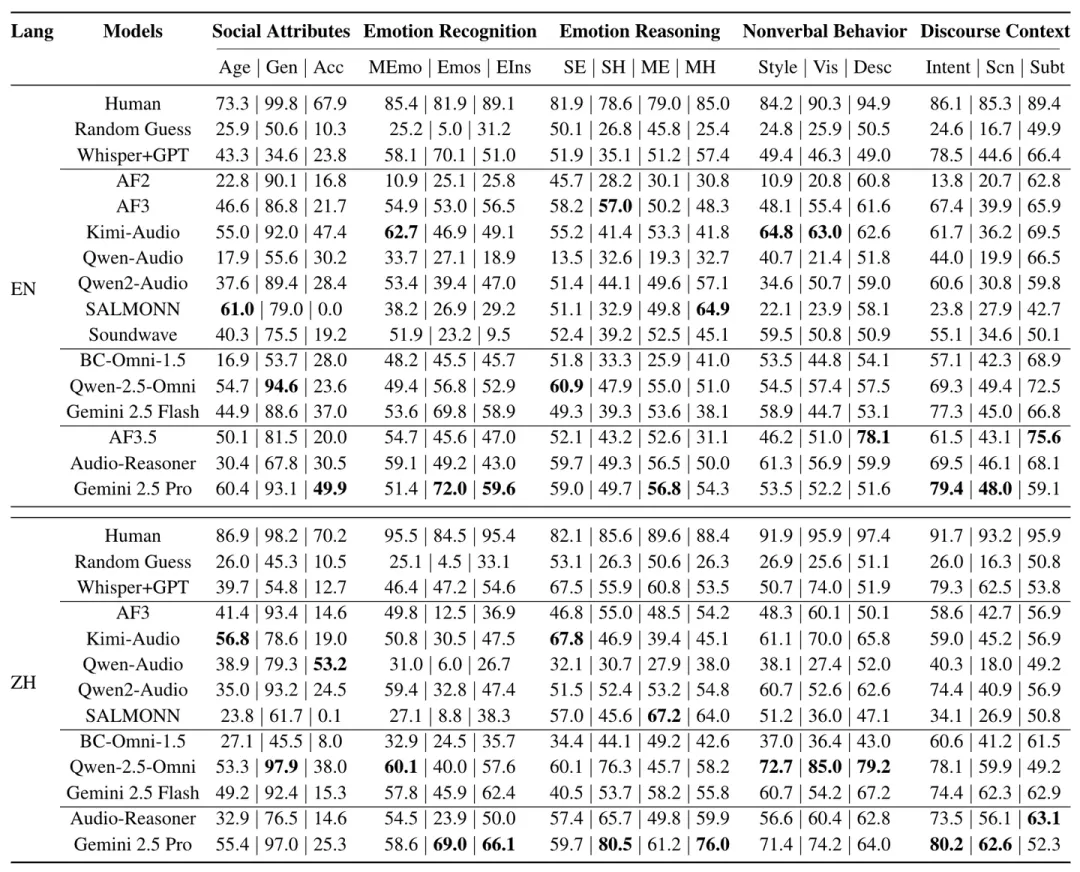
模型在“基础感知”上还凑活,比如性别识别准确率能超90%,接近人类;但到“复杂推理”就拉胯了:
  • 比如“情感复杂变化(SH)”、“潜台词理解(Subt)”,模型准确率不足50%,人类却能超85%;
  • 从 表4 (各模型任务准确率表)能更清楚看到:中文Subt任务里,人类准确率95.9%,Gemini 2.5 Pro才52.3%,差了40多个百分点;“对话场景判断(Scn)”人类85.3%(英文),模型最高才49.4%(Qwen2.5-Omni)。
3. 开源模型逆袭?闭源优势没那么大
有意思的是,开源的Qwen2.5-Omni和闭源的Gemini 2.5 Pro差距很小(才2.6个百分点),甚至在“英文简单情感变化(SE)”、“中文视觉行为推测(Vis)”上,Qwen2.5-Omni还比Gemini 2.5 Pro好。作者说这是因为“只要训练数据够多样,开源模型也能追上来”。
4. 级联方法不行:光看文字不够
Whisper+GPT-4o在“多情感识别(Emos)”、“意图判断(Intent)”上还能跟Gemini 2.5 Pro掰掰手腕,但一到“依赖声学细节”的任务(比如“描述准确性(Desc)”、“情感复杂变化(SH)”)就垮了——比如Desc任务,Whisper+GPT-4o准确率才49.0%,而Gemini 2.5 Pro能到51.6%(虽然也不高)。这说明“只转文字再推理”行不通,声学信息(比如语气、语速)根本不能丢。

05、关键发现:模型的3个大弱点

1. 训练数据偏科:基础任务练太多,高阶任务没数据
现在模型大多练的是ASR、简单情感分类这些“低阶任务”数据,而“潜台词”“情感动态”这些高阶任务的数据太少,导致模型不会推理。作者说这是“数据偏差”,也是HPSU要解决的核心问题——用基准量化差距,倒逼大家补高阶数据。
2. 模型太容易被“带偏”:对提示敏感得很

从 图4 (提示敏感性热图)能看出来:人类不管是标准提示、正向还是负向提示,准确率几乎没变化;但模型一碰到负向误导提示,准确率能掉20%-50%!尤其是“年龄识别(Age)”“口音识别(Acc)”“复杂情感矛盾(MH)”这些模糊任务,还有“视觉行为(Vis)”“场景判断(Scn)”这些开放任务,模型特别容易跟着错误提示走,根本没有人类的“判断力”。
3. 跨语言能力不行:中文比英文更难

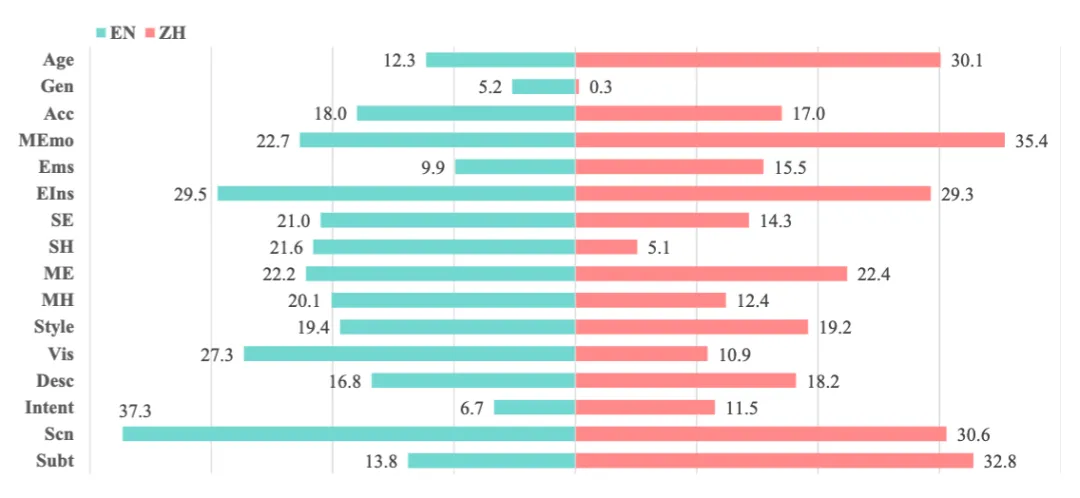
人类在中英任务上表现差不多,但模型在中文“潜台词(Subt)”“复杂情感矛盾(MH)”上,比英文差10%-15%。作者说因为中文表达更细腻(比如含蓄的反讽),模型没学好这部分。从 图3 (模型与人类差距图)也能看到:中文Subt任务,模型和人类差了37.3%,比英文的差距(27.3%)还大。

06、总 结

这篇论文的核心就是:造了个HPSU基准,把现在语音大模型的“短板”(复杂推理、抗干扰、中文细腻理解)全暴露出来了。创新点在于“全认知层级任务设计”“半自动化标注流程”“对抗性评估”,实验也做得扎实——测了13个模型,还验证了HPSC数据集的价值。
最后作者也说了,未来研究得补“高阶任务数据”,优化多模态融合架构,才能让语音模型真正达到“人类级感知”。对于做语音LLM的人来说,这个HPSU基准和HPSC数据集,绝对是有用的工具。